

10 Okt 2026
LifeSim Interiors: Dari Satu Foto ke Ruangan 3D yang Dapat Kamu Bongkar
Abstrak
Kami menyajikan LifeSim Interiors, sebuah sistem penelitian yang menghasilkan adegan 3D terurai dari satu gambar: sebuah lingkungan ditambah setiap objek sebagai mesh-nya sendiri, masing-masing di tempat yang tepat. Sistem ini memperluas TRELLIS.2 [1] untuk menghasilkan lingkungan dan hingga tiga puluh objek secara bersamaan, dalam satu bingkai bersama. Karena tidak ada dataset besar ruangan 3D yang terurai, kami membangun pipeline yang menghasilkan 5.500 aset dan menyusun 10.216 adegan pelatihan yang valid secara fisik. Pada adegan sintetis yang ditahan, F-score pada 10 cm meningkat dari 4,3% menjadi 26,8% seiring pertumbuhan pelatihan dari 250 menjadi 1.500 langkah, dan kurva tidak menunjukkan dataran tinggi.
1 Pendahuluan
Adegan 3D lebih dari sekadar permukaan. Ini adalah ruangan yang bisa kamu tata ulang, sofa yang bisa kamu pindahkan, rak yang bisa kamu ganti. Sistem yang memahami ruang harus memulihkan bagian-bagian tersebut, bukan hanya satu mesh beku.
LifeSim Interiors menghasilkan lingkungan ditambah setiap objek sebagai mesh-nya sendiri. Ini dibangun berdasarkan karya terbaru dalam distilasi objek-ke-adegan dan pada TRELLIS.2 [1] Microsoft. Kami membangun tumpukan penuh di sekitarnya dalam dua hari di Google Cloud. Kontribusi kami adalah:
- Pabrik dunia: teks menjadi gambar, gambar menjadi aset 3D, dan aset menjadi ruangan yang valid secara fisik, dalam skala besar (Bagian 2).
- Generator adegan: model objek 3D yang diperluas untuk menghasilkan lingkungan dan banyak objek secara bersamaan, dalam satu bingkai bersama (Bagian 3).
- Penyempurnaan objek: setiap objek dibuat ulang dalam bingkainya sendiri dengan detail yang lebih tinggi, dikondisikan pada sisa adegan (Bagian 3.3).
- Pengukuran: protokol benchmark publik, ditambah metode kami sendiri untuk menempatkan adegan yang dihasilkan dalam bingkai kamera nyata (Bagian 4).
2 Memproduksi dunia
Tidak ada dataset besar ruangan 3D yang dipecah menjadi bagian-bagian terpisah, jadi kami memproduksinya. Generator objek yang telah dilatih sebelumnya membuat bagian-bagiannya, dan pipeline kami merakitnya menjadi ruangan.
2.1 Dari kata-kata ke bagian-bagian
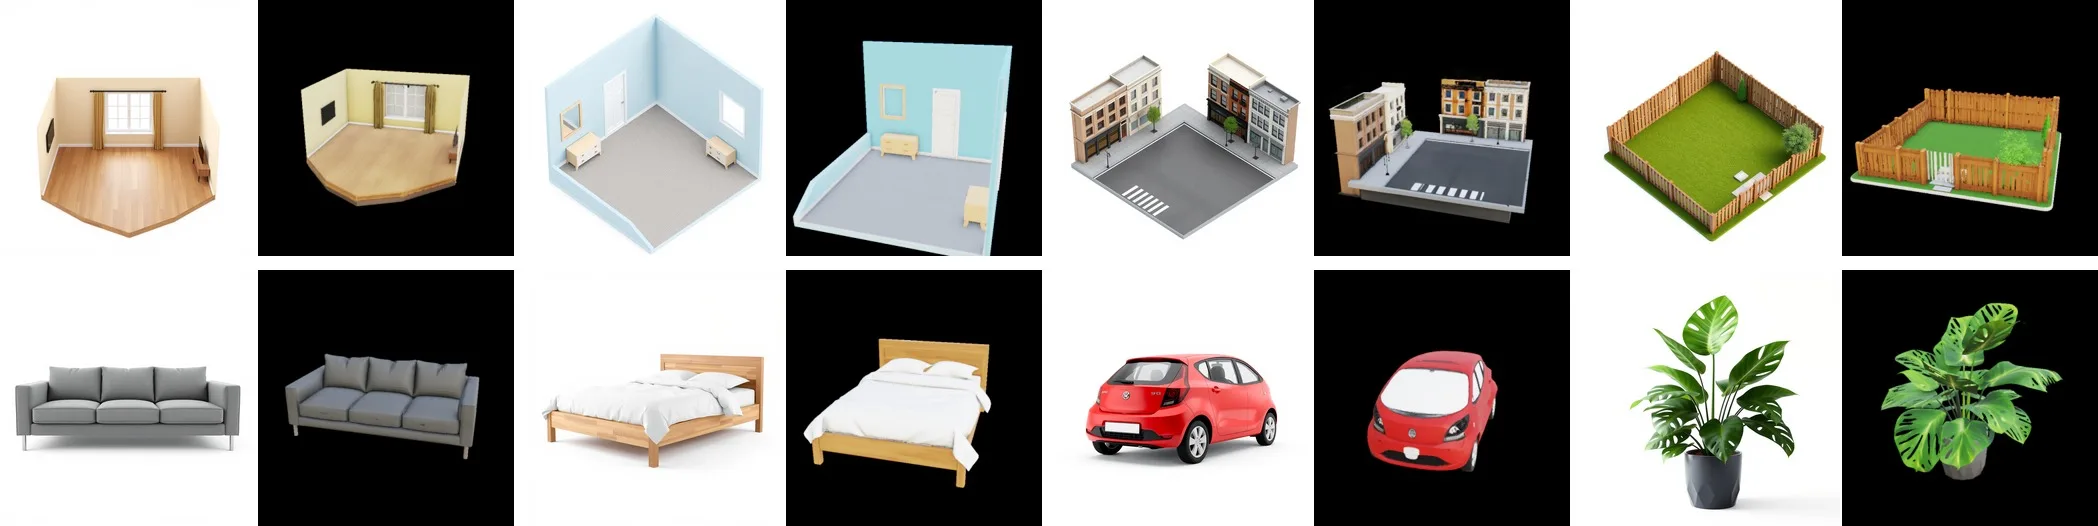
Setiap objek dan setiap ruangan dimulai sebagai deskripsi singkat. Model gambar menggambarnya, dan TRELLIS.2 mengangkat gambar tersebut menjadi aset 3D bertekstur (Gambar 1).
2.2 Aset tersulit adalah ruangan kosong
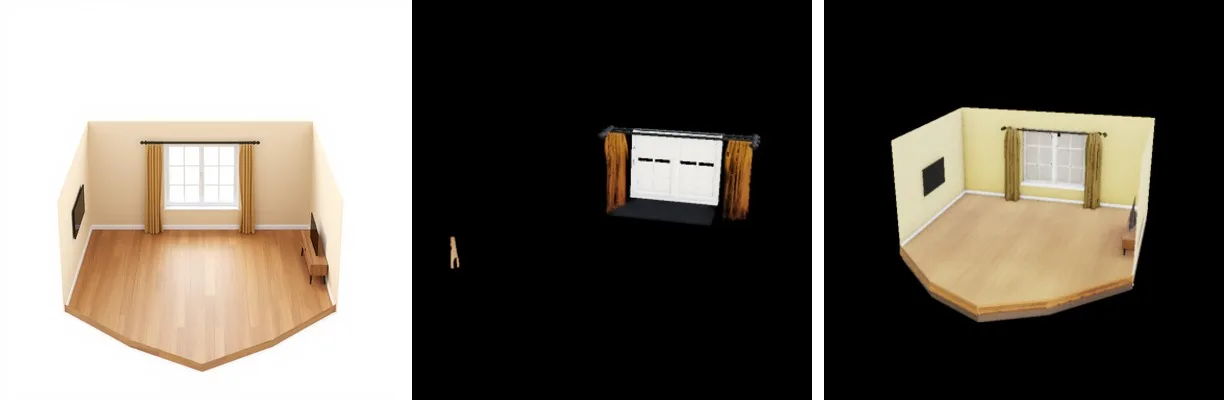
Ruangan kosong secara mengejutkan sulit untuk dihasilkan. Penghapusan latar belakang standar memperlakukan dinding dan lantai pucat sebagai latar belakang, jadi "ruang tamu kosong" pertama kami kembali sebagai jendela dan dua gorden. Masking lingkungan berdasarkan warna menjaga seluruh ruangan tetap utuh (Gambar 2).
2.3 Ruangan yang mematuhi fisika
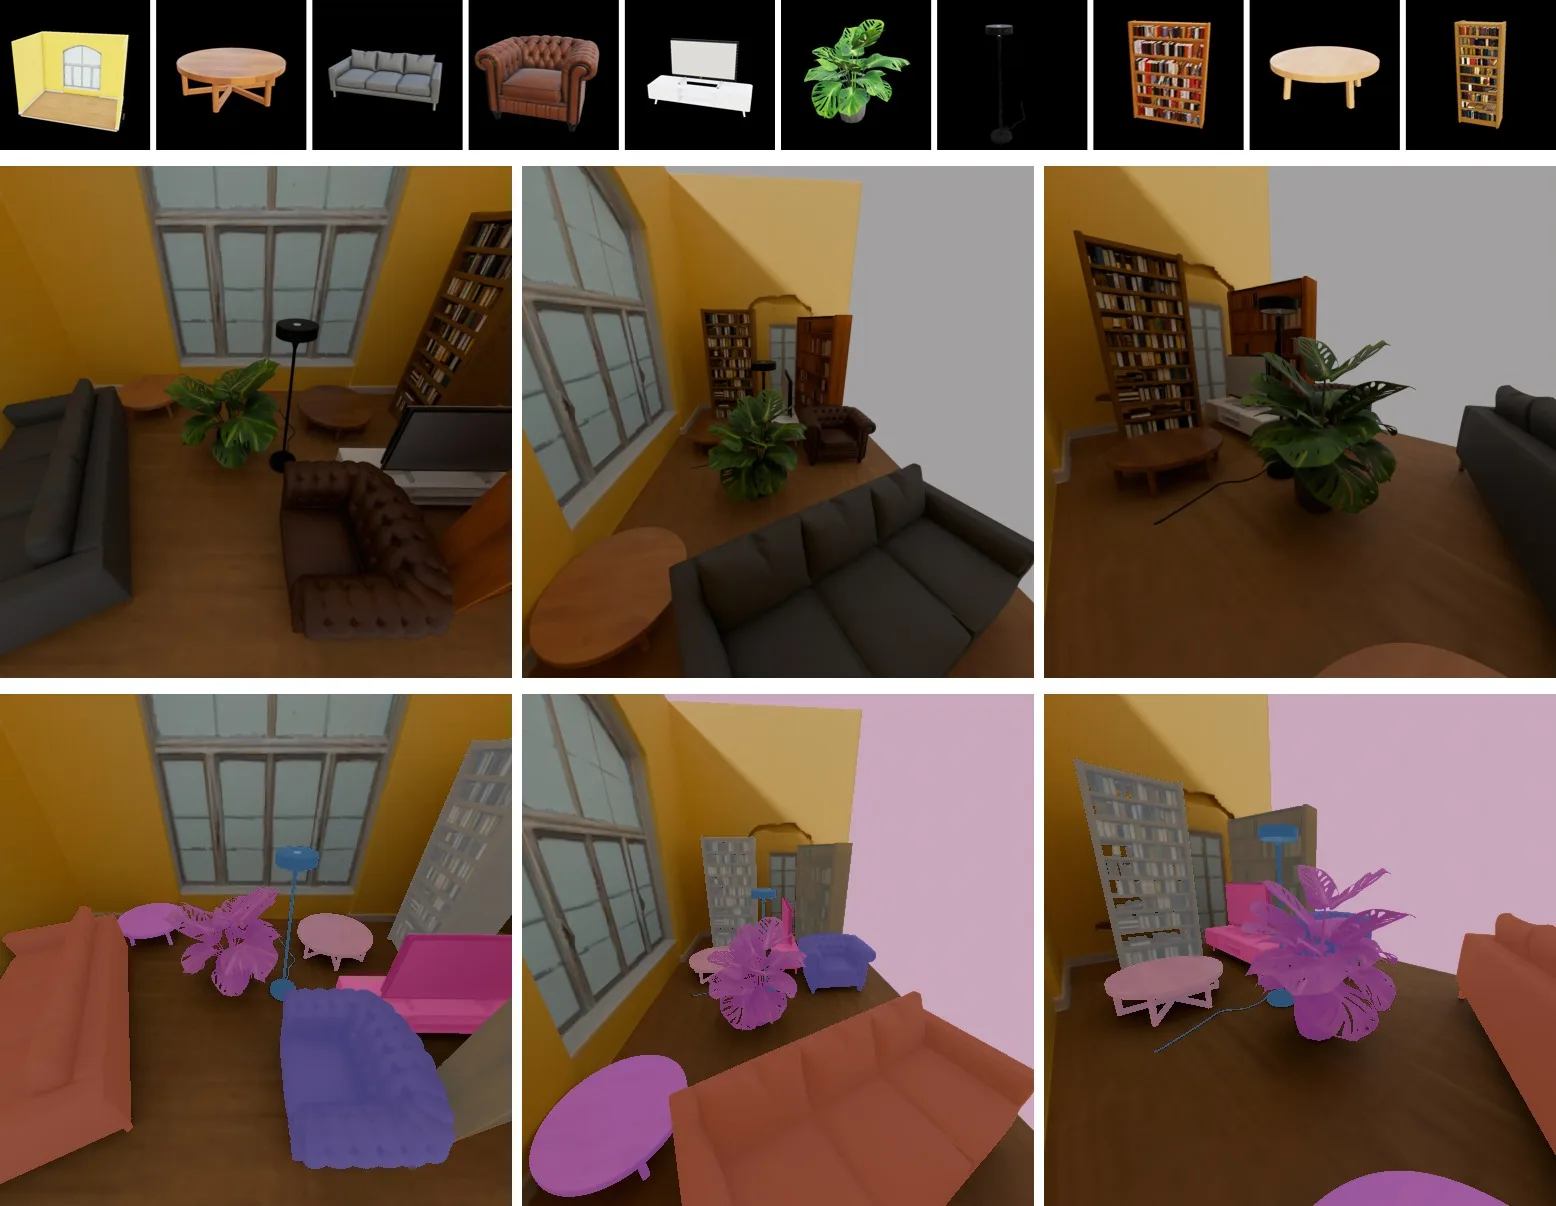
Setiap objek diletakkan di permukaan penyangga yang nyata. Apa pun yang mengambang atau melewati dinding ditolak, dan tabrakan diselesaikan. Kamera membidik area yang dilengkapi, dengan bidang pandang disesuaikan dengan setiap objek, dan hanya tampilan di mana setiap objek terlihat yang dipertahankan (Gambar 3).
2.4 Pada skala besar
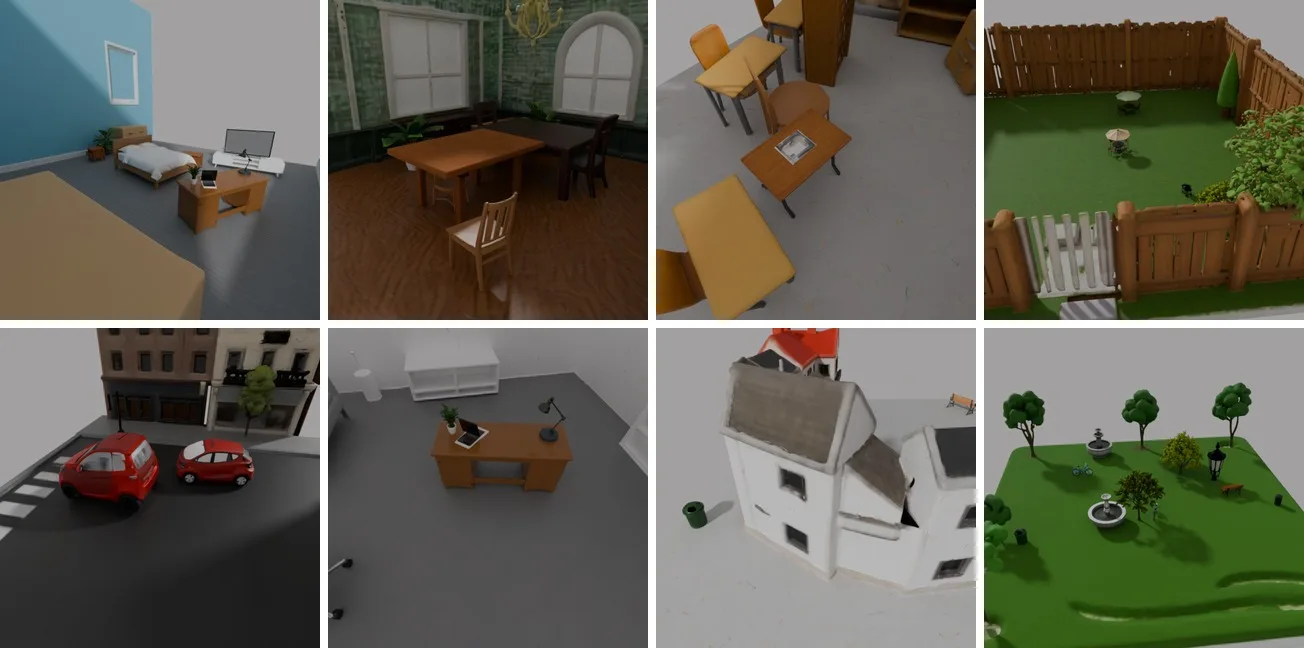
Dalam waktu kurang dari satu jam, pabrik menghasilkan 5.500 aset di 16 jenis ruangan dan 89 kategori objek. Dari sini, pabrik menyusun 10.216 adegan pelatihan, dengan sekitar enam objek masing-masing (Gambar 4).
Skala besar mengungkap masalah yang disembunyikan oleh pilot: model gambar sering mengabaikan “tanpa furnitur” dan tetap menggambar ruangan berfurnitur, yang mengajarkan kebalikan dari dekomposisi. Filter geometris kami melihat ke bawah setiap ruangan dan mengukur seberapa banyak lantai yang kosong. Filter ini mempertahankan 537 dari 1.493 lingkungan.
3 Menghasilkan adegan, bukan objek
3.1 Satu urutan untuk seluruh ruangan
Semua komponen adegan, satu lingkungan dan hingga tiga puluh objek, berbagi satu urutan token di atas generator 3D yang beku. Setiap objek dapat memperhatikan setiap objek lain dan ruangan di sekitarnya.
3.2 Memulai dari apa yang sudah diketahui model
Embeddings tipe dan slot yang dapat dipelajari membedakan lingkungan dari objek dan objek satu sama lain. Mereka dimulai dari nol, jadi pada langkah pelatihan pertama model berperilaku persis seperti model yang sudah dilatih sebelumnya. Hanya adaptor ringan yang dilatih.
3.3 Penyempurnaan dalam bingkai objek itu sendiri
Objek hanya menempati beberapa voksel dari kisi berukuran ruangan. Penyempurnaan memindahkan setiap objek ke dalam bingkai normalnya sendiri, meregenerasinya sambil memperhatikan seluruh adegan, dan menempatkannya kembali persis di tempat semula.
3.4 Arsitektur
- Model dasar. TRELLIS.2-4B [1], generator gambar-ke-3D voksel-jarang dengan transformer pencocokan aliran [3] untuk struktur, bentuk, dan tekstur.
- Adaptor. LoRA [2] pada peringkat 32 di setiap lapisan perhatian dan MLP: 37M parameter yang dapat dilatih pada tulang punggung yang beku.
- Perhatian terfaktorisasi. Perhatian padat pada adegan 30 komponen membutuhkan waktu 43 detik per langkah pelatihan. Dalam desain kami, lima dari tiga puluh lapisan memperhatikan seluruh adegan dan sisanya memperhatikan dalam setiap komponen, rezim di mana model dasar dilatih sebelumnya. Ini sekitar 3× lebih murah.
4 Hasil
4.1 Penyelarasan dengan kamera
Evaluasi dunia nyata membutuhkan prediksi dalam bingkai metrik kamera. Kami mendaftarkan adegan yang dihasilkan ke kedalaman yang terlihat dan menilai setiap pose kandidat berdasarkan konsistensi peta kedalaman. Tanpa ini, kesalahan skala 5% saja akan mengurangi 26 poin F-score.
4.2 Skala model
LifeSim Interiors meningkat dengan komputasi pelatihan. Pada adegan sintetis yang ditahan, F-score pada 10 cm (lebih tinggi lebih baik) meningkat di setiap titik pemeriksaan, memperoleh sekitar sembilan poin setiap kali pelatihan berlipat ganda (Tabel 1).
| Langkah pelatihan | 250 | 500 | 1,000 | 1,500 |
|---|---|---|---|---|
| F-score@0.1 | 4.3% | 11.6% | 21.3% | 26.8% |
Pipeline itu sendiri berfungsi dengan baik: mendekode latensi ground-truth dan menilainya sebagai prediksi memberikan F-score 100%. Model ini juga memiliki skor yang hampir sama pada adegan yang dilatihnya dengan adegan baru, jadi model ini masih kurang terlatih, bukan overfitting. Model ini telah melihat sebagian kecil dari komputasi pelatihan yang biasanya diberikan pada metode semacam ini.
5 Apa selanjutnya
Model sedang belajar; kami berhenti lebih awal. Tiga langkah selanjutnya adalah: melatih lebih lama, menyusun ruangan yang lebih realistis, dan menghasilkan lingkungan yang benar-benar kosong.
Kami sudah memiliki permulaan yang baik pada langkah kedua. Laboratorium teks-ke-interior kami menulis tata letak ruangan dengan LLM dan memeriksa setiap aset dengan model visi. Memasukkan ruangan-ruangan itu ke dalam pabrik dunia adalah eksperimen kami berikutnya.
Model di pusatnya ringkas. Sebagian besar pekerjaan nyata ada di sekitarnya: membuat dunia yang dapat dipercaya, merendernya secara efisien, dan mengukur hasilnya secara jujur terhadap dunia nyata. Kami akan berbagi lebih banyak saat LifeSim Interiors matang.
Referensi
- Xiang, J., Chen, X., Xu, S., Wang, R., Lv, Z., et al. Latensi Terstruktur Asli dan Kompak untuk Generasi 3D. arXiv:2512.14692, 2025.
- Hu, E. J., Shen, Y., Wallis, P., Allen-Zhu, Z., Li, Y., Wang, S., Wang, L., Chen, W. LoRA: Adaptasi Peringkat Rendah dari Model Bahasa Besar. arXiv:2106.09685, 2021.
- Lipman, Y., Chen, R. T. Q., Ben-Hamu, H., Nickel, M., Le, M. Pencocokan Aliran untuk Pemodelan Generatif. arXiv:2210.02747, 2022.
Kutipan
Harap kutip karya ini sebagai:
@misc{lifesim2026interiors,
  title  = {LifeSim Interiors: From One Photo to a 3D Room You Can Take Apart},
  author = {{João Nobre} and {Cris Lenta}},
  year   = {2026},
  month  = {oct},
  url    = {https://lifesim.com/research/interiors}
}