

10 de octubre de 2026
LifeSim Interiors: De una foto a una habitación 3D que puedes desarmar
Resumen
Presentamos LifeSim Interiors, un sistema de investigación que genera una escena 3D descompuesta a partir de una imagen: un entorno más cada objeto como su propia malla, cada uno en el lugar correcto. El sistema extiende TRELLIS.2 [1] para generar un entorno y hasta treinta objetos conjuntamente, en un marco compartido. Debido a que no existe un gran conjunto de datos de habitaciones 3D descompuestas, construimos un pipeline que produjo 5.500 activos y compuso 10.216 escenas de entrenamiento físicamente válidas. En escenas sintéticas retenidas, el F-score a 10 cm aumenta del 4,3% al 26,8% a medida que el entrenamiento crece de 250 a 1.500 pasos, y la curva no muestra una meseta.
1 Introducción
Una escena 3D es más que una superficie. Es una habitación que podrías reorganizar, un sofá que podrías mover, una estantería que podrías reemplazar. Un sistema que comprende el espacio tiene que recuperar esas partes, no solo una única malla congelada.
LifeSim Interiors genera un entorno más cada objeto como su propia malla. Se basa en trabajos recientes sobre destilación de objetos a escenas y en TRELLIS.2 [1] de Microsoft. Construimos la pila completa a su alrededor en dos días en Google Cloud. Nuestras contribuciones son:
- Una fábrica de mundos: el texto se convierte en imágenes, las imágenes en activos 3D y los activos en habitaciones físicamente válidas, a escala (Sección 2).
- Un generador de escenas: un modelo de objetos 3D extendido para generar un entorno y muchos objetos conjuntamente, en un marco compartido (Sección 3).
- Refinamiento de objetos: cada objeto se regenera en su propio marco con mayor detalle, condicionado al resto de la escena (Sección 3.3).
- Medición: un protocolo de evaluación comparativa público, además de nuestro propio método para colocar escenas generadas en el marco de una cámara real (Sección 4).
2 Fabricación de mundos
No existe un gran conjunto de datos de habitaciones 3D divididas en partes separadas, por lo que fabricamos uno. Un generador de objetos preentrenado crea las partes, y nuestro pipeline las ensambla en habitaciones.
2.1 De las palabras a las partes
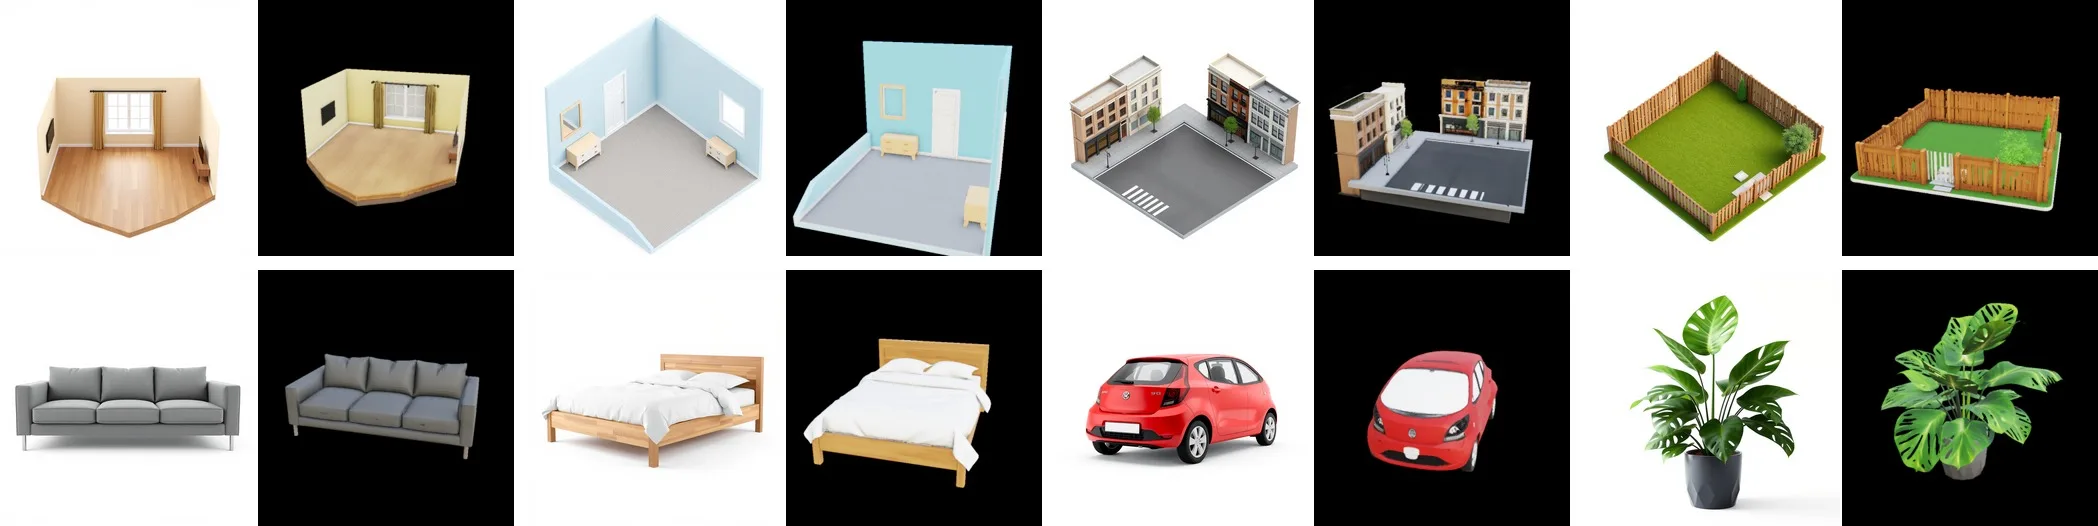
Cada objeto y cada habitación comienza como una breve descripción. Un modelo de imagen lo dibuja, y TRELLIS.2 eleva el dibujo a un activo 3D texturizado (Figura 1).
2.2 El activo más difícil es una habitación vacía
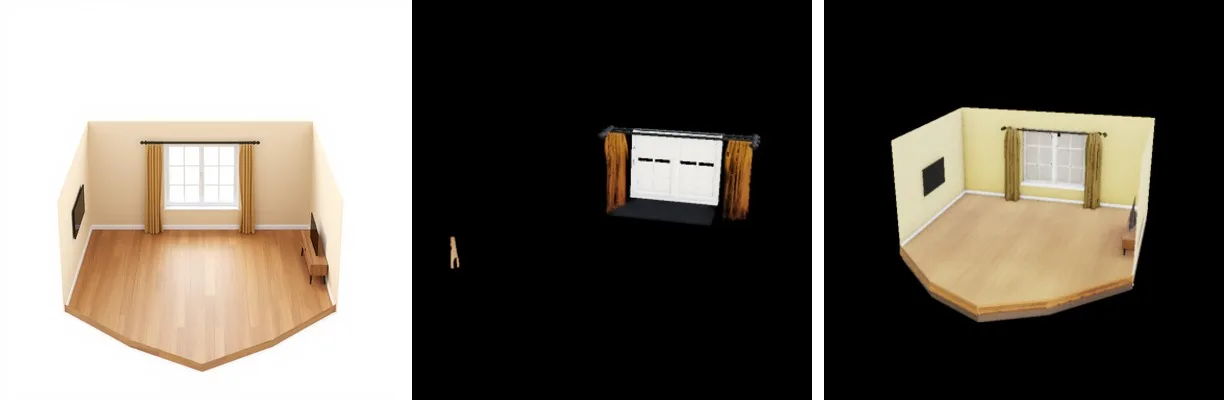
Una habitación vacía es sorprendentemente difícil de generar. La eliminación de fondo estándar trata las paredes y los suelos pálidos como fondo, por lo que nuestra primera “sala de estar vacía” volvió como una ventana y dos cortinas. El enmascaramiento de entornos por color mantiene toda la habitación intacta (Figura 2).
2.3 Habitaciones que obedecen a la física
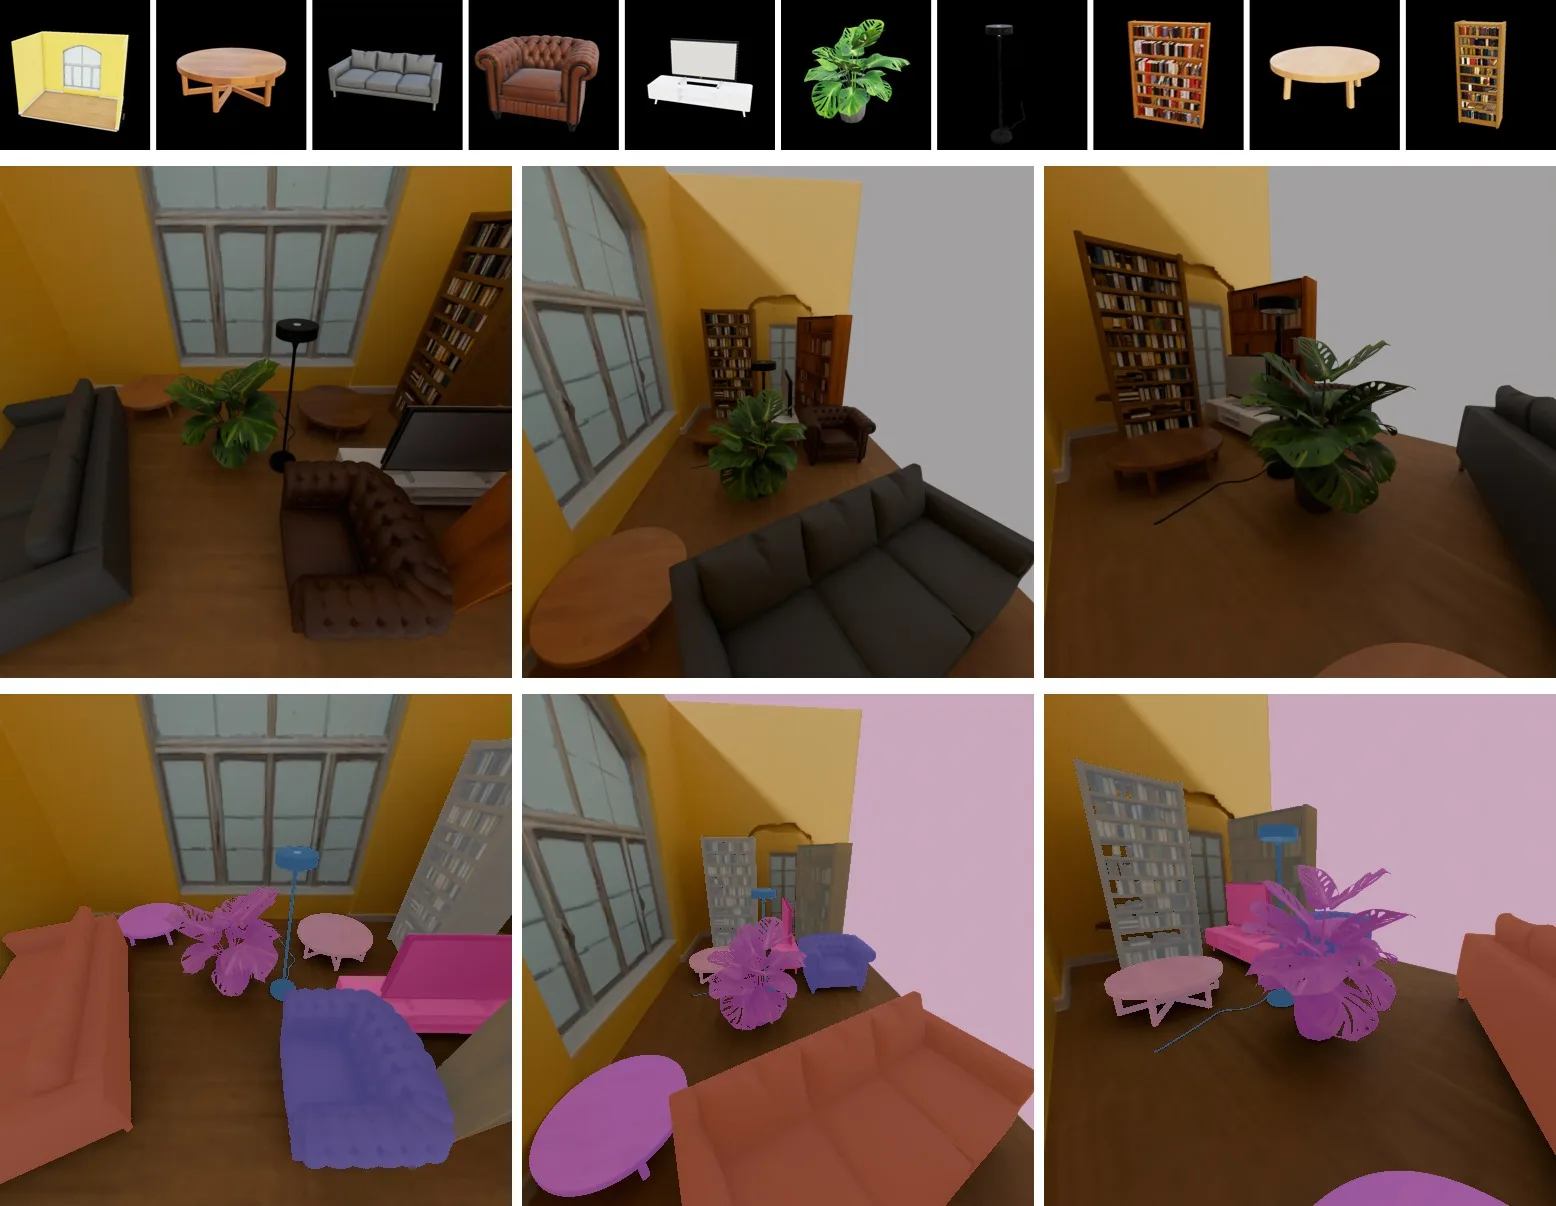
Cada objeto se deja caer sobre una superficie de soporte real. Se rechaza cualquier cosa que flote o atraviese una pared, y se resuelven las colisiones. Las cámaras apuntan a la región amueblada, con el campo de visión ajustado a cada objeto, y solo se mantienen las vistas en las que cada objeto es visible (Figura 3).
2.4 A escala
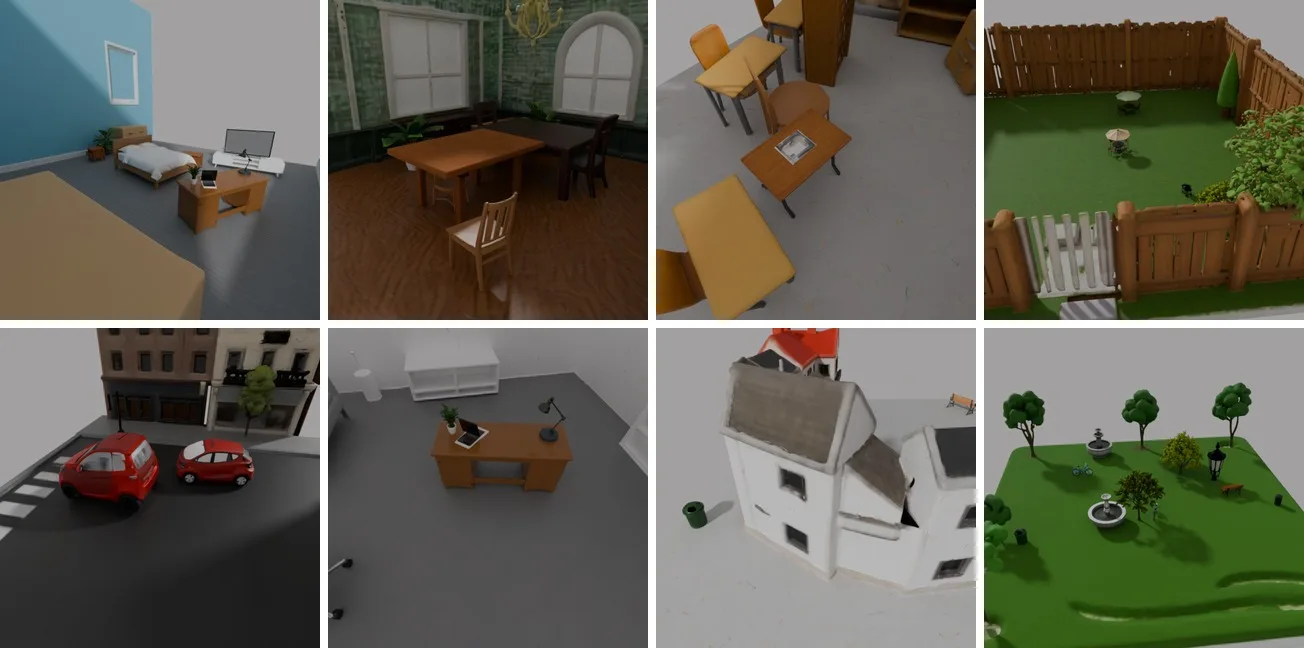
En menos de una hora, la fábrica produjo 5.500 activos en 16 tipos de habitaciones y 89 categorías de objetos. A partir de estos, compuso 10.216 escenas de entrenamiento, con aproximadamente seis objetos cada una (Figura 4).
La escala expuso un problema que el piloto había ocultado: los modelos de imagen a menudo ignoran “sin muebles” y dibujan habitaciones amuebladas de todos modos, lo que enseña lo contrario de la descomposición. Nuestro filtro geométrico mira hacia abajo en cada habitación y mide cuánto del suelo está libre. Mantuvo 537 de 1.493 entornos.
3 Generación de escenas, no de objetos
3.1 Una secuencia para toda la habitación
Todos los componentes de una escena, un entorno y hasta treinta objetos, comparten una única secuencia de tokens sobre un generador 3D congelado. Cada objeto puede atender a todos los demás objetos y a la habitación que lo rodea.
3.2 Partiendo de lo que el modelo ya sabe
Las incrustaciones de tipo y ranura aprendibles distinguen el entorno de los objetos y los objetos entre sí. Comienzan en cero, por lo que en el primer paso de entrenamiento el modelo se comporta exactamente como el preentrenado. Solo se entrenan adaptadores ligeros.
3.3 Refinamiento en el propio marco del objeto
Los objetos ocupan solo unos pocos vóxeles de una cuadrícula del tamaño de una habitación. El refinamiento mueve cada objeto a su propio marco normalizado, lo regenera mientras atiende a toda la escena y lo vuelve a colocar exactamente donde estaba.
3.4 Arquitectura
- Modelo base. TRELLIS.2-4B [1], un generador de imágenes a 3D de vóxeles dispersos con transformadores de coincidencia de flujo [3] para estructura, forma y textura.
- Adaptadores. LoRA [2] con rango 32 en cada capa de atención y MLP: 37M de parámetros entrenables en una base congelada.
- Atención factorizada. La atención densa sobre una escena de 30 componentes cuesta 43 segundos por paso de entrenamiento. En nuestro diseño, cinco de las treinta capas atienden a través de la escena y el resto atienden dentro de cada componente, el régimen en el que se preentrenó el modelo base. Esto es aproximadamente 3 veces más barato.
4 Resultados
4.1 Alineación con la cámara
La evaluación en el mundo real necesita predicciones en el marco métrico de la cámara. Registramos la escena generada con la profundidad visible y puntuamos cada pose candidata por la consistencia del mapa de profundidad. Sin esto, un error de escala del 5% por sí solo cuesta 26 puntos de F-score.
4.2 Escalado del modelo
LifeSim Interiors mejora con el cálculo de entrenamiento. En escenas sintéticas retenidas, el F-score a 10 cm (cuanto más alto, mejor) sube en cada punto de control, ganando aproximadamente nueve puntos cada vez que el entrenamiento se duplica (Tabla 1).
| Pasos de entrenamiento | 250 | 500 | 1,000 | 1,500 |
|---|---|---|---|---|
| F-score@0.1 | 4.3% | 11.6% | 21.3% | 26.8% |
El pipeline en sí es sólido: decodificar latentes de verdad y puntuarlos como predicciones da un F-score del 100%. El modelo también puntúa aproximadamente lo mismo en las escenas en las que se entrenó que en las nuevas, por lo que todavía está subentrenado, no sobreajustado. El modelo ha visto una pequeña fracción del cálculo de entrenamiento que se suele dar a este tipo de método.
5 Qué viene después
El modelo está aprendiendo; nos detuvimos temprano. Los siguientes tres pasos son: entrenar más tiempo, componer habitaciones más realistas y generar entornos verdaderamente vacíos.
Ya tenemos una ventaja en el segundo paso. Nuestro laboratorio de texto a interior escribe diseños de habitaciones con un LLM y verifica cada activo con un modelo de visión. Alimentar esas habitaciones a la fábrica de mundos es nuestro próximo experimento.
El modelo central es compacto. La mayor parte del trabajo real se desarrolla a su alrededor: fabricar mundos creíbles, renderizarlos de manera eficiente y medir los resultados honestamente contra el real. Compartiremos más a medida que LifeSim Interiors madure.
Referencias
- Xiang, J., Chen, X., Xu, S., Wang, R., Lv, Z., et al. Latentes estructurados nativos y compactos para la generación 3D. arXiv:2512.14692, 2025.
- Hu, E. J., Shen, Y., Wallis, P., Allen-Zhu, Z., Li, Y., Wang, S., Wang, L., Chen, W. LoRA: Adaptación de bajo rango de grandes modelos de lenguaje. arXiv:2106.09685, 2021.
- Lipman, Y., Chen, R. T. Q., Ben-Hamu, H., Nickel, M., Le, M. Coincidencia de flujo para modelado generativo. arXiv:2210.02747, 2022.
Cita
Por favor, cita este trabajo como:
@misc{lifesim2026interiors,
  title  = {LifeSim Interiors: From One Photo to a 3D Room You Can Take Apart},
  author = {{João Nobre} and {Cris Lenta}},
  year   = {2026},
  month  = {oct},
  url    = {https://lifesim.com/research/interiors}
}