

10 de out de 2026
LifeSim Interiors: De Uma Foto a Um Cômodo 3D Que Você Pode Desmontar
Resumo
Apresentamos LifeSim Interiors, um sistema de pesquisa que gera uma cena 3D decomposta a partir de uma imagem: um ambiente mais cada objeto como sua própria malha, cada um no lugar certo. O sistema estende o TRELLIS.2 [1] para gerar um ambiente e até trinta objetos em conjunto, em um único quadro compartilhado. Como não existe um grande conjunto de dados de salas 3D decompostas, construímos um pipeline que produziu 5.500 ativos e compôs 10.216 cenas de treinamento fisicamente válidas. Em cenas sintéticas retidas, o F-score a 10 cm aumenta de 4,3% para 26,8% à medida que o treinamento cresce de 250 para 1.500 etapas, e a curva não mostra platô.
1 Introdução
Uma cena 3D é mais do que uma superfície. É um cômodo que você poderia reorganizar, um sofá que você poderia mover, uma prateleira que você poderia substituir. Um sistema que entende o espaço tem que recuperar essas partes, não apenas uma única malha congelada.
LifeSim Interiors gera um ambiente mais cada objeto como sua própria malha. Ele se baseia em trabalhos recentes em destilação de objeto para cena e no TRELLIS.2 [1] da Microsoft. Construímos a pilha completa em torno dele em dois dias no Google Cloud. Nossas contribuições são:
- Uma fábrica de mundos: texto se torna imagens, imagens se tornam ativos 3D e ativos se tornam cômodos fisicamente válidos, em escala (Seção 2).
- Um gerador de cenas: um modelo de objeto 3D estendido para gerar um ambiente e muitos objetos em conjunto, em um único quadro compartilhado (Seção 3).
- Refinamento de objetos: cada objeto é regenerado em seu próprio quadro com maior detalhe, condicionado ao resto da cena (Seção 3.3).
- Medição: um protocolo de benchmark público, mais nosso próprio método para colocar cenas geradas no quadro de uma câmera real (Seção 4).
2 Fabricando mundos
Não há um grande conjunto de dados de salas 3D divididas em partes separadas, então fabricamos um. Um gerador de objetos pré-treinado faz as partes, e nosso pipeline as monta em salas.
2.1 De palavras a partes
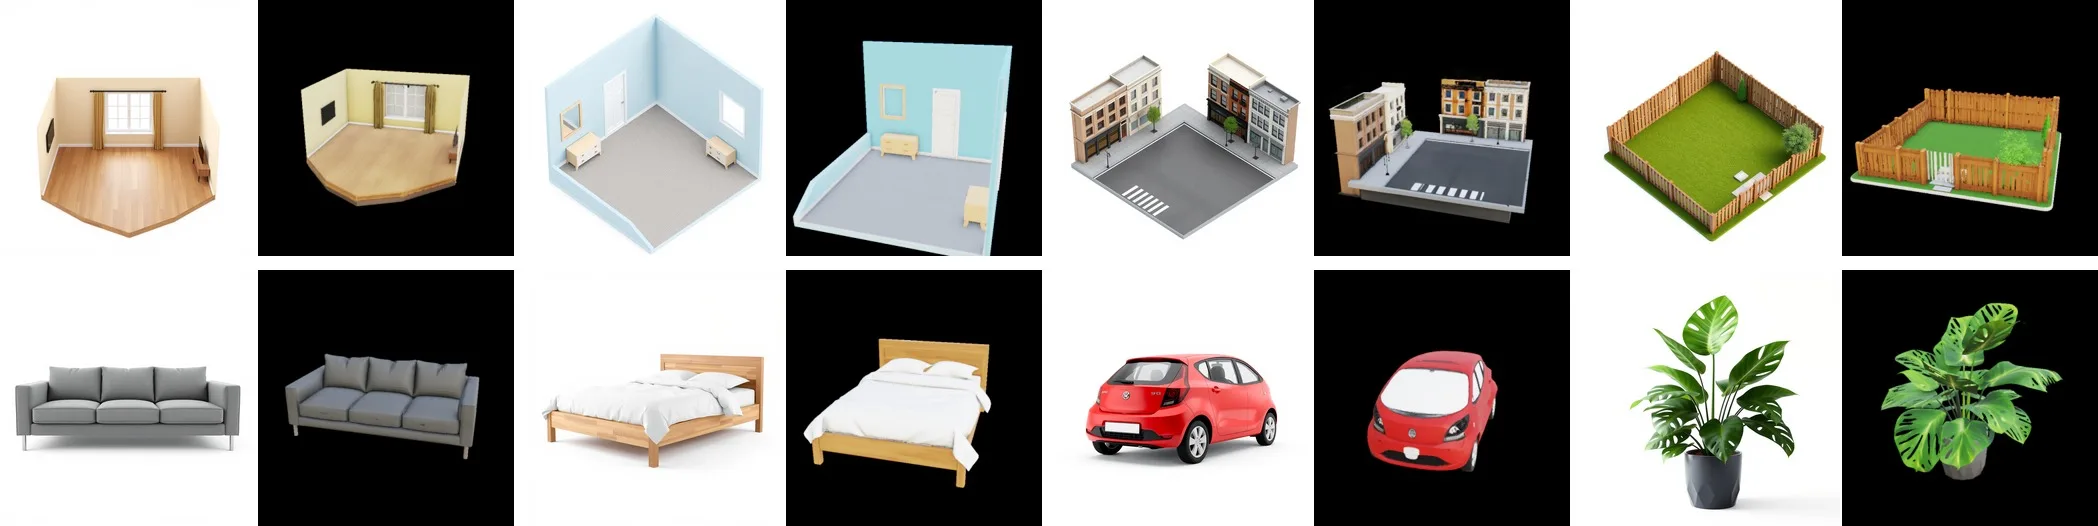
Cada objeto e cada cômodo começa como uma breve descrição. Um modelo de imagem o desenha, e o TRELLIS.2 eleva o desenho a um ativo 3D texturizado (Figura 1).
2.2 O ativo mais difícil é um cômodo vazio
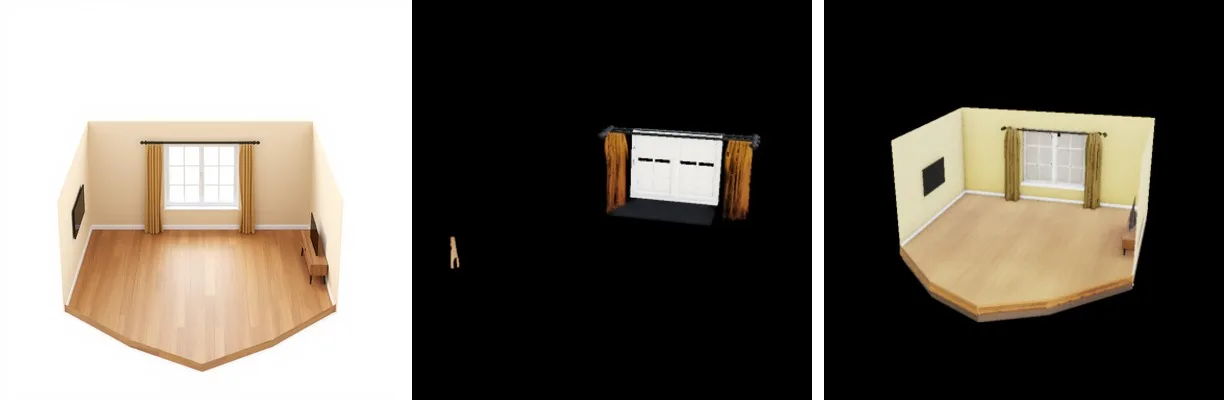
Um cômodo vazio é surpreendentemente difícil de gerar. A remoção de fundo padrão trata paredes e pisos claros como fundo, então nossa primeira “sala de estar vazia” voltou como uma janela e duas cortinas. Mascarar ambientes por cor mantém o cômodo inteiro intacto (Figura 2).
2.3 Cômodos que obedecem à física
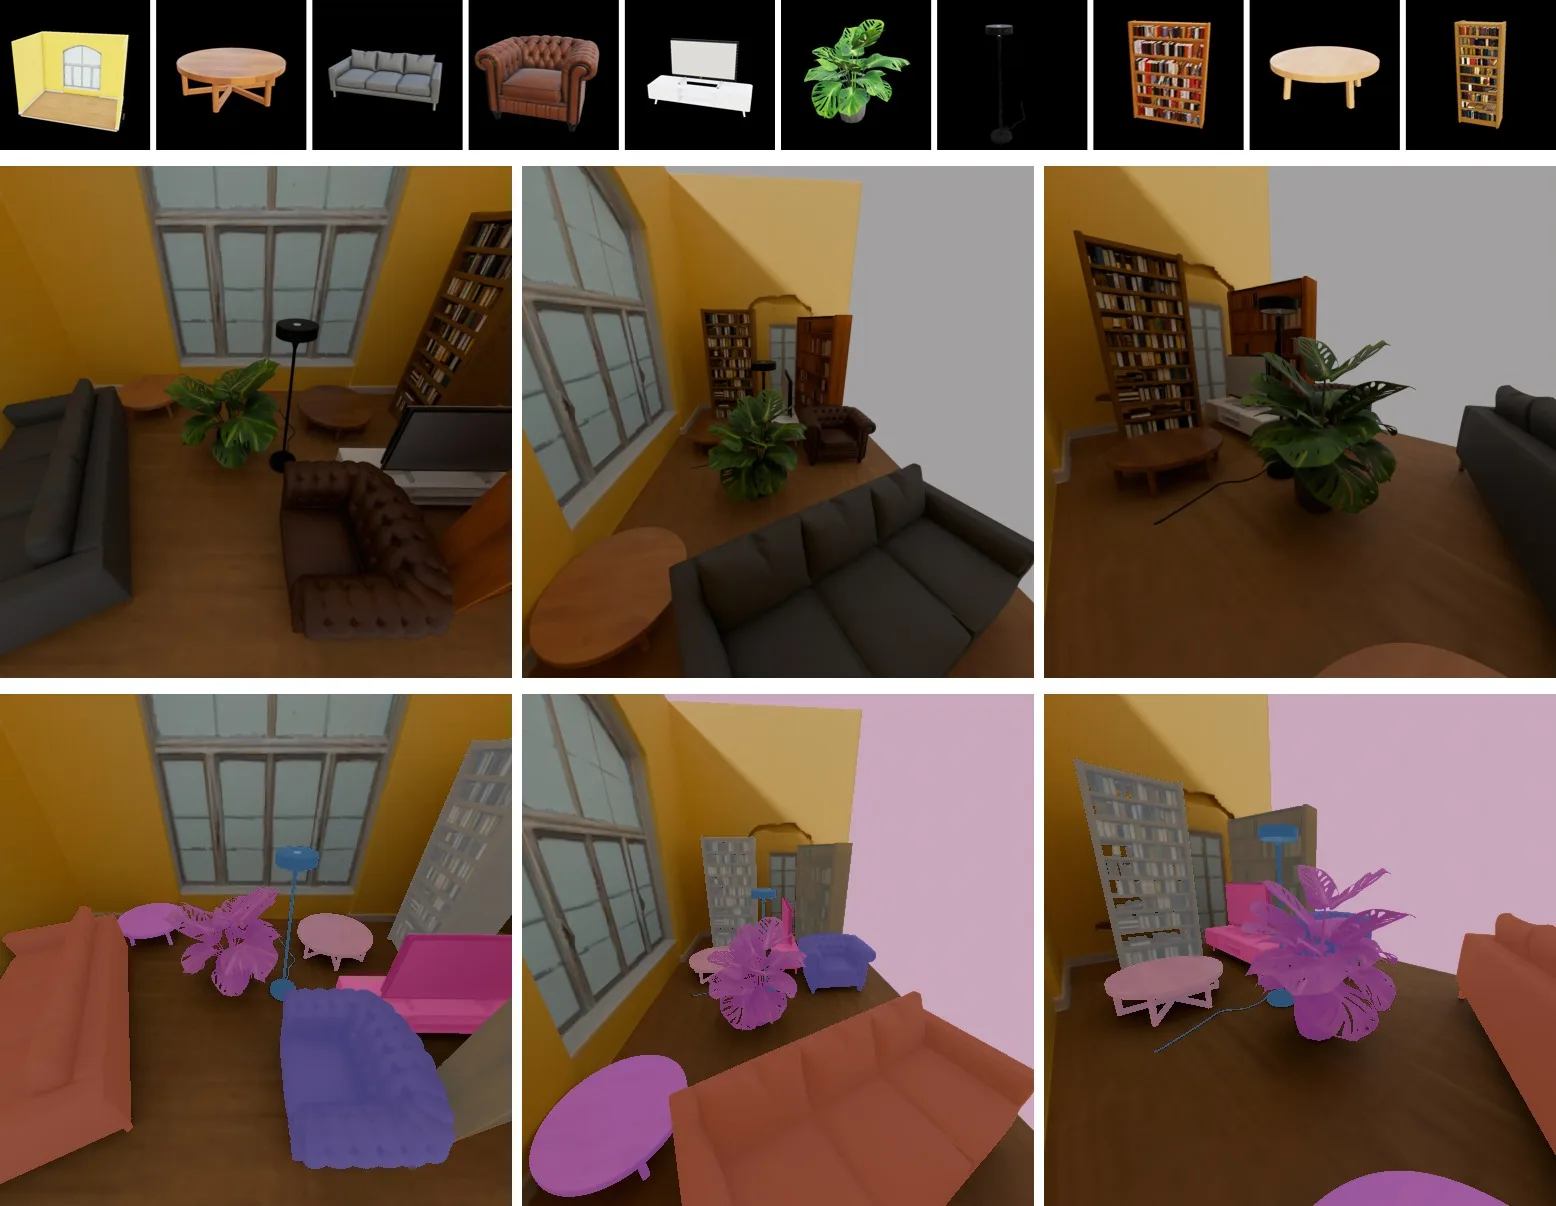
Cada objeto é colocado em uma superfície de suporte real. Qualquer coisa que flutue ou passe por uma parede é rejeitada, e as colisões são resolvidas. As câmeras apontam para a região mobiliada, com o campo de visão ajustado a cada objeto, e apenas as vistas em que todos os objetos são visíveis são mantidas (Figura 3).
2.4 Em escala
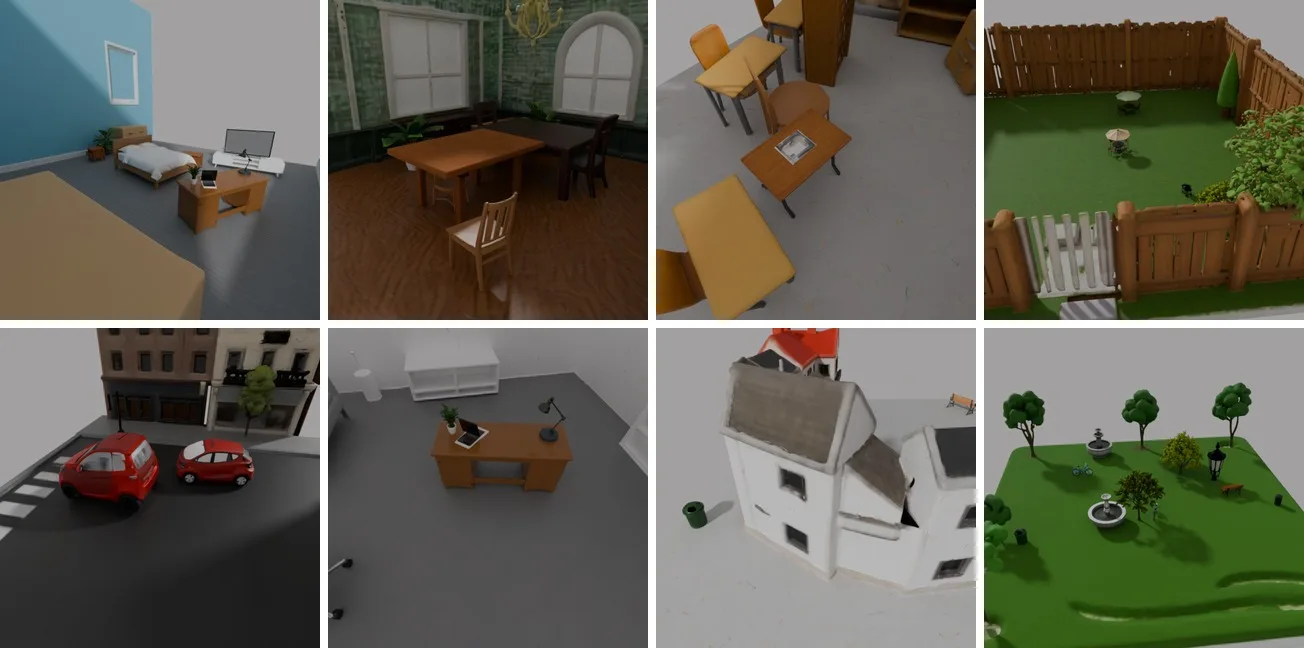
Em menos de uma hora, a fábrica produziu 5.500 ativos em 16 tipos de cômodos e 89 categorias de objetos. A partir destes, ela compôs 10.216 cenas de treinamento, com cerca de seis objetos cada (Figura 4).
A escala expôs um problema que o piloto havia escondido: modelos de imagem frequentemente ignoram “sem mobília” e desenham cômodos mobiliados de qualquer forma, o que ensina o oposto da decomposição. Nosso filtro geométrico olha para cada cômodo de cima e mede quanto do chão está livre. Ele manteve 537 de 1.493 ambientes.
3 Gerando cenas, não objetos
3.1 Uma sequência para o cômodo inteiro
Todos os componentes de uma cena, um ambiente e até trinta objetos, compartilham uma única sequência de tokens sobre um gerador 3D congelado. Cada objeto pode se referir a todos os outros objetos e ao cômodo ao seu redor.
3.2 Partindo do que o modelo já sabe
Embeddings de tipo e slot aprendíveis distinguem o ambiente dos objetos e os objetos uns dos outros. Eles começam do zero, então no primeiro passo de treinamento o modelo se comporta exatamente como o pré-treinado. Apenas adaptadores leves são treinados.
3.3 Refinamento no próprio quadro do objeto
Objetos ocupam apenas alguns voxels de uma grade do tamanho de um cômodo. O refinamento move cada objeto para seu próprio quadro normalizado, o regenera enquanto se refere a toda a cena e o coloca de volta exatamente onde estava.
3.4 Arquitetura
- Modelo base. TRELLIS.2-4B [1], um gerador esparso de imagem para 3D com transformadores de correspondência de fluxo [3] para estrutura, forma e textura.
- Adaptadores. LoRA [2] no rank 32 em cada camada de atenção e MLP: 37M parâmetros treináveis em um backbone congelado.
- Atenção fatorada. A atenção densa sobre uma cena de 30 componentes custa 43 segundos por etapa de treinamento. Em nosso projeto, cinco das trinta camadas se referem à cena e o restante se refere a cada componente, o regime em que o modelo base foi pré-treinado. Isso é cerca de 3× mais barato.
4 Resultados
4.1 Alinhamento com a câmera
A avaliação no mundo real requer previsões no quadro métrico da câmera. Registramos a cena gerada na profundidade visível e pontuamos cada pose candidata pela consistência do mapa de profundidade. Sem isso, um erro de escala de 5% sozinho custa 26 pontos de F-score.
4.2 Escala do modelo
LifeSim Interiors melhora com o poder computacional de treinamento. Em cenas sintéticas retidas, o F-score a 10 cm (quanto maior, melhor) sobe em cada checkpoint, ganhando cerca de nove pontos cada vez que o treinamento dobra (Tabela 1).
| Etapas de treinamento | 250 | 500 | 1,000 | 1,500 |
|---|---|---|---|---|
| F-score@0.1 | 4.3% | 11.6% | 21.3% | 26.8% |
O pipeline em si é sólido: decodificar latentes de verdade e pontuá-los como previsões resulta em um F-score de 100%. O modelo também pontua aproximadamente o mesmo em cenas em que foi treinado e em novas, então ainda está subtreinado, não superajustado. O modelo viu uma pequena fração do poder computacional de treinamento que esse tipo de método geralmente recebe.
5 O que vem a seguir
O modelo está aprendendo; paramos cedo. Três passos vêm a seguir: treinar por mais tempo, compor cômodos mais realistas e gerar ambientes verdadeiramente vazios.
Já temos uma vantagem no segundo passo. Nosso laboratório de texto para interior escreve layouts de cômodos com um LLM e verifica cada ativo com um modelo de visão. Alimentar esses cômodos na fábrica de mundos é nosso próximo experimento.
O modelo central é compacto. A maior parte do trabalho real está ao seu redor: fabricar mundos críveis, renderizá-los eficientemente e medir os resultados honestamente em relação ao real. Compartilharemos mais à medida que LifeSim Interiors amadurecer.
Referências
- Xiang, J., Chen, X., Xu, S., Wang, R., Lv, Z., et al. Latentes Estruturados Nativos e Compactos para Geração 3D. arXiv:2512.14692, 2025.
- Hu, E. J., Shen, Y., Wallis, P., Allen-Zhu, Z., Li, Y., Wang, S., Wang, L., Chen, W. LoRA: Adaptação de Baixo Rank de Grandes Modelos de Linguagem. arXiv:2106.09685, 2021.
- Lipman, Y., Chen, R. T. Q., Ben-Hamu, H., Nickel, M., Le, M. Correspondência de Fluxo para Modelagem Generativa. arXiv:2210.02747, 2022.
Citação
Por favor, cite este trabalho como:
@misc{lifesim2026interiors,
  title  = {LifeSim Interiors: From One Photo to a 3D Room You Can Take Apart},
  author = {{João Nobre} and {Cris Lenta}},
  year   = {2026},
  month  = {oct},
  url    = {https://lifesim.com/research/interiors}
}