

27 Okt 2026
Adam & Eve: 700 Otot yang Dikendalikan LLM melalui Model Keputusan yang Disetel dengan Baik
Abstrak
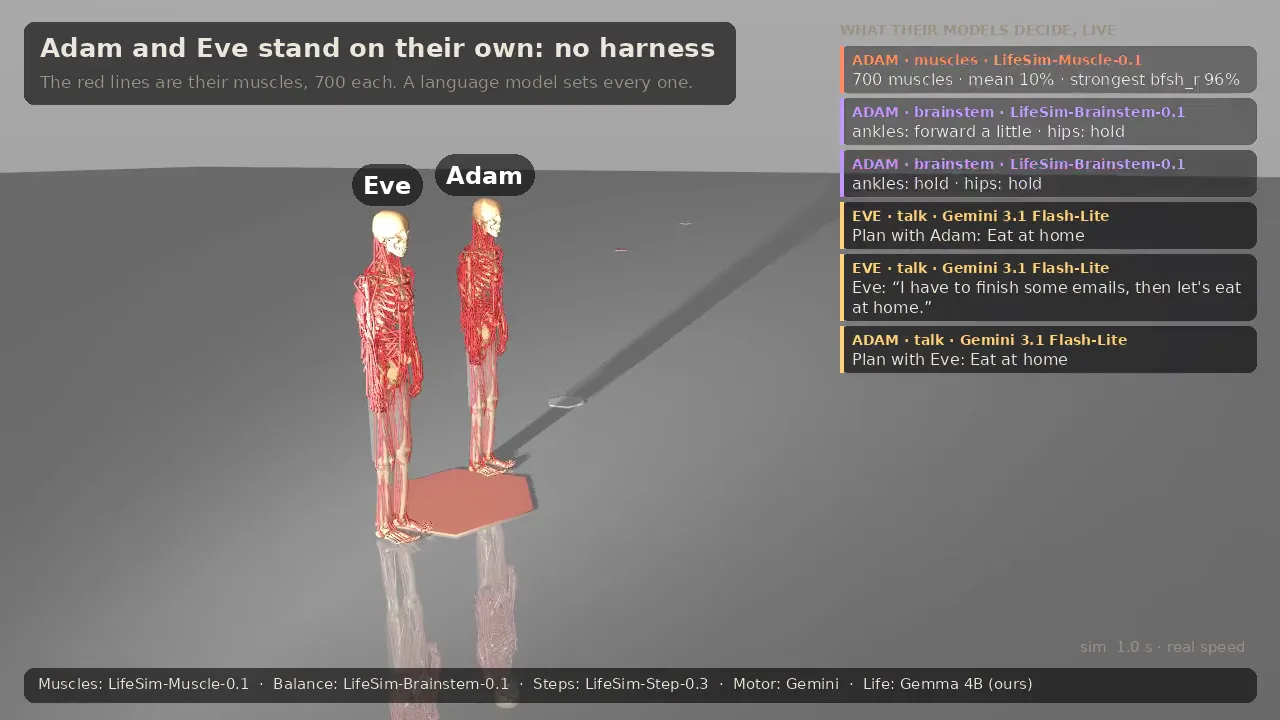
Adam dan Eve adalah dua manusia simulasi dengan masing-masing 700 otot, hidup bersama di Palace of Fine Arts di San Francisco. Model bahasa menjalankan setiap lapisan dari mereka yang dapat dijalankan oleh model bahasa: apa yang harus dilakukan sepanjang hari, ke mana harus berjalan, bagaimana menjaga keseimbangan, di mana setiap kaki mendarat, dan seberapa keras setiap otot menarik. Tiga dari model tersebut adalah milik kami sendiri: penyempurnaan 144M-parameter, dilatih pada CPU dalam 4 hingga 11 menit masing-masing, yang menyalin pengajar mereka dengan korelasi 0,958 hingga 0,9998 pada input yang belum pernah mereka lihat. Tanpa alat bantu, kedua tubuh berdiri melalui dorongan 80 N dan berjalan beberapa lusin langkah di antara jatuh. Ini adalah eksperimen, bukan produk. Kami melaporkan apa yang berhasil, apa yang tidak, dan angka-angkanya.
1 Sebuah eksperimen
Teknologi bergerak sangat cepat sehingga tidak ada yang tahu ke mana arah simulasi selanjutnya. Setahun yang lalu, model bahasa bisa melakukan percakapan. Hari ini, ia bisa merencanakan seminggu, menggunakan alat, dan berjalan selama berjam-jam. Kami tidak tahu di mana batasnya, jadi kami mencoba menemukannya.
Pertanyaannya sederhana: seberapa jauh model bahasa bisa turun? Orang-orang LifeSim sudah berpikir dengan model bahasa. Mereka memutuskan apa yang harus dilakukan, dengan siapa harus berbicara, dan ke mana harus pergi. Di bawah itu, setiap game menggunakan animasi. Tubuh yang berjalan adalah tubuh yang memutar rekaman.
Kami mengganti rekaman dengan tubuh. MS-Human-700 [1] adalah model terbuka dari sistem muskuloskeletal manusia dengan 700 otot, disimulasikan di MuJoCo [2]. Kami menempatkan dua di antaranya dalam satu adegan, di lantai yang terbuat dari peta nyata, dan memberikan setiap keputusan yang kami bisa kepada model bahasa. Kami tidak tahu apakah itu akan berdiri. Ternyata bisa.
2 Lapisan
Kami menyalin lapisan tubuh dan pikiran, dan memberikan setiap lapisan yang bisa menjadi model bahasa ke satu (Tabel 1). Hanya sumsum tulang belakang yang berupa kode: ia mengubah “condong sedikit ke belakang” atau “letakkan kaki di sini” menjadi 700 tarikan otot.
| Lapisan | Pada seseorang | Model | Seberapa sering |
|---|---|---|---|
| Kehidupan | Apa yang harus dilakukan sepanjang hari | Gemma 3 4B [3], disempurnakan oleh kami dengan GRPO [4] di LifeSim Week | Sekali per aktivitas, ~4 detik |
| Korteks motorik | “Jalan ke sana, kuatkan batang tubuh” | Gemini 3.1 Flash-Lite | Sekitar sekali per detik, ~1 detik |
| Batang otak | Menjaga kamu tetap tegak | LifeSim-Brainstem-0.1 (milik kami) | 2 pertanyaan per tick, berdiri |
| Keputusan langkah | Di mana kaki berikutnya mendarat | LifeSim-Step-0.3 (milik kami) | 2 pertanyaan per tick, berjalan |
| Sumsum tulang belakang | Kabel tetap | Kode | Setiap tick |
| Otot | Berkontraksi | LifeSim-Muscle-0.1 (milik kami) | 700 pertanyaan per tick, per orang |
Setiap lapisan berbicara dalam kata-kata. Batang otak membaca “beratnya 3 cm di depan tengah kaki, bergerak maju dengan kecepatan 4 cm/dtk” dan menjawab bagaimana cara condong. Setiap otot membaca garis daerah tubuhnya dari korteks motorik dan dorongan dari sumsum tulang belakang, dan menjawab seberapa keras harus berkontraksi.
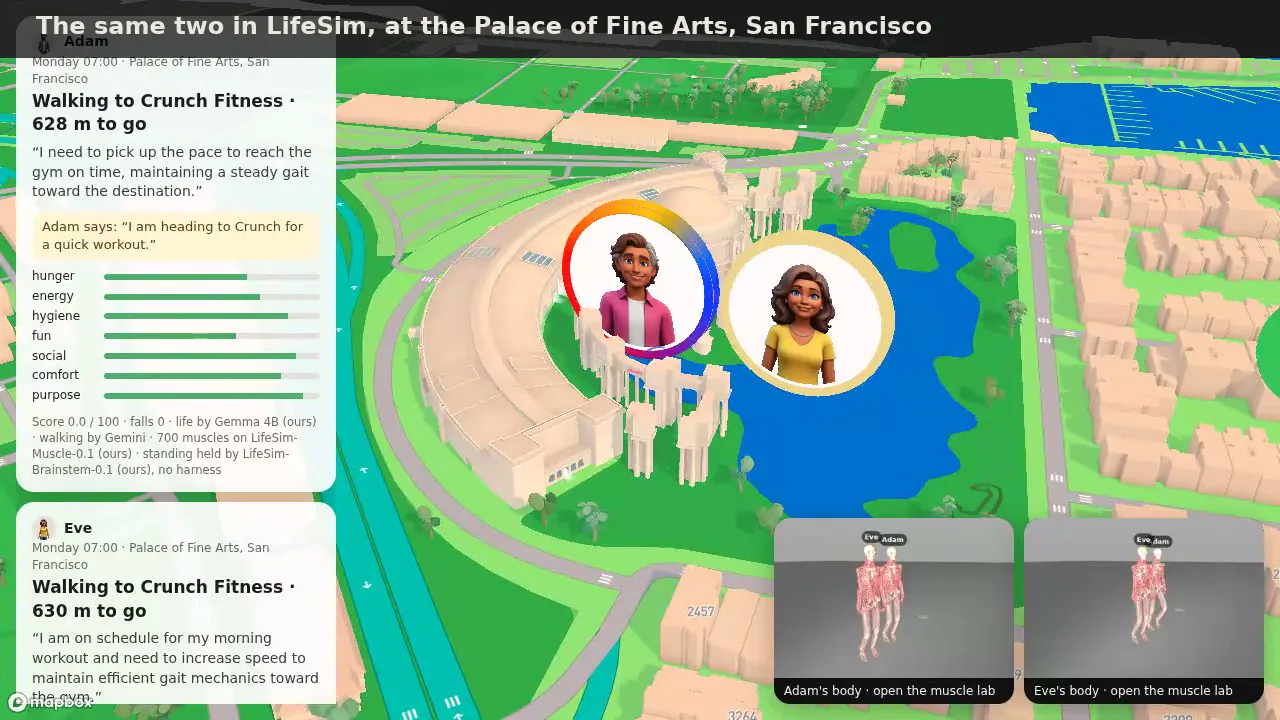
Adam dan Eve juga saling mengenal. Setiap model kehidupan membaca di mana pasangannya berada dan apa yang mereka lakukan. Ketika keduanya bertemu, Gemini menulis satu baris untuk masing-masing, dan mereka dapat menyepakati rencana: “mau makan malam di Kibatsu nanti?” (Gambar 3).
3 Tiga model kecil
Tiga lapisan terendah menjawab hingga 1.400 pertanyaan setiap 10 ms, jadi mereka membutuhkan model kecil. Kami menggunakan Julia 1, model 144M-parameter yang dibangun di atas encoder ModernBERT [5] (22 lapisan, ukuran tersembunyi 384) dengan kepala keputusan, dan menyempurnakan tiga salinan. Masing-masing belajar dari pengajar yang ditulis dalam kode: batang otak kode, aturan langkah kode, dan formula otot.
| Model | Pelatihan di CPU | Julia 1 dasar | Disempurnakan |
|---|---|---|---|
| LifeSim-Brainstem-0.1 | 216 s | r = −0.37 | r = 0.9997 |
| LifeSim-Step-0.3 | 308 s | r = 0.24 | r = 0.9998 |
| LifeSim-Muscle-0.1 | 642 s | r = 0.12 | r = 0.958 |
Korelasi tinggi pada input yang tidak termasuk dalam pelatihan tidak cukup untuk berjalan. Model langkah pertama kali belajar hanya dari situasi yang ditemui aturan kode, dan setelah terkendali, ia membawa tubuh ke situasi yang belum pernah dilihat aturan. Kami membiarkannya berjalan, merekam apa yang ditemuinya, menanyakan aturan apa yang akan dilakukannya, dan melatih lagi (DAgger [6]). Waktu berjalan meningkat dari 83% menjadi 92% dari pengajar.
Penyempurnaan bersifat deterministik, sehingga pertanyaan yang sama selalu mendapatkan jawaban yang sama. Kami menyimpan setiap jawaban dan hanya menanyakan model pertanyaan yang belum pernah dilihatnya. Setelah beberapa detik, sebagian besar tick tidak memerlukan panggilan model sama sekali.
4 Hasil
4.1 Berdiri
Dengan setiap lapisan pada model bahasa, kedua tubuh berdiri tanpa alat bantu dan pulih dari dorongan 80 N dari depan dan belakang. Selama 20 kali berdiri yang didorong, model batang otak berdiri selama pengajarnya: 12,4 detik berbanding 12,0 detik.
4.2 Berjalan
Pejalan kaki adalah SIMBICON [7] pada otot: pengatur waktu langkah, kaki ayun, dan penempatan kaki dari posisi dan kecepatan berat. Tanpa alat bantu, tubuh berjalan sekitar 0,25 m/s, mengarah ke tujuan. Dalam simulasi langsung, rata-rata jalan berlangsung 18 langkah di antara jatuh, dan yang terpanjang 133 (Gambar 2).
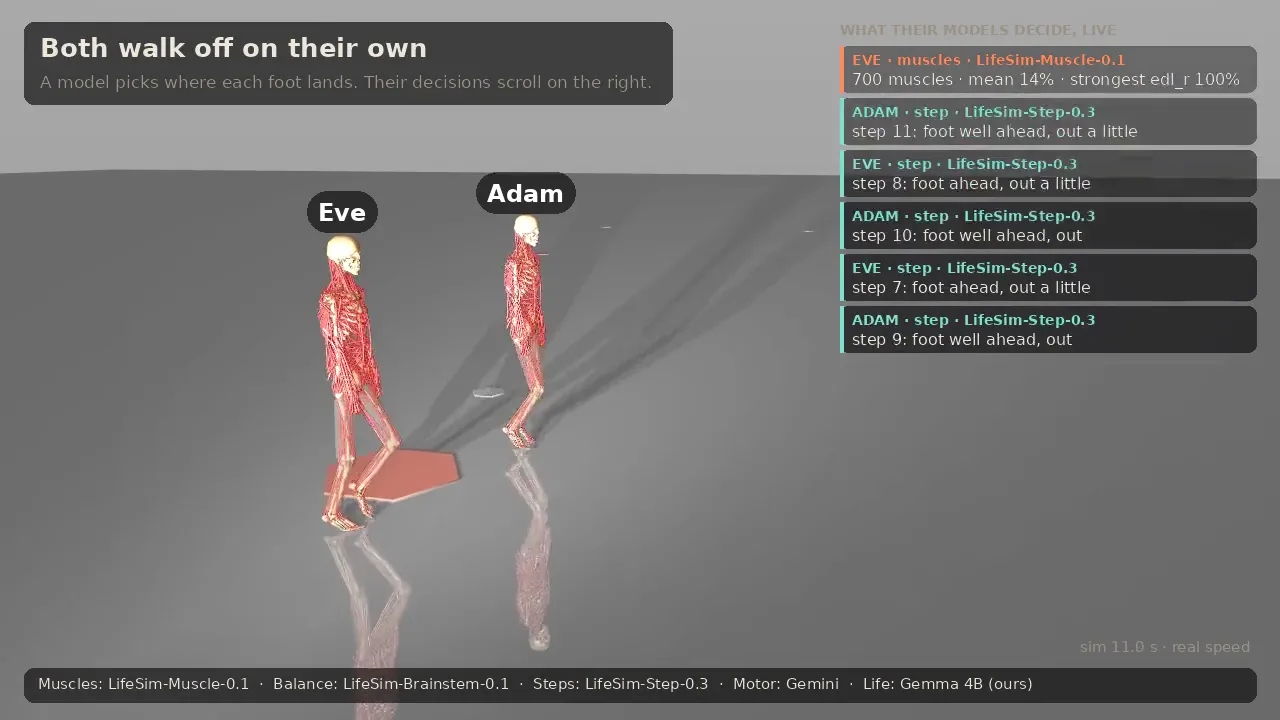
Dalam jalan 12 detik, model langkah menjaga tubuh tetap tegak rata-rata selama 8,6 detik, dibandingkan 9,4 detik untuk aturan kode yang mengajarkannya (24 kali jalan). Berdiri memaafkan kesalahan kecil. Berjalan tidak.
4.3 Kecepatan
Semuanya berjalan di satu mesin CPU, tanpa GPU. Simulasi menunggu model (“waktu lambat”), karena keseimbangan membutuhkan keputusan setiap 10 ms. Kedua tubuh dengan setiap model berjalan pada 0,25 hingga 0,5× waktu nyata, dan pada 0,12 hingga 0,18× saat keduanya digambar.
4.4 Di LifeSim
Dua orang yang sama muncul di peta LifeSim, dengan kebutuhan, rencana, dan apa yang mereka katakan satu sama lain (Gambar 3).
5 Apa yang kami pelajari
- Kata-kata harus membawa angka. “Condong sedikit ke depan” terlalu samar untuk menjaga keseimbangan: tubuh jatuh dalam 3 hingga 6 detik. “Beratnya 3 cm di depan tengah kaki, bergerak maju dengan kecepatan 4 cm/dtk” membuatnya tetap tegak.
- Kata-kata otak menentukan resolusi otot. Di bawah “berdiri diam”, model otot menjawab dalam langkah sekitar 15%. Di bawah “tahan stabil dengan kontrol halus”, langkahnya sekitar 10%, dan baru kemudian tubuh bertahan dari dorongan dari depan.
- Otot bekerja seperti neuron motorik. Model otot menjawab dalam langkah kasar. Bergantian antara langkah-langkah tetangga dari tick ke tick, seperti tingkat tembakan, membuat jalan berlangsung sekitar 50% lebih lama.
- Berjalan itu kacau. Mengubah satu keuntungan sebesar satu bagian dalam sejuta mengubah berapa lama jalan berlangsung sepertiga. Satu kali percobaan tidak membuktikan apa-apa, jadi setiap angka berjalan di sini adalah rata-rata dari 12 atau lebih kali jalan.
6 Apa yang belum berhasil
- Berhenti. Tubuh yang berjalan yang diserahkan ke keseimbangan berdiri jatuh dalam satu detik: 0 dari 20 percobaan berhasil berdiri. Saat tiba, tubuh menyatu ke posisi berdiri. Ini adalah animasi, dan kami melabelinya sebagai satu.
- Bangun. Setelah jatuh, tubuh menyatu kembali ke posisi berdiri dalam satu detik. Juga animasi.
- Kecepatan lain. Hanya kecepatan yang disetel oleh pejalan kaki yang berfungsi.
- Penyetelan lebih lanjut. Tiga metode pencarian (evolusi, CMA-ES, dan Augmented Random Search) tidak dapat meningkatkan walker. Walker yang lebih kokoh membutuhkan pengontrol seluruh tubuh, atau kebijakan yang dilatih dengan pembelajaran penguatan pada GPU.
7 Mengapa kami mencoba ini
Kami tidak bermaksud membangun walker terbaik. Pembelajaran penguatan menghasilkan yang lebih baik. Kami bermaksud melihat apakah satu jenis model dapat mencapai dari “apa yang harus saya lakukan malam ini” hingga “otot mana yang menarik seberapa keras”. Itu bisa, dengan bantuan beberapa baris kode di tengah. Model terbuka kecil, yang disetel dengan baik pada CPU dalam hitungan menit, dapat mengambil sebagian besar lapisan.
Kami belum tahu untuk apa ini. Mungkin orang-orang di LifeSim yang bergerak karena mereka memutuskan untuk bergerak, bukan karena animasi diputar. Mungkin tidak ada apa-apa. Teknologi bergerak terlalu cepat untuk dikatakan, itulah alasan untuk mencoba hal-hal seperti ini sekarang, dan untuk membagikan apa yang kami temukan.
8 Pekerjaan di masa depan
Hasil yang paling menjanjikan adalah bahwa kata-kata mengubah tubuh: “tahan stabil dengan kontrol halus” memberi otot resolusi yang lebih halus daripada “berdiri diam”, dan baru kemudian tubuh bertahan dari dorongan dari depan. Eksperimen selanjutnya adalah menunjukkan tubuh yang sama merespons kata-kata yang berbeda, seperti “berjalanlah seperti kamu lelah”, “bersiaplah untuk dorongan” atau “santai”. Pengontrol kode tidak dapat menerima instruksi seperti itu. Model bahasa bisa.
Referensi
- Zuo, C., He, K., Shao, J., Sui, Y. Self Model for Embodied Intelligence: Modeling Full-Body Human Musculoskeletal System and Locomotion Control with Hierarchical Low-Dimensional Representation. ICRA, 2024.
- Todorov, E., Erez, T., Tassa, Y. MuJoCo: A physics engine for model-based control. IROS, 2012.
- Tim Gemma. Laporan Teknis Gemma 3. arXiv:2503.19786, 2025.
- Shao, Z., Wang, P., Zhu, Q., Xu, R., Song, J., et al. DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models. arXiv:2402.03300, 2024.
- Warner, B., Chaffin, A., Clavié, B., Weller, O., Hallström, O., et al. Smarter, Better, Faster, Longer: A Modern Bidirectional Encoder for Fast, Memory Efficient, and Long Context Finetuning and Inference. arXiv:2412.13663, 2024.
- Ross, S., Gordon, G. J., Bagnell, J. A. A Reduction of Imitation Learning and Structured Prediction to No-Regret Online Learning. AISTATS, 2011.
- Yin, K., Loken, K., van de Panne, M. SIMBICON: Simple Biped Locomotion Control. ACM SIGGRAPH, 2007.
Kutipan
Harap kutip karya ini sebagai:
@misc{lifesim2026adamandeve,
  title  = {Adam & Eve: 700 LLM-Controlled Muscles via Fine-Tuned Decision Models},
  author = {{Cris Lenta}},
  year   = {2026},
  month  = {oct},
  url    = {https://lifesim.com/research/adam-and-eve}
}