

27 de outubro de 2026
Adão e Eva: 700 Músculos Controlados por LLM via Modelos de Decisão Ajustados
Resumo
Adão e Eva são dois humanos simulados com 700 músculos cada, vivendo juntos no Palace of Fine Arts em São Francisco. Modelos de linguagem executam cada camada deles que um modelo de linguagem pode executar: o que fazer com o dia, para onde andar, como manter o equilíbrio, onde cada pé pisa e com que força cada músculo puxa. Três desses modelos são nossos: ajustes finos de 144M parâmetros, treinados em uma CPU em 4 a 11 minutos cada, que copiam seus professores com uma correlação de 0,958 a 0,9998 em entradas que nunca viram. Sem suporte, ambos os corpos resistem a empurrões de 80 N e andam algumas dezenas de passos entre as quedas. Este é um experimento, não um produto. Relatamos o que funciona, o que não funciona e os números.
1 Um experimento
A tecnologia está avançando tão rápido que ninguém sabe para onde a simulação irá em seguida. Há um ano, um modelo de linguagem podia manter uma conversa. Hoje, ele pode planejar uma semana, usar ferramentas e funcionar por horas. Não sabemos onde está o limite, então tentamos encontrá-lo.
A pergunta era simples: até onde um modelo de linguagem pode ir? As pessoas da LifeSim já pensam com modelos de linguagem. Elas decidem o que fazer, com quem conversar e para onde ir. Abaixo disso, todo jogo usa animação. Um corpo que anda é um corpo que reproduz uma gravação.
Substituímos a gravação por um corpo. MS-Human-700 [1] é um modelo aberto do sistema musculoesquelético humano com 700 músculos, simulado em MuJoCo [2]. Colocamos dois deles em uma cena, em um chão feito do mapa real, e demos todas as decisões que pudemos a um modelo de linguagem. Não sabíamos se ele ficaria de pé. Ele ficou.
2 As camadas
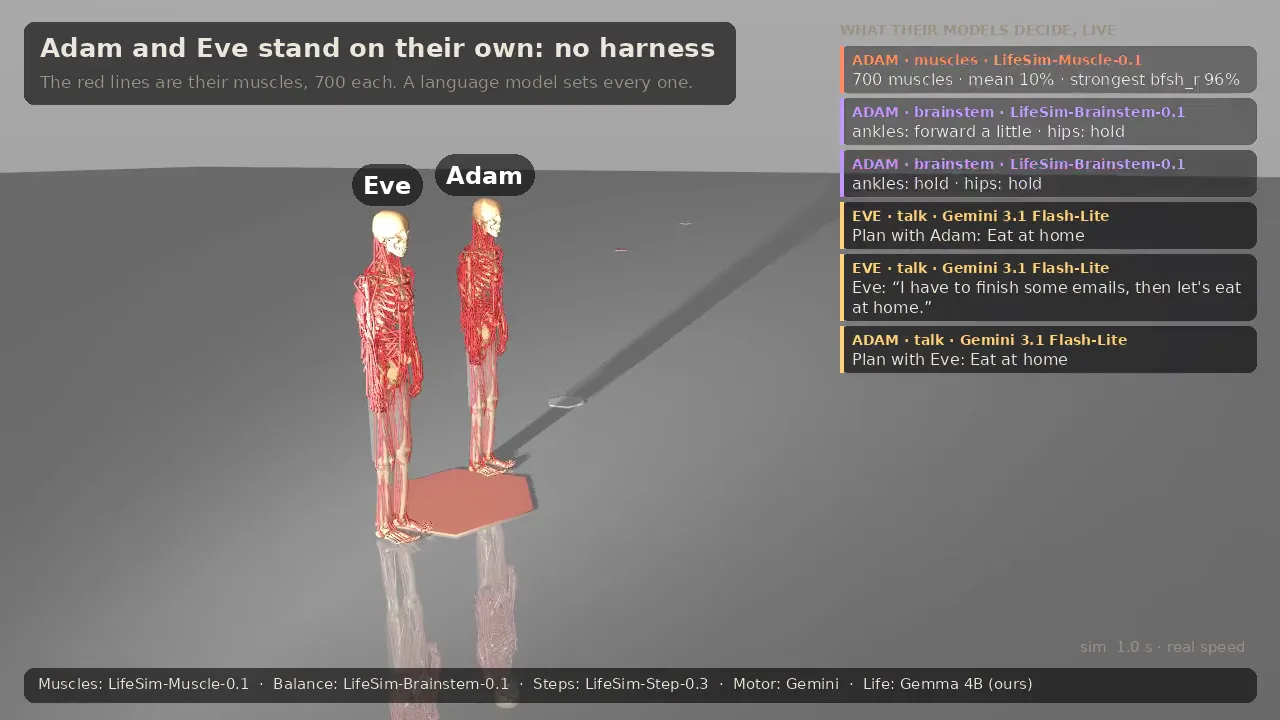
Copiamos as camadas de um corpo e uma mente, e demos cada camada que pode ser um modelo de linguagem a um (Tabela 1). Apenas a medula espinhal é código: ela transforma “incline-se um pouco para trás” ou “coloque o pé aqui” em 700 puxões musculares.
| Camada | Em uma pessoa | Modelo | Com que frequência |
|---|---|---|---|
| Vida | O que fazer com o dia | Gemma 3 4B [3], ajustado por nós com GRPO [4] em LifeSim Week | Uma vez por atividade, ~4 s |
| Córtex motor | “Ande até lá, firme o tronco” | Gemini 3.1 Flash-Lite | Cerca de uma vez por segundo, ~1 s |
| Tronco encefálico | Mantém você ereto | LifeSim-Brainstem-0.1 (nosso) | 2 perguntas por tick, em pé |
| Decisão de passo | Onde o próximo pé pisa | LifeSim-Step-0.3 (nosso) | 2 perguntas por tick, andando |
| Medula espinhal | Fiação fixa | Código | A cada tick |
| Músculos | Contrair | LifeSim-Muscle-0.1 (nosso) | 700 perguntas por tick, por pessoa |
Cada camada fala em palavras. O tronco encefálico lê “o peso está 3 cm à frente do meio dos pés, movendo-se para frente a 4 cm/s” e responde como se inclinar. Cada músculo lê a linha de sua região corporal do córtex motor e um impulso da medula espinhal, e responde com que força contrair.
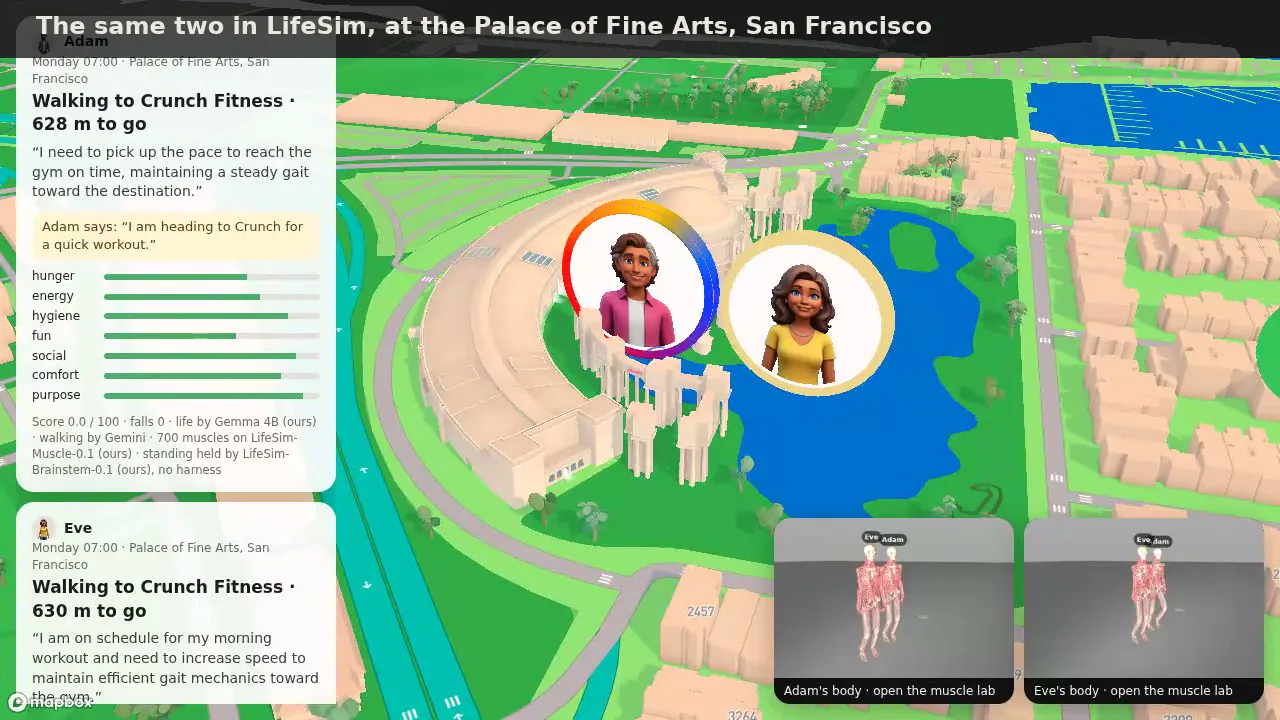
Adão e Eva também sabem um sobre o outro. Cada modelo de vida lê onde o parceiro está e o que está fazendo. Quando os dois se encontram, Gemini escreve uma linha para cada um deles, e eles podem concordar em um plano: “quer jantar no Kibatsu mais tarde?” (Figura 3).
3 Três modelos pequenos
As três camadas mais baixas respondem até 1.400 perguntas a cada 10 ms, então precisam de um modelo pequeno. Usamos Julia 1, um modelo de 144M parâmetros construído em um codificador ModernBERT [5] (22 camadas, tamanho oculto 384) com uma cabeça de decisão, e ajustamos três cópias. Cada uma aprendeu com um professor escrito em código: o tronco encefálico de código, a regra de passo de código e a fórmula muscular.
| Modelo | Treinamento em uma CPU | Base Julia 1 | Ajustado |
|---|---|---|---|
| LifeSim-Brainstem-0.1 | 216 s | r = −0.37 | r = 0.9997 |
| LifeSim-Step-0.3 | 308 s | r = 0.24 | r = 0.9998 |
| LifeSim-Muscle-0.1 | 642 s | r = 0.12 | r = 0.958 |
Uma alta correlação em entradas retidas não é suficiente para andar. O modelo de passo primeiro aprendeu apenas com situações que a regra de código encontrou, e uma vez no controle, levou o corpo a situações que a regra nunca viu. Deixamos ele andar, registramos o que ele encontrou, perguntamos à regra o que ela teria feito e treinamos novamente (DAgger [6]). O tempo de caminhada aumentou de 83% para 92% do professor.
Os ajustes finos são determinísticos, então a mesma pergunta sempre obtém a mesma resposta. Mantemos todas as respostas e só fazemos ao modelo perguntas que ele não viu. Após alguns segundos, a maioria dos ticks não precisa de nenhuma chamada de modelo.
4 Resultados
4.1 Em pé
Com cada camada em um modelo de linguagem, ambos os corpos ficam em pé sem suporte e se recuperam de empurrões de 80 N pela frente e por trás. Em 20 tentativas de ficar em pé após empurrões, o modelo do tronco encefálico fica em pé tanto quanto seu professor: 12,4 s contra 12,0 s.
4.2 Andando
O andarilho é SIMBICON [7] em músculos: um temporizador de passo, uma perna de balanço e posicionamento do pé a partir da posição e velocidade do peso. Sem suporte, os corpos andam a cerca de 0,25 m/s, direcionando-se para o objetivo. Na simulação ao vivo, a caminhada mediana durou 18 passos entre as quedas, e a mais longa 133 (Figura 2).
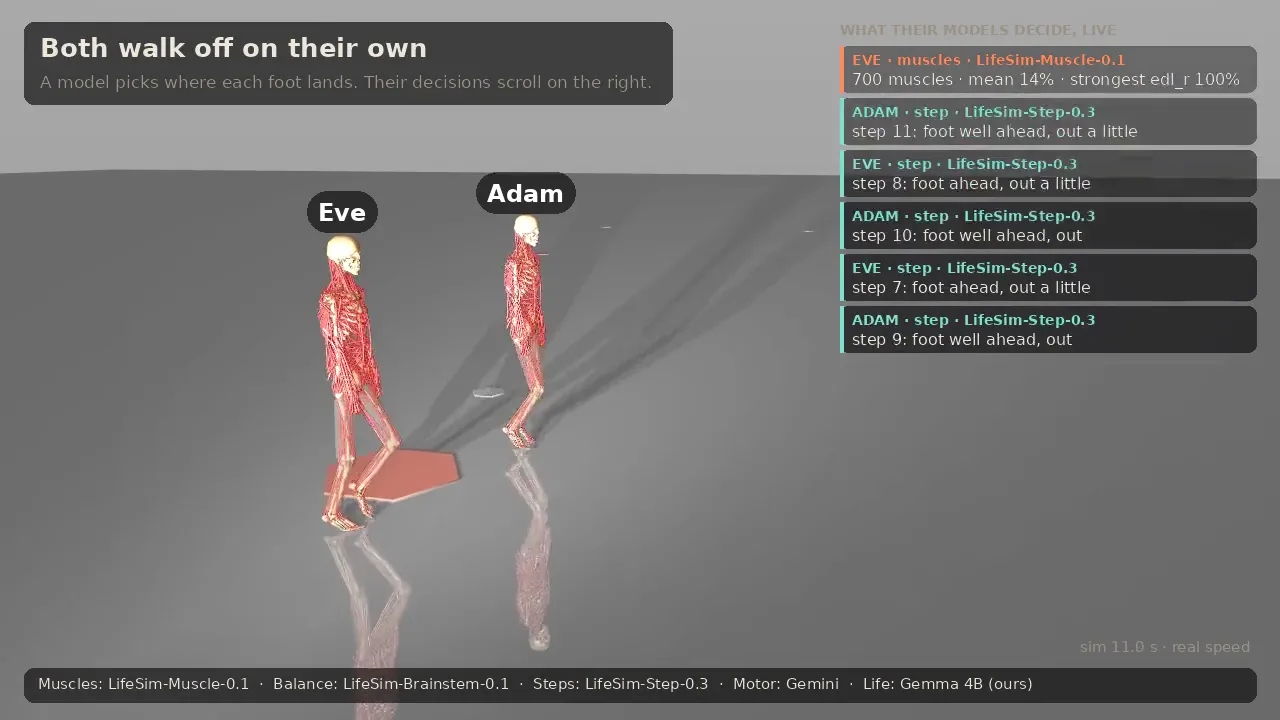
Em uma caminhada de 12 s, o modelo de passo mantém o corpo em pé por 8,6 s em média, contra 9,4 s para a regra de código que o ensinou (24 caminhadas). Ficar em pé perdoa pequenos erros. Andar não.
4.3 Velocidade
Tudo roda em uma máquina CPU, sem GPU. A simulação espera pelos modelos (“tempo lento”), porque o equilíbrio precisa de uma decisão a cada 10 ms. Ambos os corpos com todos os modelos rodam a 0,25 a 0,5× tempo real, e a 0,12 a 0,18× enquanto ambos são desenhados.
4.4 Em LifeSim
As mesmas duas pessoas aparecem no mapa da LifeSim, com suas necessidades, seus planos e o que dizem uma à outra (Figura 3).
5 O que aprendemos
- Palavras devem carregar números. “Inclinando-se um pouco para frente” é muito vago para equilibrar: o corpo caía em 3 a 6 s. “O peso está 3 cm à frente do meio dos pés, movendo-se para frente a 4 cm/s” o mantém em pé.
- As palavras do cérebro definem a resolução dos músculos. Sob “fique parado”, o modelo muscular responde em passos de cerca de 15%. Sob “mantenha-se firme com controle fino”, os passos são de cerca de 10%, e só então o corpo sobrevive a um empurrão pela frente.
- Músculos funcionam como neurônios motores. O modelo muscular responde em passos grosseiros. Alternar entre passos vizinhos de tick para tick, como uma taxa de disparo, faz as caminhadas durarem cerca de 50% mais.
- Andar é caótico. Mudar um ganho em uma parte em um milhão muda a duração de uma caminhada em um terço. Uma execução não prova nada, então cada número de caminhada aqui é uma média de 12 ou mais caminhadas.
6 O que ainda não funciona
- Parar. Um corpo andando entregue ao equilíbrio em pé cai em um segundo: 0 de 20 tentativas ficaram em pé. Ao chegar, o corpo se mistura a uma pose em pé. Isso é uma animação, e a rotulamos como tal.
- Levantar. Após uma queda, o corpo volta a ficar em pé em um segundo. Também é uma animação.
- Outras velocidades. Apenas a velocidade em que o andarilho foi ajustado funciona.
- Mais ajustes. Três métodos de busca (evolução, CMA-ES e Busca Aleatória Aumentada) não conseguiram melhorar o andador. Um mais robusto precisa de um controlador de corpo inteiro, ou de uma política treinada com aprendizado por reforço em uma GPU.
7 Por que tentamos isso
Não nos propusemos a construir o melhor andador. O aprendizado por reforço faz melhores. Propusemo-nos a ver se um tipo de modelo pode ir de “o que faço esta noite” até “qual músculo puxa com que força”. Pode, com a ajuda de algumas linhas de código no meio. Pequenos modelos abertos, ajustados em uma CPU em minutos, podem assumir a maioria das camadas.
Ainda não sabemos para que serve isso. Talvez pessoas no LifeSim que se movem porque decidem, não porque uma animação é reproduzida. Talvez nada. A tecnologia está avançando muito rápido para dizer, e essa é a razão para tentar coisas assim agora e compartilhar o que encontramos.
8 Trabalho futuro
O resultado mais promissor é que as palavras mudam o corpo: “mantenha-se firme com controle fino” deu aos músculos uma resolução mais fina do que “fique parado”, e só então o corpo sobreviveu a um empurrão pela frente. O próximo experimento é mostrar o mesmo corpo respondendo a palavras diferentes, como “ande como se estivesse cansado”, “prepare-se para um empurrão” ou “relaxe”. Um controlador de código não pode receber uma instrução como essa. Um modelo de linguagem pode.
Referências
- Zuo, C., He, K., Shao, J., Sui, Y. Self Model for Embodied Intelligence: Modeling Full-Body Human Musculoskeletal System and Locomotion Control with Hierarchical Low-Dimensional Representation. ICRA, 2024.
- Todorov, E., Erez, T., Tassa, Y. MuJoCo: A physics engine for model-based control. IROS, 2012.
- Gemma Team. Gemma 3 Technical Report. arXiv:2503.19786, 2025.
- Shao, Z., Wang, P., Zhu, Q., Xu, R., Song, J., et al. DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models. arXiv:2402.03300, 2024.
- Warner, B., Chaffin, A., Clavié, B., Weller, O., Hallström, O., et al. Smarter, Better, Faster, Longer: A Modern Bidirectional Encoder for Fast, Memory Efficient, and Long Context Finetuning and Inference. arXiv:2412.13663, 2024.
- Ross, S., Gordon, G. J., Bagnell, J. A. A Reduction of Imitation Learning and Structured Prediction to No-Regret Online Learning. AISTATS, 2011.
- Yin, K., Loken, K., van de Panne, M. SIMBICON: Simple Biped Locomotion Control. ACM SIGGRAPH, 2007.
Citação
Por favor, cite este trabalho como:
@misc{lifesim2026adamandeve,
  title  = {Adam & Eve: 700 LLM-Controlled Muscles via Fine-Tuned Decision Models},
  author = {{Cris Lenta}},
  year   = {2026},
  month  = {oct},
  url    = {https://lifesim.com/research/adam-and-eve}
}