

27 de octubre de 2026
Adán y Eva: 700 músculos controlados por LLM mediante modelos de decisión ajustados
Resumen
Adán y Eva son dos humanos simulados con 700 músculos cada uno, que viven juntos en el Palacio de Bellas Artes de San Francisco. Los modelos de lenguaje ejecutan cada capa de ellos que un modelo de lenguaje puede ejecutar: qué hacer con el día, dónde caminar, cómo mantener el equilibrio, dónde aterriza cada pie y con qué fuerza tira cada músculo. Tres de esos modelos son nuestros: ajustes finos de 144M de parámetros, entrenados en una CPU en 4 a 11 minutos cada uno, que copian a sus maestros con una correlación de 0.958 a 0.9998 en entradas que nunca vieron. Sin arnés, ambos cuerpos se mantienen en pie ante empujes de 80 N y caminan unas pocas docenas de pasos entre caídas. Esto es un experimento, no un producto. Informamos lo que funciona, lo que no y los números.
1 Un experimento
La tecnología avanza tan rápido que nadie sabe hacia dónde irá la simulación. Hace un año, un modelo de lenguaje podía mantener una conversación. Hoy, puede planificar una semana, usar herramientas y funcionar durante horas. No sabemos dónde está el límite, así que intentamos encontrarlo.
La pregunta era simple: ¿hasta dónde puede llegar un modelo de lenguaje? La gente de LifeSim ya piensa con modelos de lenguaje. Deciden qué hacer, con quién hablar y adónde ir. Debajo de eso, cada juego usa animación. Un cuerpo que camina es un cuerpo que reproduce una grabación.
Reemplazamos la grabación con un cuerpo. MS-Human-700 [1] es un modelo abierto del sistema musculoesquelético humano con 700 músculos, simulado en MuJoCo [2]. Pusimos dos de ellos en una escena, en un suelo hecho a partir del mapa real, y le dimos cada decisión que pudimos a un modelo de lenguaje. No sabíamos si se mantendría en pie. Lo hizo.
2 Las capas
Copiamos las capas de un cuerpo y una mente, y le dimos cada capa que puede ser un modelo de lenguaje a uno (Tabla 1). Solo la médula espinal es código: convierte “inclínate un poco hacia atrás” o “pon el pie aquí” en 700 tirones musculares.
| Capa | En una persona | Modelo | Con qué frecuencia |
|---|---|---|---|
| Vida | Qué hacer con el día | Gemma 3 4B [3], ajustado por nosotros con GRPO [4] en LifeSim Week | Una vez por actividad, ~4 s |
| Corteza motora | “Camina hasta allí, sujeta el tronco” | Gemini 3.1 Flash-Lite | Aproximadamente una vez por segundo, ~1 s |
| Tronco encefálico | Te mantiene erguido | LifeSim-Brainstem-0.1 (nuestro) | 2 preguntas por tick, de pie |
| Decisión de paso | Dónde aterriza el siguiente pie | LifeSim-Step-0.3 (nuestro) | 2 preguntas por tick, caminando |
| Médula espinal | Cableado fijo | Código | Cada tick |
| Músculos | Contraer | LifeSim-Muscle-0.1 (nuestro) | 700 preguntas por tick, por persona |
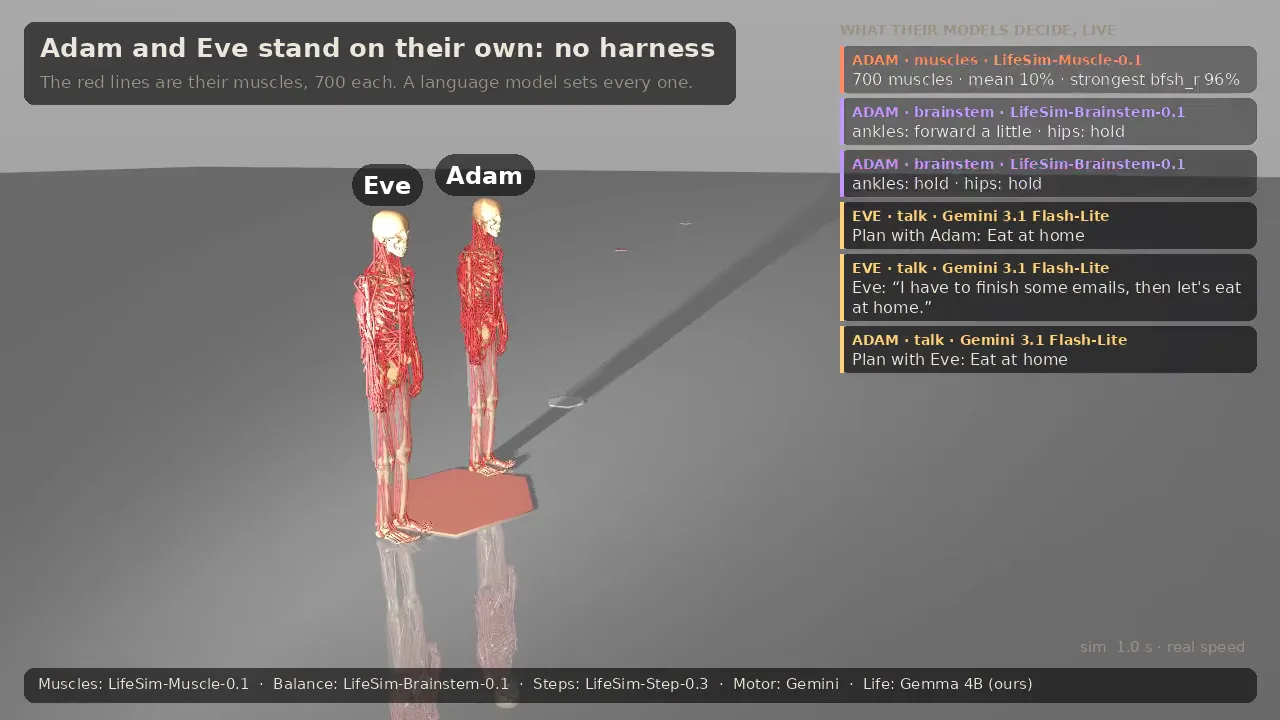
Cada capa habla con palabras. El tronco encefálico lee “el peso está 3 cm delante del centro de los pies, moviéndose hacia adelante a 4 cm/s” y responde cómo inclinarse. Cada músculo lee la línea de su región corporal de la corteza motora y un impulso de la médula espinal, y responde con qué fuerza contraerse.
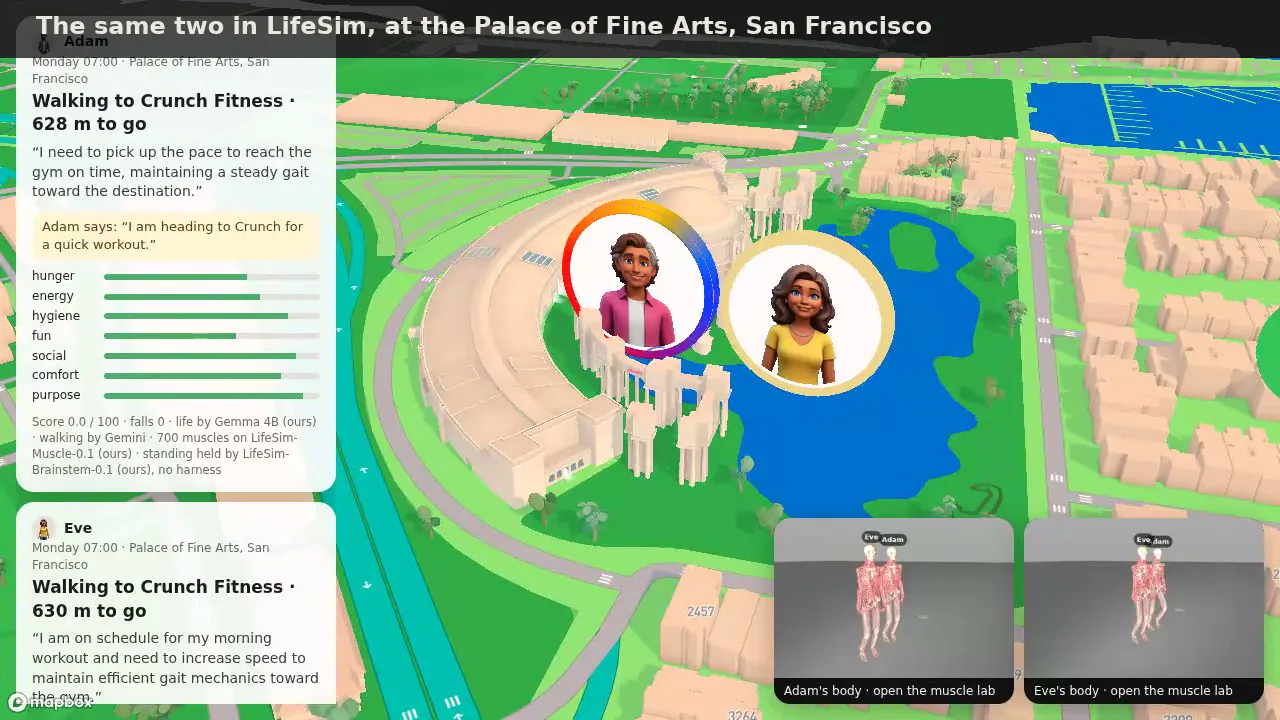
Adán y Eva también se conocen. Cada modelo de vida lee dónde está el compañero y qué está haciendo. Cuando los dos se encuentran, Gemini escribe una línea para cada uno de ellos, y pueden acordar un plan: “¿quieres cenar en Kibatsu más tarde?” (Figura 3).
3 Tres modelos pequeños
Las tres capas más bajas responden hasta 1.400 preguntas cada 10 ms, por lo que necesitan un modelo pequeño. Usamos Julia 1, un modelo de 144M de parámetros construido sobre un codificador ModernBERT [5] (22 capas, tamaño oculto 384) con una cabeza de decisión, y ajustamos tres copias. Cada una aprendió de un maestro escrito en código: el tronco encefálico de código, la regla de paso de código y la fórmula muscular.
| Modelo | Entrenamiento en una CPU | Julia 1 base | Ajustado |
|---|---|---|---|
| LifeSim-Brainstem-0.1 | 216 s | r = −0.37 | r = 0.9997 |
| LifeSim-Step-0.3 | 308 s | r = 0.24 | r = 0.9998 |
| LifeSim-Muscle-0.1 | 642 s | r = 0.12 | r = 0.958 |
Una alta correlación en entradas no vistas no es suficiente para caminar. El modelo de paso primero aprendió solo de situaciones que la regla de código encontró, y una vez en control, llevó al cuerpo a situaciones que la regla nunca vio. Lo dejamos caminar, registramos lo que encontró, le preguntamos a la regla qué habría hecho y entrenamos de nuevo (DAgger [6]). El tiempo de caminata aumentó del 83% al 92% del de su maestro.
Los ajustes finos son deterministas, por lo que la misma pregunta siempre obtiene la misma respuesta. Guardamos cada respuesta y solo hacemos al modelo preguntas que no ha visto. Después de unos segundos, la mayoría de los ticks no necesitan ninguna llamada al modelo.
4 Resultados
4.1 De pie
Con cada capa en un modelo de lenguaje, ambos cuerpos se mantienen de pie sin arnés y se recuperan de empujes de 80 N desde el frente y desde atrás. En más de 20 pruebas de pie empujadas, el modelo del tronco encefálico se mantiene en pie tanto como su maestro: 12.4 s frente a 12.0 s.
4.2 Caminando
El caminante es SIMBICON [7] sobre músculos: un temporizador de pasos, una pierna oscilante y colocación del pie a partir de la posición y velocidad del peso. Sin arnés, los cuerpos caminan a unos 0.25 m/s, dirigiéndose hacia el objetivo. En la simulación en vivo, la caminata mediana duró 18 pasos entre caídas, y la más larga 133 (Figura 2).
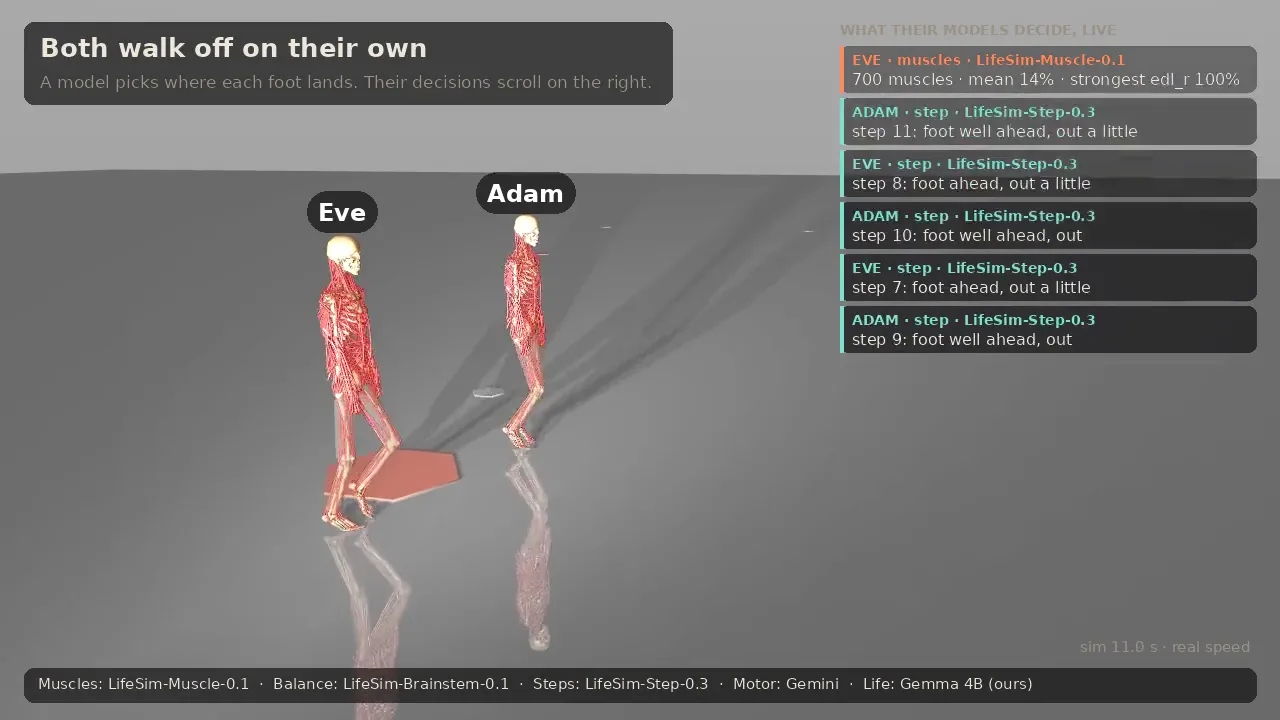
En una caminata de 12 s, el modelo de paso mantiene el cuerpo en pie durante 8.6 s en promedio, frente a 9.4 s para la regla de código que lo enseñó (24 caminatas). Estar de pie perdona pequeños errores. Caminar no.
4.3 Velocidad
Todo funciona en una máquina con una sola CPU, sin GPU. La simulación espera a los modelos (“tiempo lento”), porque el equilibrio necesita una decisión cada 10 ms. Ambos cuerpos con cada modelo funcionan a 0.25 a 0.5× tiempo real, y a 0.12 a 0.18× mientras ambos están dibujados.
4.4 En LifeSim
Las mismas dos personas aparecen en el mapa de LifeSim, con sus necesidades, sus planes y lo que se dicen (Figura 3).
5 Lo que aprendimos
- Las palabras deben llevar números. “Inclinarse un poco hacia adelante” es demasiado vago para mantener el equilibrio: el cuerpo se caía en 3 a 6 s. “El peso está 3 cm delante del centro de los pies, moviéndose hacia adelante a 4 cm/s” lo mantiene en pie.
- Las palabras del cerebro establecen la resolución de los músculos. Bajo “quédate quieto”, el modelo muscular responde en pasos de aproximadamente el 15%. Bajo “mantente firme con control fino”, los pasos son de aproximadamente el 10%, y solo entonces el cuerpo sobrevive a un empuje desde el frente.
- Los músculos funcionan como neuronas motoras. El modelo muscular responde en pasos gruesos. Alternar entre pasos vecinos de tick en tick, como una tasa de disparo, hace que las caminatas duren aproximadamente un 50% más.
- Caminar es caótico. Cambiar una ganancia en una parte por millón cambia la duración de una caminata en un tercio. Una sola ejecución no prueba nada, por lo que cada número de caminata aquí es un promedio de 12 o más caminatas.
6 Lo que aún no funciona
- Detenerse. Un cuerpo que camina entregado al equilibrio de pie se cae en un segundo: 0 de 20 intentos se mantuvieron en pie. Al llegar, el cuerpo se fusiona en una pose de pie. Esto es una animación, y lo etiquetamos como tal.
- Levantarse. Después de una caída, el cuerpo vuelve a ponerse de pie en un segundo. También es una animación.
- Otras velocidades. Solo funciona la velocidad a la que se ajustó el caminante.
- Más ajustes. Tres métodos de búsqueda (evolución, CMA-ES y Búsqueda Aleatoria Aumentada) no pudieron mejorar al caminante. Uno más robusto necesita un controlador de cuerpo completo, o una política entrenada con aprendizaje por refuerzo en una GPU.
7 Por qué lo intentamos
No nos propusimos construir el mejor caminante. El aprendizaje por refuerzo crea mejores. Nos propusimos ver si un tipo de modelo puede ir desde “qué hago esta noche” hasta “qué músculo tira con qué fuerza”. Puede, con la ayuda de unas pocas líneas de código en el medio. Pequeños modelos abiertos, ajustados en una CPU en minutos, pueden tomar la mayoría de las capas.
Todavía no sabemos para qué sirve esto. Quizás para personas en LifeSim que se mueven porque deciden hacerlo, no porque se reproduzca una animación. Quizás para nada. La tecnología avanza demasiado rápido para decirlo, por eso hay que probar cosas como esta ahora y compartir lo que encontramos.
8 Trabajo futuro
El resultado más prometedor es que las palabras cambian el cuerpo: “mantenerse firme con control fino” dio a los músculos una resolución más fina que “quedarse quieto”, y solo entonces el cuerpo sobrevivió a un empujón frontal. El próximo experimento es mostrar el mismo cuerpo respondiendo a diferentes palabras, como “camina como si estuvieras cansado”, “prepárate para un empujón” o “relájate”. Un controlador de código no puede tomar una instrucción así. Un modelo de lenguaje sí.
Referencias
- Zuo, C., He, K., Shao, J., Sui, Y. Self Model for Embodied Intelligence: Modeling Full-Body Human Musculoskeletal System and Locomotion Control with Hierarchical Low-Dimensional Representation. ICRA, 2024.
- Todorov, E., Erez, T., Tassa, Y. MuJoCo: A physics engine for model-based control. IROS, 2012.
- Gemma Team. Gemma 3 Technical Report. arXiv:2503.19786, 2025.
- Shao, Z., Wang, P., Zhu, Q., Xu, R., Song, J., et al. DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models. arXiv:2402.03300, 2024.
- Warner, B., Chaffin, A., Clavié, B., Weller, O., Hallström, O., et al. Smarter, Better, Faster, Longer: A Modern Bidirectional Encoder for Fast, Memory Efficient, and Long Context Finetuning and Inference. arXiv:2412.13663, 2024.
- Ross, S., Gordon, G. J., Bagnell, J. A. A Reduction of Imitation Learning and Structured Prediction to No-Regret Online Learning. AISTATS, 2011.
- Yin, K., Loken, K., van de Panne, M. SIMBICON: Simple Biped Locomotion Control. ACM SIGGRAPH, 2007.
Cita
Por favor, cita este trabajo como:
@misc{lifesim2026adamandeve,
  title  = {Adam & Eve: 700 LLM-Controlled Muscles via Fine-Tuned Decision Models},
  author = {{Cris Lenta}},
  year   = {2026},
  month  = {oct},
  url    = {https://lifesim.com/research/adam-and-eve}
}