


 English
 Español
 Português
 Bahasa Indonesia
 Română
 हिन्दी
 Français
 Deutsch
 Русский
 Italiano
 Polski
 한국어
 日本語
 简体中文
 Türkçe
 Kiswahili
 বাংলা
 Filipino
10 أكتوبر 2026
LifeSim Interiors: من صورة واحدة إلى غرفة ثلاثية الأبعاد قابلة للتفكيك
ملخص
نقدم LifeSim Interiors، وهو نظام بحث يولد مشهدًا ثلاثي الأبعاد مفككًا من صورة واحدة: بيئة بالإضافة إلى كل كائن كشبكة خاصة به، كل منها في مكانه الصحيح. يوسع النظام TRELLIS.2 [1] لتوليد بيئة وما يصل إلى ثلاثين كائنًا بشكل مشترك، في إطار مشترك واحد. نظرًا لعدم وجود مجموعة بيانات كبيرة من الغرف ثلاثية الأبعاد المفككة، قمنا ببناء خط أنابيب أنتج 5,500 أصل وجمع 10,216 مشهد تدريب صالحًا فيزيائيًا. في المشاهد الاصطناعية المحجوزة، يرتفع F-score عند 10 سم من 4.3% إلى 26.8% مع نمو التدريب من 250 إلى 1,500 خطوة، ولا يظهر المنحنى أي هضبة.
1 مقدمة
المشهد ثلاثي الأبعاد هو أكثر من مجرد سطح. إنه غرفة يمكنك إعادة ترتيبها، أريكة يمكنك تحريكها، رف يمكنك استبداله. يجب أن يستعيد النظام الذي يفهم المساحة هذه الأجزاء، وليس مجرد شبكة واحدة مجمدة.
يولد LifeSim Interiors بيئة بالإضافة إلى كل كائن كشبكة خاصة به. يعتمد على العمل الأخير في استخلاص الكائنات إلى المشاهد وعلى TRELLIS.2 [1] من Microsoft. لقد بنينا المكدس الكامل حوله في يومين على Google Cloud. مساهماتنا هي:
- مصنع عالمي: يتحول النص إلى صور، وتتحول الصور إلى أصول ثلاثية الأبعاد، وتتحول الأصول إلى غرف صالحة فيزيائيًا، على نطاق واسع (القسم 2).
- مولد المشاهد: نموذج كائن ثلاثي الأبعاد موسع لتوليد بيئة والعديد من الكائنات بشكل مشترك، في إطار مشترك واحد (القسم 3).
- تحسين الكائنات: يُعاد إنشاء كل كائن بتفاصيل أعلى ضمن إطاره الخاص، بناءً على بقية المشهد (القسم 3.3).
- القياس: بروتوكول معياري عام، بالإضافة إلى طريقتنا الخاصة لوضع المشاهد التي تم إنشاؤها ضمن إطار كاميرا حقيقية (القسم 4).
2 تصنيع العوالم
لا توجد مجموعة بيانات كبيرة للغرف ثلاثية الأبعاد مقسمة إلى أجزاء منفصلة، لذلك نصنع واحدة. يقوم مولد كائنات مُدرب مسبقًا بإنشاء الأجزاء، وتقوم خطة عملنا بتجميعها في غرف.
2.1 من الكلمات إلى الأجزاء
يبدأ كل كائن وكل غرفة كوصف قصير. يرسمه نموذج صور، ويقوم TRELLIS.2 بتحويل الرسم إلى أصل ثلاثي الأبعاد مزخرف (الشكل 1).
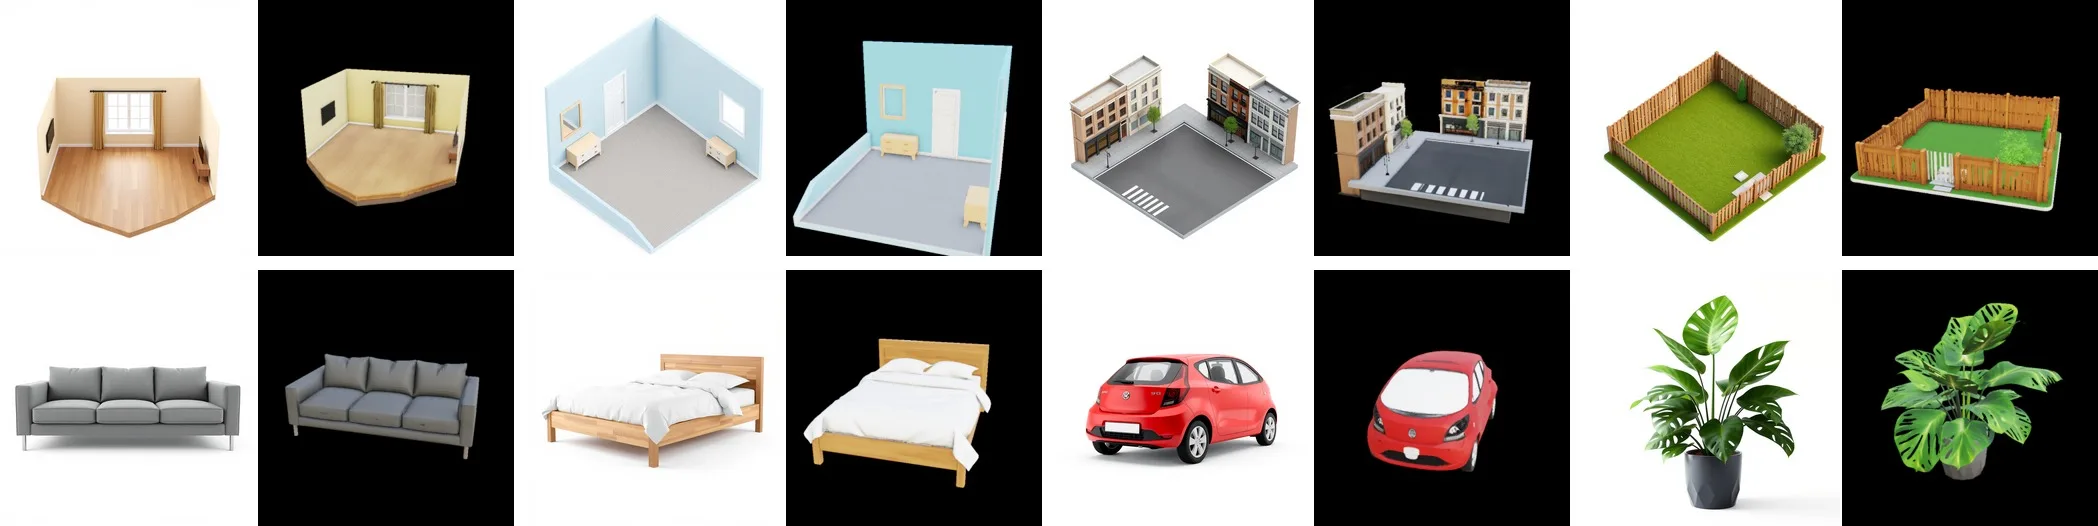
2.2 أصعب الأصول هي الغرفة الفارغة
من الصعب بشكل مدهش إنشاء غرفة فارغة. تتعامل إزالة الخلفية القياسية مع الجدران والأرضيات الباهتة كخلفية، لذلك عادت أول "غرفة معيشة فارغة" لدينا كنافذة وستارتين. يحافظ إخفاء البيئات حسب اللون على الغرفة بأكملها سليمة (الشكل 2).
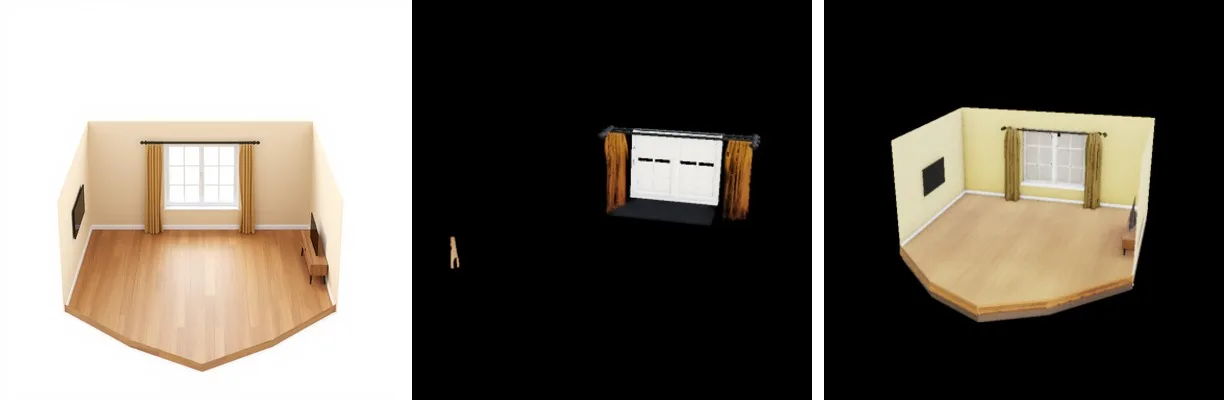
2.3 غرف تخضع للفيزياء
يتم إسقاط كل كائن على سطح دعم حقيقي. يتم رفض أي شيء يطفو أو يمر عبر جدار، ويتم حل الاصطدامات. تستهدف الكاميرات المنطقة المفروشة، مع ضبط مجال الرؤية لكل كائن، ويتم الاحتفاظ فقط بالمشاهد التي يكون فيها كل كائن مرئيًا (الشكل 3).
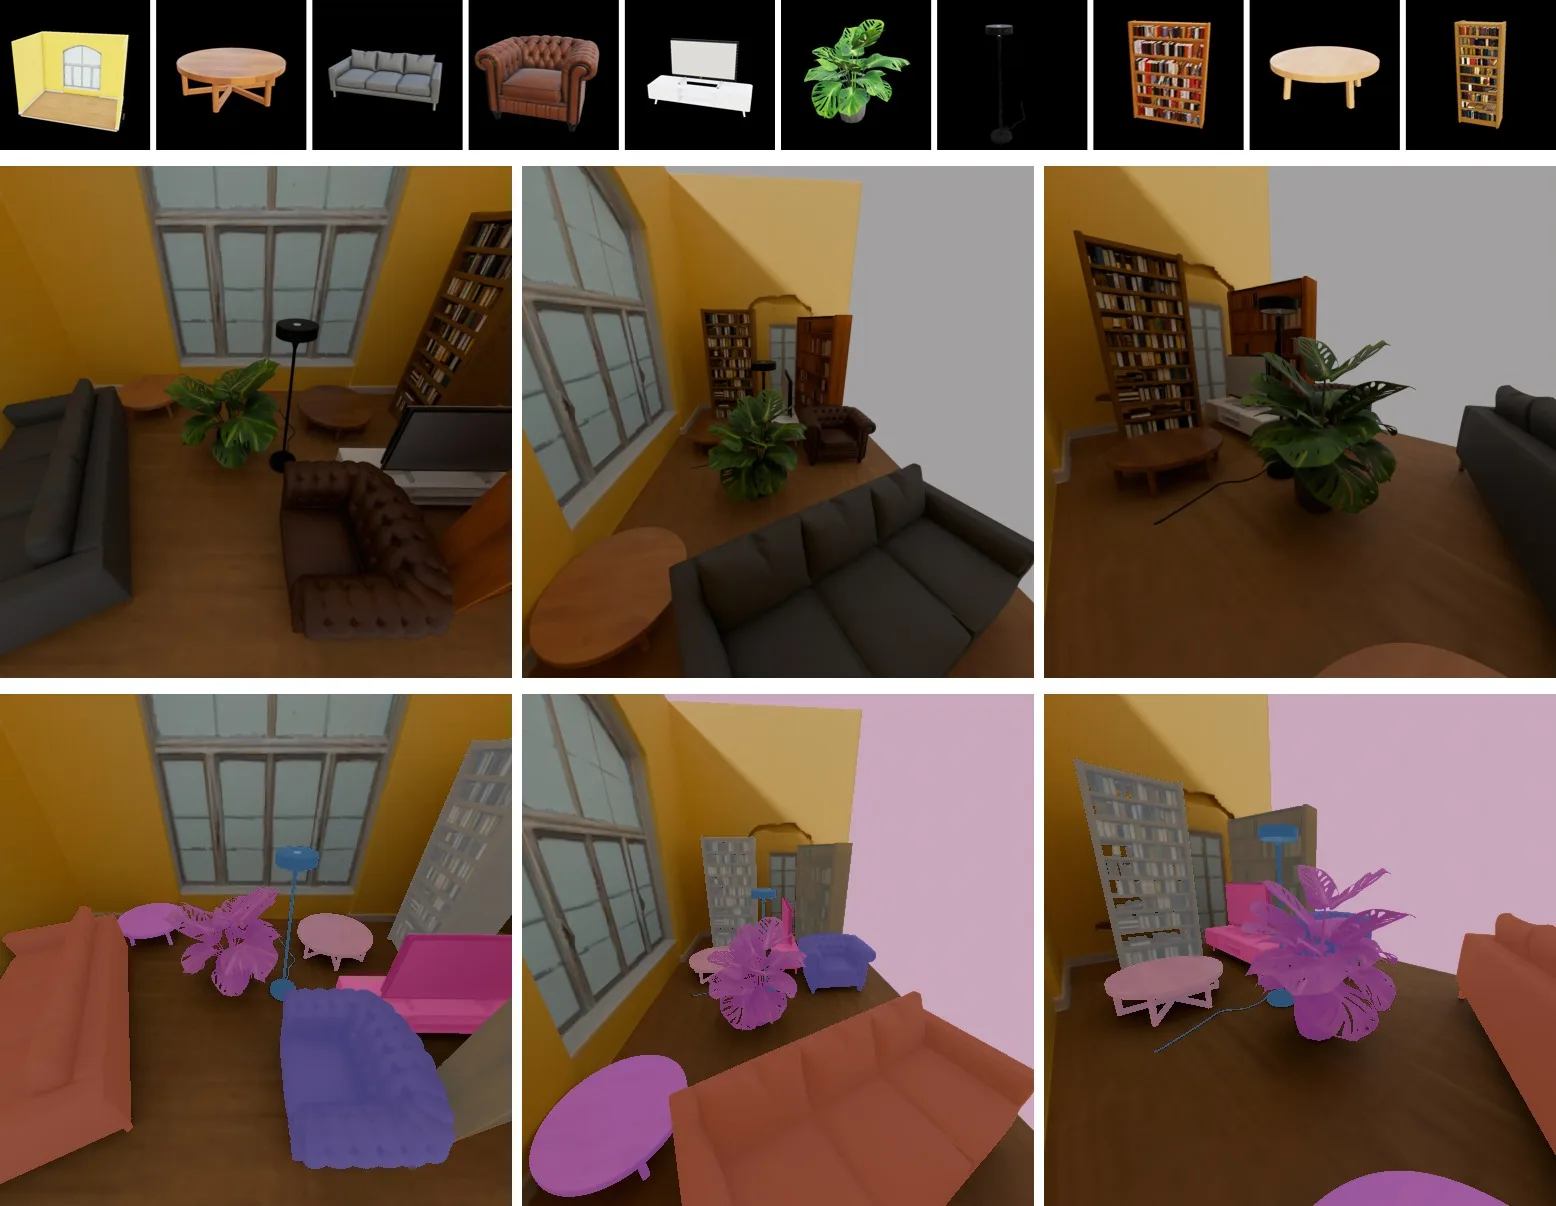
2.4 على نطاق واسع
في أقل من ساعة، أنتج المصنع 5,500 أصل في 16 نوعًا من الغرف و89 فئة من الكائنات. ومنها كوَّن 10,216 مشهدًا تدريبيًا، يضم كل منها ستة كائنات تقريبًا (الشكل 4).
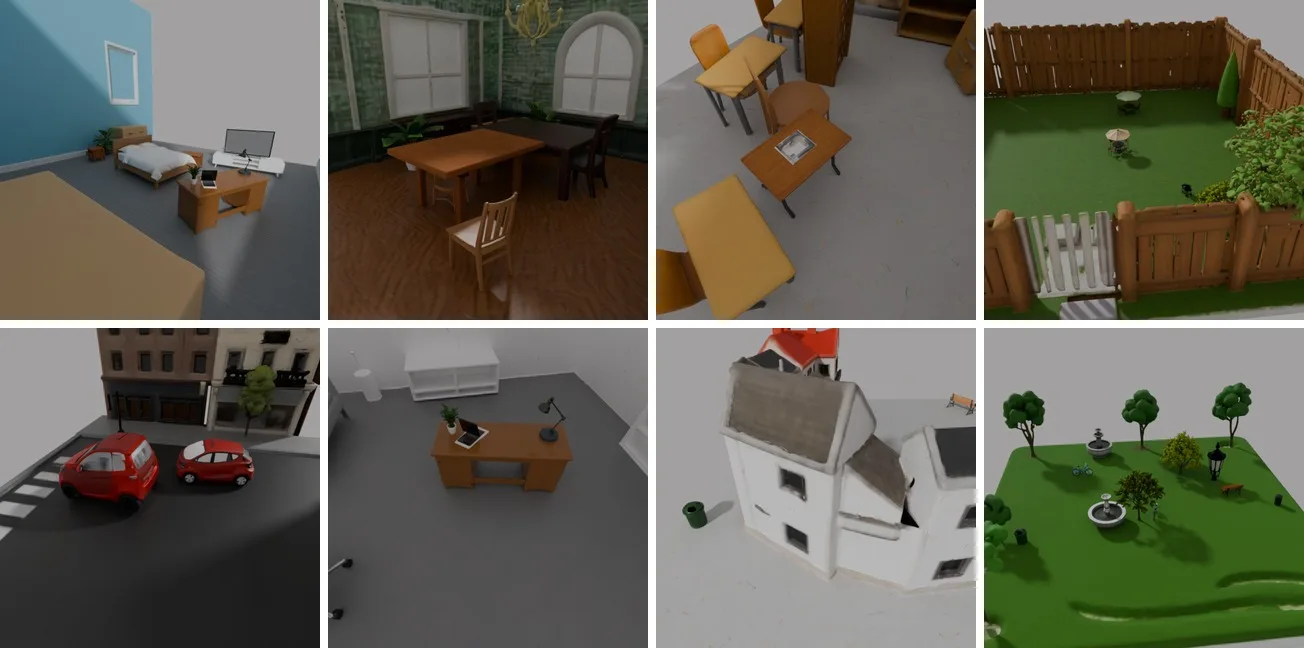
كشف التوسع في النطاق عن مشكلة كانت مخفية في الدراسة الأولية، إذ تتجاهل نماذج الصور غالبًا طلب "دون أثاث" وترسم غرفًا مؤثثة على أي حال، وهو ما يتعارض مع الهدف من عملية التفكيك. يفحص مرشِّحنا الهندسي كل غرفة من منظور علوي ويقيس مساحة الأرضية الشاغرة فيها، وقد أبقى على 537 بيئة من أصل 1,493.
3. توليد المشاهد، لا الكائنات
3.1 تسلسل واحد للغرفة بأكملها
تتشارك جميع مكونات المشهد، أي بيئة واحدة وما يصل إلى ثلاثين كائنًا، تسلسلًا رمزيًا واحدًا عبر مولّد ثلاثي الأبعاد مُجمَّد. ويمكن لكل كائن أن ينتبه إلى الكائنات الأخرى وإلى الغرفة من حوله.
3.2 الانطلاق مما يعرفه النموذج مسبقًا
تُميّز التضمينات القابلة للتعلم للنوع والخانة بين البيئة والكائنات، وبين الكائنات وبعضها البعض. تبدأ هذه التضمينات من الصفر، لذا يتصرف النموذج في خطوة التدريب الأولى تمامًا مثل النموذج المُدرَّب مسبقًا. ولا يُدرَّب سوى المحوّلات خفيفة الوزن.
3.3 التحسين في الإطار الخاص بالكائن
تشغل الكائنات بضعة فوكسلات فقط من شبكة بحجم الغرفة. وينقل التحسين كل كائن إلى إطاره المعياري الخاص، ثم يعيد توليده مع الانتباه إلى المشهد بأكمله، ويعيده إلى مكانه بالضبط.
3.4 البنية
- النموذج الأساسي. TRELLIS.2-4B [1]، وهو مولّد صور إلى نماذج ثلاثية الأبعاد بفوكسلات متفرقة، مع محوّلات مطابقة التدفق [3] للهيكل والشكل والملمس.
- المحوّلات. LoRA [2] بالرتبة 32 على كل طبقة انتباه وطبقة MLP، أي 37 مليون مُعامِل قابل للتدريب على هيكل أساسي مُجمَّد.
- الانتباه المُعامَل. يستغرق الانتباه الكثيف لمشهد من 30 مكونًا 43 ثانية لكل خطوة تدريب. في تصميمنا، تنتبه خمس طبقات من أصل ثلاثين إلى المشهد بأكمله، بينما تنتبه البقية إلى داخل كل مكون، وهو النظام الذي دُرِّب عليه النموذج الأساسي مسبقًا. وهذا أرخص بنحو 3 أضعاف.
4. النتائج
4.1 المواءمة مع الكاميرا
يتطلب التقييم في العالم الحقيقي تنبؤات في الإطار المتري للكاميرا. نسجل المشهد المُولَّد على العُمق المرئي ونُقيّم كل وضعية مرشحة بناءً على اتساق خريطة العُمق. بدون ذلك، يؤدي خطأ في المقياس بنسبة 5% وحده إلى خسارة 26 نقطة من درجة F.
4.2 توسيع نطاق النموذج
تتحسن LifeSim Interiors مع زيادة الحوسبة التدريبية. ففي المشاهد الاصطناعية المحجوزة، ترتفع درجة F عند 10 سم (الأعلى هو الأفضل) عند كل نقطة تفتيش، وتكسب حوالي تسع نقاط كلما تضاعف التدريب (الجدول 1).
| خطوات التدريب | 250 | 500 | 1,000 | 1,500 |
|---|---|---|---|---|
| درجة F عند 0.1 | 4.3% | 11.6% | 21.3% | 26.8% |
خط المعالجة نفسه سليم: ففك تشفير البيانات الكامنة الفعلية وتقييمها كتنبؤات يعطي درجة F بنسبة 100%. كما يحقق النموذج نفس الدرجة تقريبًا في المشاهد التي تدرب عليها والمشاهد الجديدة، مما يعني أنه لا يزال بحاجة إلى مزيد من التدريب، وليس مُفرِط التخصيص. لقد استهلك النموذج جزءًا صغيرًا فقط من الحوسبة التدريبية التي تُخصَص عادةً لهذا النوع من الأساليب.
5. الخطوات التالية
النموذج ما زال يتعلم، لكننا توقفنا مبكرًا. الخطوات الثلاث التالية هي: تدريب أطول، وتكوين غرف أكثر واقعية، وتوليد بيئات فارغة تمامًا.
لقد قطعنا شوطًا بالفعل في الخطوة الثانية. فمختبرنا لتحويل النص إلى تصميم داخلي يكتب مخططات الغرف باستخدام نموذج لغوي كبير ويفحص كل أصل بنموذج رؤية. وتجربتنا التالية هي إدخال هذه الغرف إلى مصنع العوالم.
النموذج المركزي مدمج، لكن معظم العمل الحقيقي يدور حوله: صناعة عوالم قابلة للتصديق، وتصييرها بكفاءة، وقياس النتائج بأمانة بمقارنتها بالعالم الحقيقي. سنشارك المزيد من التفاصيل مع نضج LifeSim Interiors.
المراجع
- Xiang, J., Chen, X., Xu, S., Wang, R., Lv, Z., et al. Native and Compact Structured Latents for 3D Generation. arXiv:2512.14692, 2025.
- Hu, E. J., Shen, Y., Wallis, P., Allen-Zhu, Z., Li, Y., Wang, S., Wang, L., Chen, W. LoRA: Low-Rank Adaptation of Large Language Models. arXiv:2106.09685, 2021.
- Lipman, Y., Chen, R. T. Q., Ben-Hamu, H., Nickel, M., Le, M. Flow Matching for Generative Modeling. arXiv:2210.02747, 2022.
الاقتباس
يرجى الاستشهاد بهذا العمل على النحو التالي:
@misc{lifesim2026interiors,
  title  = {LifeSim Interiors: From One Photo to a 3D Room You Can Take Apart},
  author = {{João Nobre} and {Cris Lenta}},
  year   = {2026},
  month  = {oct},
  url    = {https://lifesim.com/research/interiors}
}