


 English
 Español
 Português
 Bahasa Indonesia
 Română
 العربية
 Français
 Deutsch
 Русский
 Italiano
 Polski
 한국어
 日本語
 简体中文
 Türkçe
 Kiswahili
 বাংলা
 Filipino
10 अक्टूबर 2026
LifeSim इंटीरियर्स: एक फ़ोटो से 3D कमरा, जिसे आप अलग-अलग कर सकते हैं
सार
हम पेश करते हैं LifeSim Interiors, एक रिसर्च सिस्टम जो एक तस्वीर से एक विघटित 3D सीन बनाता है: एक माहौल और हर चीज़ अपने अलग मेश के तौर पर, और हर चीज़ अपनी सही जगह पर। यह सिस्टम TRELLIS.2 [1] का ही विस्तार है, जो एक ही शेयर्ड फ़्रेम में एक माहौल और तीस चीज़ों तक को एक साथ बना सकता है। चूँकि विघटित 3D कमरों का कोई बड़ा डेटासेट मौजूद नहीं है, इसलिए हमने एक पाइपलाइन बनाई जिसने 5,500 एसेट बनाए और 10,216 भौतिक रूप से मान्य ट्रेनिंग सीन तैयार किए। अलग रखे गए सिंथेटिक सीन पर, 10 सेमी पर F-स्कोर 4.3% से बढ़कर 26.8% हो गया, जब ट्रेनिंग 250 से 1,500 स्टेप्स तक बढ़ी, और कर्व में कोई ठहराव नहीं दिखा।
1. परिचय
एक 3D सीन सिर्फ़ एक सतह से कहीं ज़्यादा है। यह एक कमरा है जिसे आप फिर से सजा सकते हैं, एक सोफ़ा है जिसे आप हटा सकते हैं, एक शेल्फ़ है जिसे आप बदल सकते हैं। जो सिस्टम स्पेस को समझता है, उसे सिर्फ़ एक ठहरे हुए मेश को नहीं, बल्कि इन हिस्सों को रिकवर करना होता है।
LifeSim Interiors एक माहौल और हर चीज़ को उसके अपने मेश के तौर पर बनाता है। यह ऑब्जेक्ट-टू-सीन डिस्टिलेशन और Microsoft के TRELLIS.2 [1] पर हुए हालिया काम पर आधारित है। हमने Google Cloud पर दो दिनों में इसके आस-पास पूरा स्टैक बनाया। हमारे योगदान हैं:
- एक वर्ल्ड फ़ैक्टरी: टेक्स्ट से इमेज, इमेज से 3D एसेट, और एसेट से बड़े पैमाने पर भौतिक रूप से मान्य कमरे बनते हैं (सेक्शन 2)।
- एक सीन जनरेटर: एक 3D ऑब्जेक्ट मॉडल जिसे एक ही शेयर्ड फ़्रेम में एक माहौल और कई चीज़ों को एक साथ बनाने के लिए बढ़ाया गया है (सेक्शन 3)।
- ऑब्जेक्ट रिफ़ाइनमेंट: हर चीज़ को उसके अपने फ़्रेम में ज़्यादा डिटेल के साथ दोबारा बनाया जाता है, जो बाकी सीन पर निर्भर करता है (सेक्शन 3.3)।
- माप: एक सार्वजनिक बेंचमार्क प्रोटोकॉल, साथ ही बनाए गए सीन को असली कैमरे के फ़्रेम में रखने का हमारा अपना तरीका (सेक्शन 4)।
2. दुनियाओं का निर्माण
अलग-अलग हिस्सों में बँटे 3D कमरों का कोई बड़ा डेटासेट नहीं है, इसलिए हम एक बनाते हैं। एक पहले से प्रशिक्षित ऑब्जेक्ट जनरेटर हिस्से बनाता है, और हमारी पाइपलाइन उन्हें कमरों में जोड़ती है।
2.1 शब्दों से हिस्सों तक
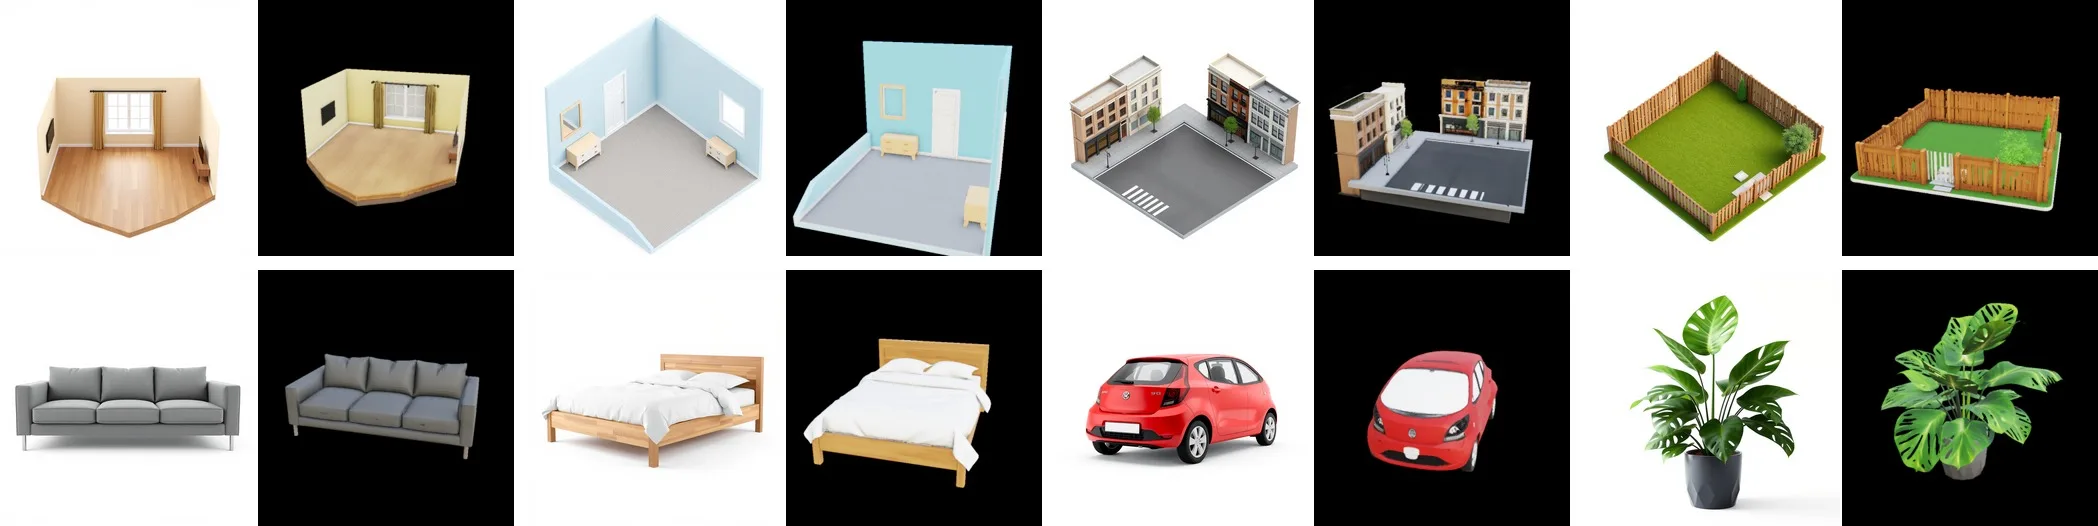
हर चीज़ और हर कमरा एक छोटे विवरण के रूप में शुरू होता है। एक इमेज मॉडल उसे बनाता है, और TRELLIS.2 उस ड्रॉइंग को एक टेक्सचर्ड 3D एसेट में बदल देता है (चित्र 1)।
2.2 सबसे मुश्किल एसेट: एक खाली कमरा
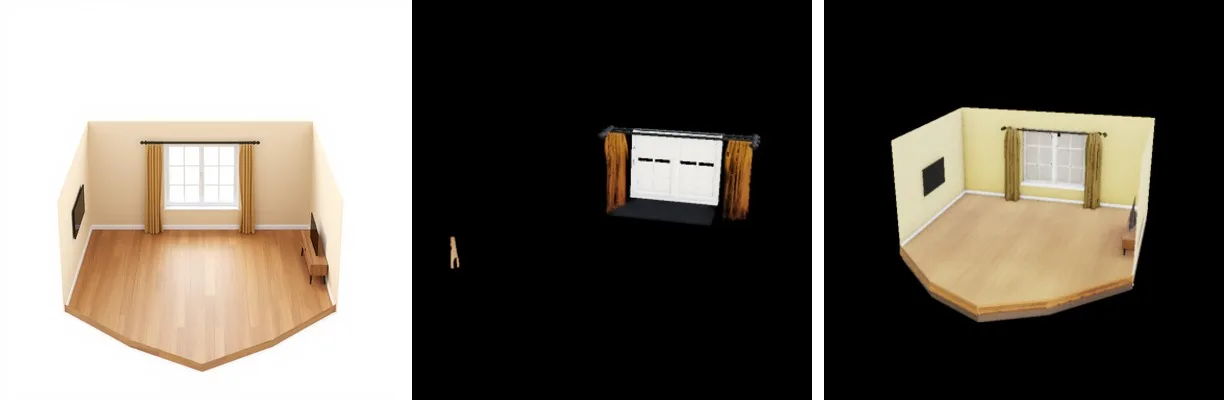
एक खाली कमरा बनाना हैरानी की बात है कि बहुत मुश्किल है। स्टैंडर्ड बैकग्राउंड रिमूवल हल्की दीवारों और फ़र्श को बैकग्राउंड मान लेता है, इसलिए हमारा पहला “खाली लिविंग रूम” एक खिड़की और दो पर्दों के रूप में वापस आया। रंग के आधार पर माहौल को मास्क करने से पूरा कमरा बना रहता है (चित्र 2)।
2.3 भौतिकी का पालन करने वाले कमरे
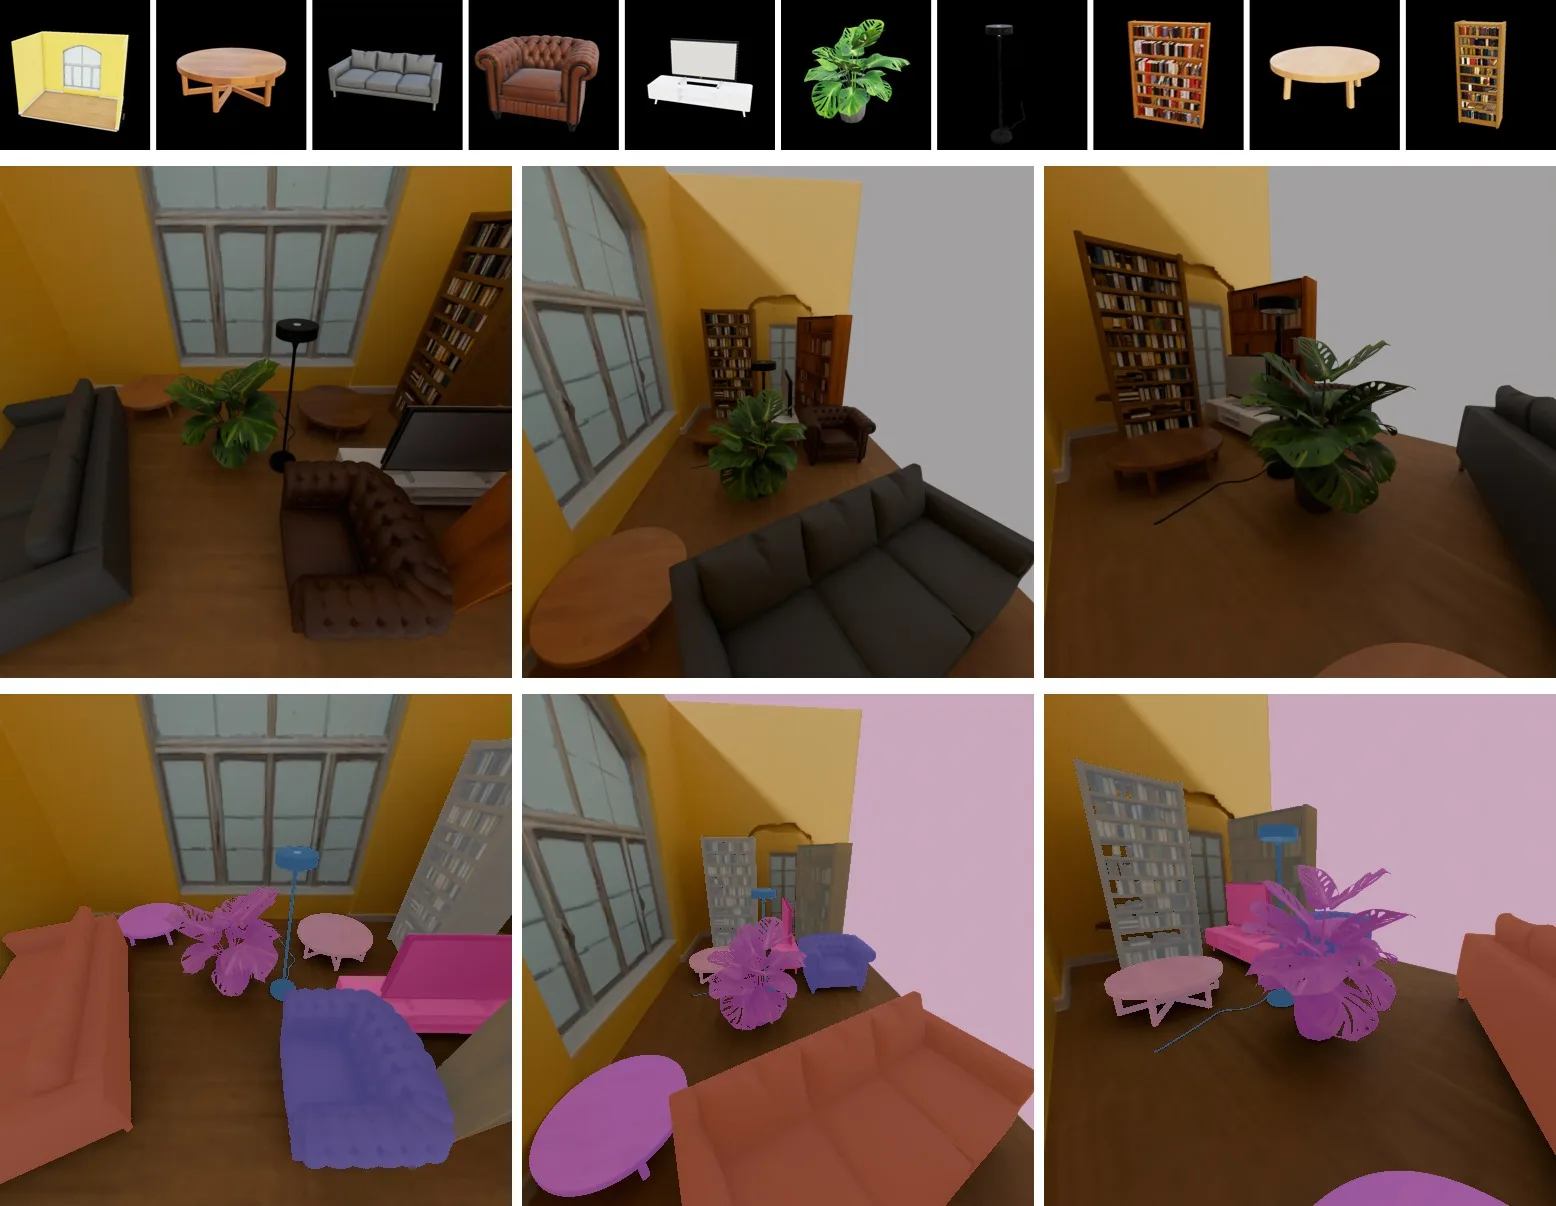
हर चीज़ को एक असली सपोर्ट सतह पर गिराया जाता है। जो कुछ भी तैरता है या दीवार के आर-पार जाता है, उसे अस्वीकार कर दिया जाता है, और टकराव को हल किया जाता है। कैमरे सजाए गए क्षेत्र पर निशाना साधते हैं, जिसमें फ़ील्ड ऑफ़ व्यू हर चीज़ के लिए फ़िट होता है, और केवल वे व्यू रखे जाते हैं जिनमें हर चीज़ दिखाई देती है (चित्र 3)।
2.4 बड़े पैमाने पर
एक घंटे से भी कम समय में, फ़ैक्टरी ने 16 तरह के कमरों और 89 चीज़ों की श्रेणियों में 5,500 एसेट बनाए। इनसे 10,216 ट्रेनिंग सीन तैयार किए गए, जिनमें से हर एक में लगभग छह चीज़ें थीं (चित्र 4)।
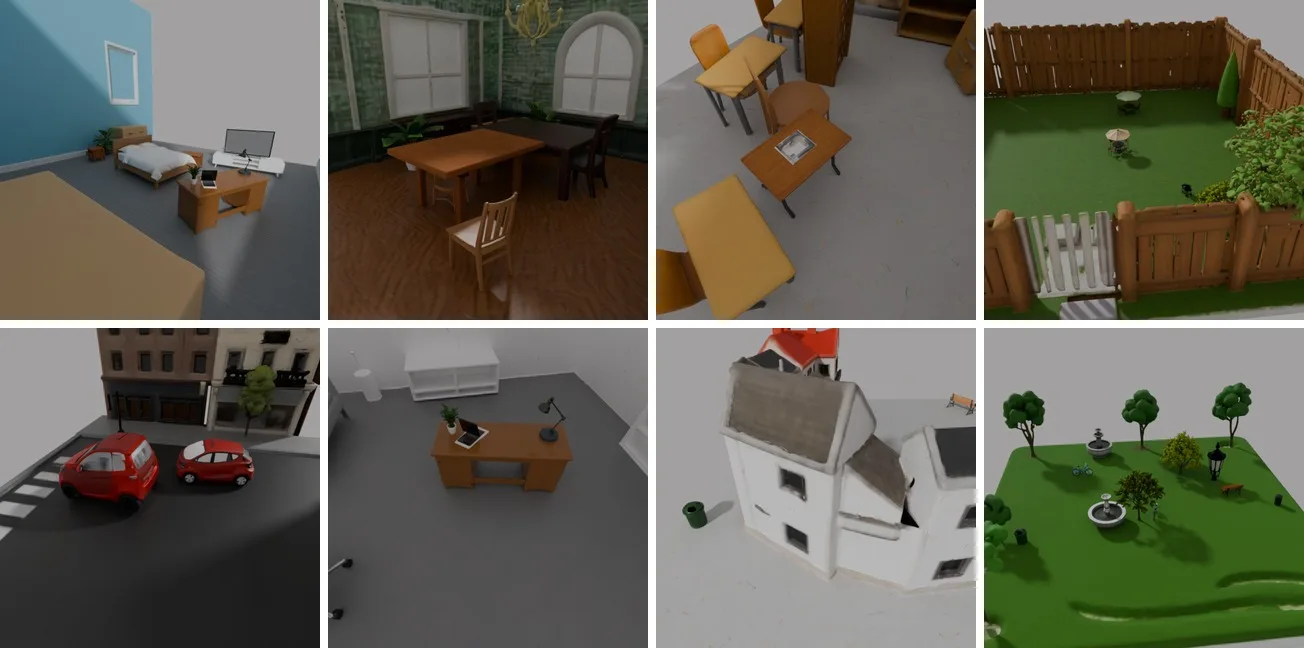
बड़े पैमाने पर काम करने से एक ऐसी समस्या सामने आई जो छोटे पायलट प्रोजेक्ट में छिपी थी: इमेज मॉडल अक्सर “कोई फ़र्नीचर नहीं” को अनदेखा कर देते हैं और फिर भी सजे-सजाए कमरे बना देते हैं, जो विघटन के सिद्धांत के बिलकुल विपरीत सिखाता है। हमारा ज्यामितीय फ़िल्टर हर कमरे को ऊपर से देखता है और मापता है कि फ़र्श का कितना हिस्सा खाली है। इसने 1,493 में से 537 माहौल को रखा।
3. सीन बनाना, चीज़ें नहीं
3.1 पूरे कमरे के लिए एक क्रम
एक सीन के सभी कंपोनेंट, एक माहौल और तीस चीज़ों तक, एक फ़्रोज़ेन 3D जनरेटर पर एक ही टोकन क्रम साझा करते हैं। हर चीज़ हर दूसरी चीज़ और उसके आस-पास के कमरे पर ध्यान दे सकती है।
3.2 मॉडल जो पहले से जानता है, उससे शुरुआत
सीखने योग्य टाइप और स्लॉट एम्बेडिंग माहौल को चीज़ों से और चीज़ों को एक-दूसरे से अलग करते हैं। वे शून्य से शुरू होते हैं, इसलिए पहले ट्रेनिंग स्टेप में मॉडल ठीक पहले से प्रशिक्षित मॉडल की तरह ही व्यवहार करता है। केवल हल्के एडेप्टर को प्रशिक्षित किया जाता है।
3.3 चीज़ के अपने फ़्रेम में रिफ़ाइनमेंट
चीज़ें कमरे के आकार के ग्रिड के केवल कुछ वोक्सेल घेरती हैं। रिफ़ाइनमेंट हर चीज़ को उसके अपने सामान्यीकृत फ़्रेम में ले जाता है, पूरे सीन पर ध्यान देते हुए उसे दोबारा बनाता है, और उसे ठीक वहीं वापस रख देता है जहाँ वह थी।
3.4 आर्किटेक्चर
- बेस मॉडल। TRELLIS.2-4B [1], संरचना, आकार और बनावट के लिए फ़्लो-मैचिंग ट्रांसफ़ॉर्मर [3] के साथ एक स्पार्स-वोक्सेल इमेज-टू-3D जनरेटर।
- एडेप्टर। हर अटेंशन और MLP लेयर पर रैंक 32 पर LoRA [2]: एक फ़्रोज़ेन बैकबोन पर 37M प्रशिक्षित करने योग्य पैरामीटर।
- फ़ैक्टराइज़्ड अटेंशन। 30-कंपोनेंट वाले सीन पर डेंस अटेंशन में प्रति ट्रेनिंग स्टेप 43 सेकंड लगते हैं। हमारे डिज़ाइन में, तीस में से पाँच लेयर पूरे सीन पर ध्यान देती हैं और बाकी हर कंपोनेंट के भीतर ध्यान देती हैं, यह वही व्यवस्था है जिसमें बेस मॉडल को पहले से प्रशिक्षित किया गया था। यह लगभग 3 गुना सस्ता है।
4 नतीजे
4.1 कैमरे के साथ संरेखण
वास्तविक दुनिया के मूल्यांकन के लिए कैमरे के मीट्रिक फ़्रेम में पूर्वानुमान की ज़रूरत होती है। हम बनाए गए सीन को दिखाई देने वाली गहराई से रजिस्टर करते हैं और हर कैंडिडेट पोज़ को डेप्थ-मैप की संगति के आधार पर स्कोर करते हैं। इसके बिना, अकेले 5% स्केल की गड़बड़ी से F-स्कोर में 26 अंकों का नुक़सान होता है।
4.2 मॉडल स्केलिंग
LifeSim Interiors ट्रेनिंग कंप्यूट के साथ बेहतर होता है। अलग रखे गए सिंथेटिक सीन पर, 10 सेमी पर F-स्कोर (जितना ज़्यादा उतना बेहतर) हर चेकपॉइंट पर बढ़ता है, और हर बार ट्रेनिंग दोगुनी होने पर लगभग नौ अंक हासिल करता है (तालिका 1)।
| ट्रेनिंग स्टेप्स | 250 | 500 | 1,000 | 1,500 |
|---|---|---|---|---|
| F-स्कोर@0.1 | 4.3% | 11.6% | 21.3% | 26.8% |
पाइपलाइन अपने आप में सही है: ग्राउंड-ट्रुथ लेटेंट को डिकोड करना और उन्हें पूर्वानुमान के रूप में स्कोर करना 100% का F-स्कोर देता है। मॉडल उन सीन पर भी लगभग उतना ही स्कोर करता है जिन पर उसे प्रशिक्षित किया गया था, जितना कि नए सीन पर, इसलिए यह अभी भी कम प्रशिक्षित है, ओवरफ़िट नहीं। मॉडल को उस ट्रेनिंग कंप्यूट का एक छोटा सा हिस्सा ही मिला है जो इस तरह की विधि को आमतौर पर दिया जाता है।
5. आगे क्या?
मॉडल सीख रहा है; हमने जल्दी रोक दिया। आगे तीन कदम हैं: ज़्यादा देर तक प्रशिक्षित करना, ज़्यादा यथार्थवादी कमरे बनाना, और सचमुच खाली माहौल बनाना।
दूसरे कदम पर हम पहले ही आगे बढ़ चुके हैं। हमारी टेक्स्ट-टू-इंटीरियर लैब एक LLM के साथ कमरे के लेआउट लिखती है और हर एसेट को एक विज़न मॉडल से जाँचती है। उन कमरों को वर्ल्ड फ़ैक्टरी में डालना हमारा अगला प्रयोग है।
केंद्र में मौजूद मॉडल कॉम्पैक्ट है। ज़्यादातर असली काम उसके आस-पास होता है: विश्वसनीय दुनिया बनाना, उन्हें कुशलता से रेंडर करना, और परिणामों को ईमानदारी से असली दुनिया के मुक़ाबले मापना। जैसे-जैसे LifeSim Interiors परिपक्व होगा, हम और जानकारी साझा करेंगे।
संदर्भ
- शियांग, जे., चेन, एक्स., शू, एस., वांग, आर., ल्यू, ज़ेड., और अन्य। 3D जनरेशन के लिए नेटिव और कॉम्पैक्ट स्ट्रक्चर्ड लेटेंट। arXiv:2512.14692, 2025।
- हू, ई. जे., शेन, वाई., वालिस, पी., एलन-झू, जेड., ली, वाई., वांग, एस., वांग, एल., चेन, डब्ल्यू. LoRA: बड़े भाषा मॉडल का लो-रैंक अनुकूलन. arXiv:2106.09685, 2021.
- लिपमैन, वाई., चेन, आर. टी. क्यू., बेन-हामू, एच., निकल, एम., ले, एम. जेनरेटिव मॉडलिंग के लिए फ्लो मैचिंग. arXiv:2210.02747, 2022.
उद्धरण
कृपया इस काम को इस तरह से उद्धृत करें:
@misc{lifesim2026interiors,
  title  = {LifeSim Interiors: From One Photo to a 3D Room You Can Take Apart},
  author = {{João Nobre} and {Cris Lenta}},
  year   = {2026},
  month  = {oct},
  url    = {https://lifesim.com/research/interiors}
}