


 English
 Español
 Português
 Bahasa Indonesia
 Română
 हिन्दी
 العربية
 Français
 Deutsch
 Русский
 Italiano
 Polski
 한국어
 日本語
 Türkçe
 Kiswahili
 বাংলা
 Filipino
2026年10月10日
LifeSim 室内设计:一张照片生成可拆解的 3D 房间
摘要
我们在此介绍 LifeSim Interiors,一个能从单张图片生成可分解 3D 场景的研究系统。该场景包含一个环境,以及多个拥有独立网格且位于正确位置的物体。此系统扩展了 TRELLIS.2 [1],可在一个共享框架内共同生成一个环境及多达三十个物体。由于目前尚无大型的、已分解的 3D 室内场景数据集,我们构建了一条管线,生成了 5500 项资产,并合成了 10216 个符合物理法则的训练场景。在留存的合成场景上,当训练步数从 250 步增至 1500 步时,10 厘米标准下的 F1 分数从 4.3% 升至 26.8%,且增长曲线未呈现平台期。
1 引言
3D 场景不仅是其表面。它是一个可以重排布局的房间,一张可以搬动的沙发,一个可以替换的置物架。一个能理解空间的系统必须能复原出这些组成部分,而不只是一个单一的静态网格。
LifeSim Interiors 可生成一个环境,以及多个拥有独立网格的物体。它基于近期的“物体到场景”蒸馏研究及微软的 TRELLIS.2 [1] 构建。我们在两天内于 Google Cloud 上构建了其完整技术栈。我们的贡献如下:
- 世界工厂:将文本变为图像,图像变为 3D 资产,资产变为符合物理法则的房间,并实现规模化(第 2 节)。
- 场景生成器:一个扩展的 3D 物体模型,可在一个共享框架内共同生成一个环境和多个物体(第 3 节)。
- 物体精炼:在以场景其余部分为条件的情况下,在每个物体自身的框架内以更高细节重新生成(第 3.3 节)。
- 测量:一个公开的基准协议,以及我们将生成场景置于真实相机框架内的方法(第 4 节)。
2 世界的制造
目前没有大型的、已分解为独立部分的 3D 室内场景数据集,因此我们自己制造了一个。一个预训练的物体生成器负责制造部件,再由我们的管线将它们组装成房间。
2.1 从文本到部件
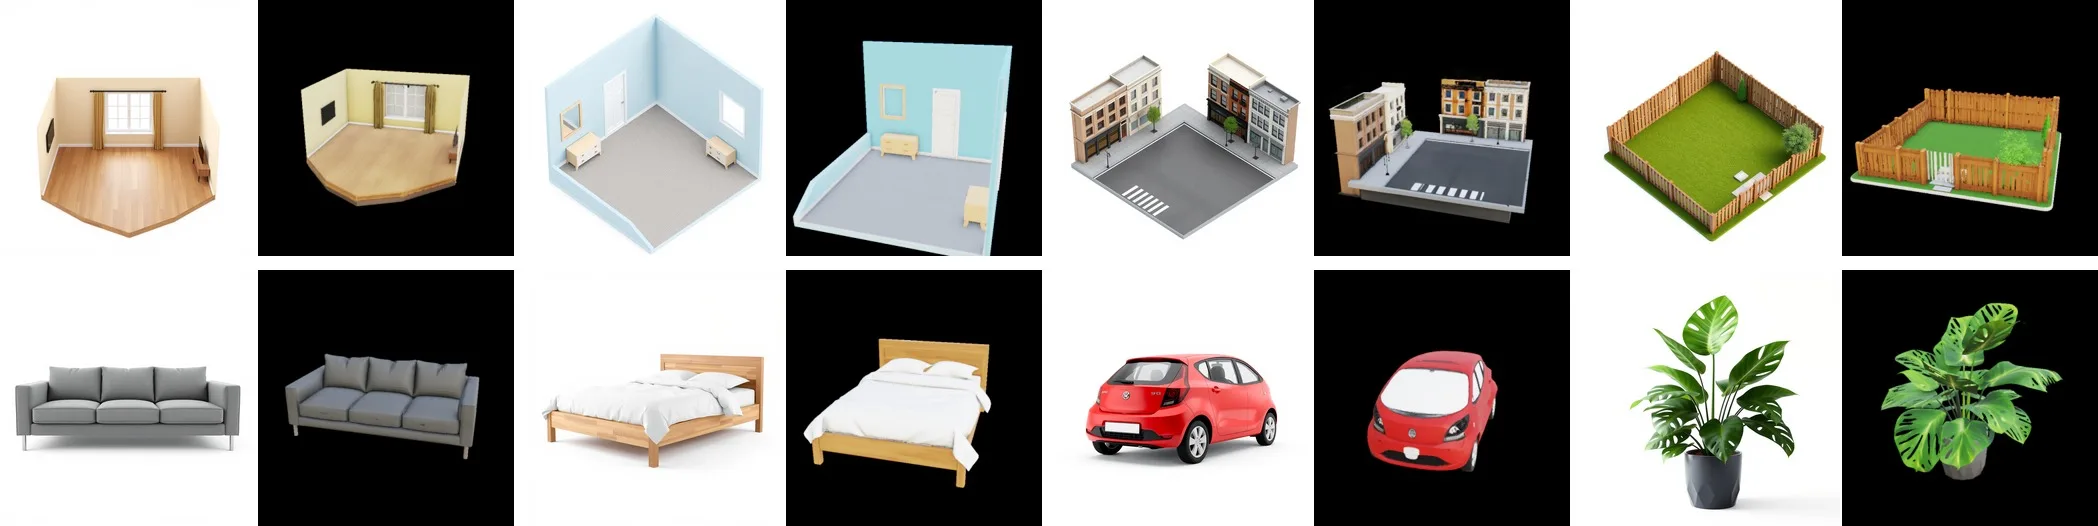
每个物体和每个房间都始于一段简短的描述。图像模型将其绘制出来,然后 TRELLIS.2 将图画提升为带纹理的 3D 资产(图 1)。
2.2 最难的资产是空房间
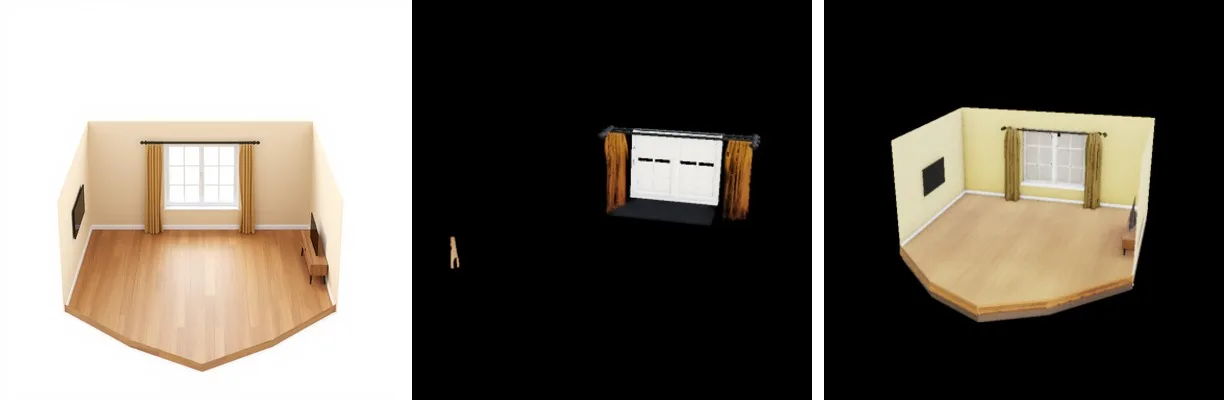
生成一个空房间出奇地困难。标准的背景移除会将浅色的墙壁和地板当作背景处理,因此我们生成的第一个“空客厅”只剩下一个窗户和两扇窗帘。通过颜色对环境进行遮罩处理,可以保持整个房间的完整性(图 2)。
2.3 符合物理法则的房间
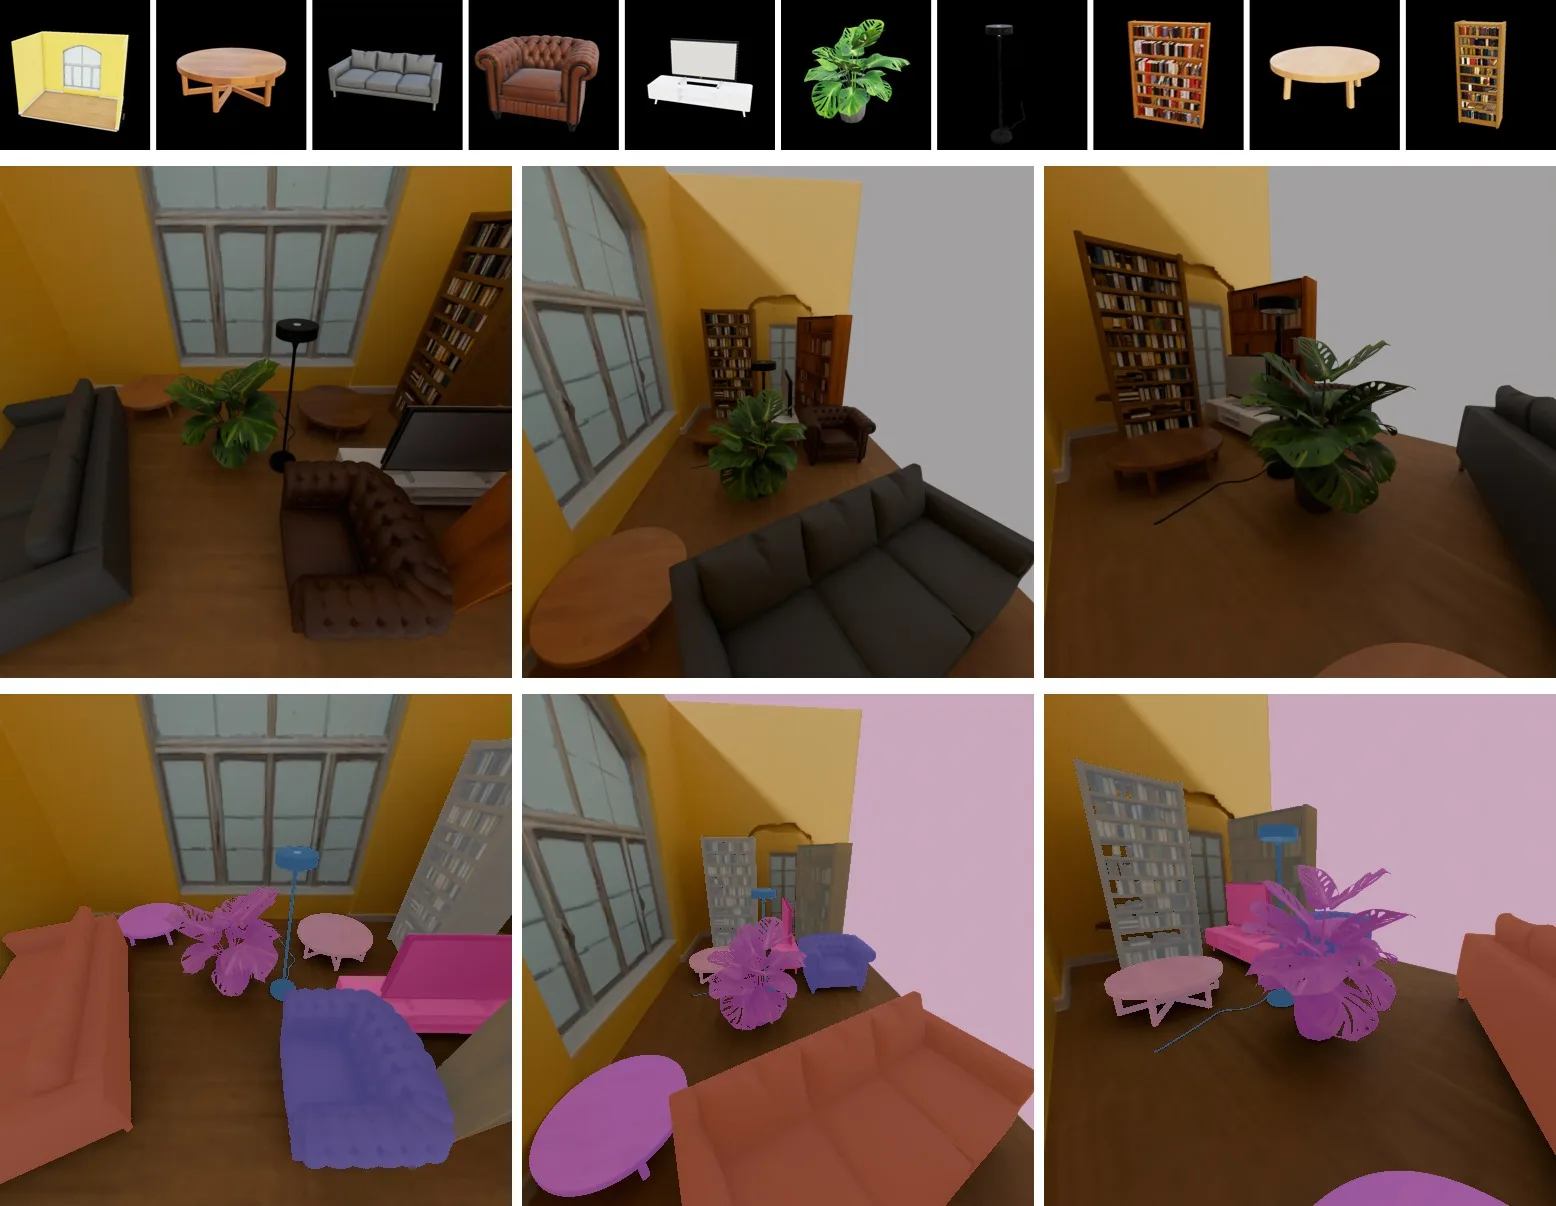
每个物体都被放置在真实的支撑面上。任何悬浮或穿墙的物体都会被舍弃,碰撞问题也会得到解决。相机会对准布置好的区域,视野会适配所有物体,只有那些能看到所有物体的视图才会被保留(图 3)。
2.4 规模化
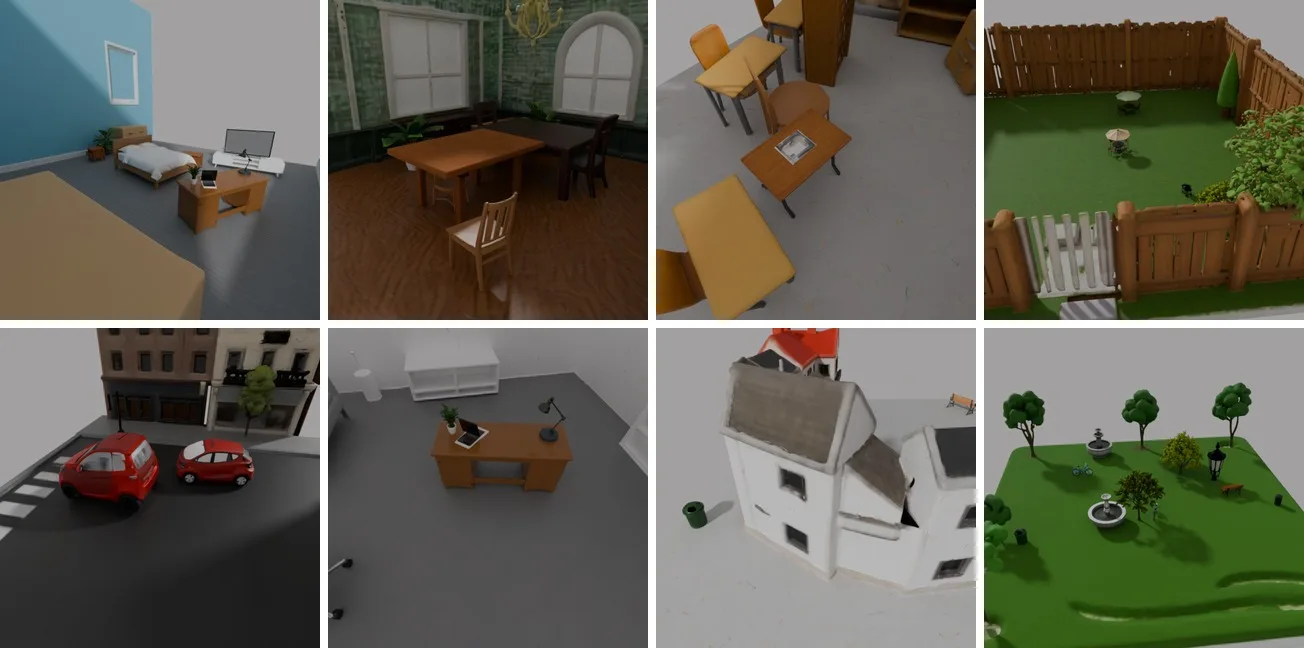
在不到一小时内,该工厂就生产了 5500 项资产,涵盖 16 种房间类型和 89 个物体类别。利用这些资产,它合成了 10216 个训练场景,每个场景平均包含约六个物体(图 4)。
规模化暴露了试点阶段隐藏的一个问题:图像模型常会忽略“无家具”的指令,画出带家具的房间,这与分解的目标背道而驰。我们的几何过滤器会俯视每个房间,测量地板的空闲面积。它在 1493 个环境中保留了 537 个。
3 生成场景,而非物体
3.1 整个房间共享一个序列
场景的所有组件——一个环境和多达三十个物体——在一个固定的 3D 生成器上共享同一个令牌序列。每个物体都可以注意到其他所有物体及其周围的房间。
3.2 从模型的已有知识出发
可学习的类型和槽位嵌入将环境与物体区分开,也将物体彼此区分开。它们从零开始,因此在第一个训练步骤中,模型的行为与预训练模型完全相同。我们只训练轻量级适配器。
3.3 在物体自身框架内进行精炼
在房间大小的网格中,物体只占据少数体素。精炼过程会将每个物体移至其自身的归一化框架中,在关注整个场景的同时重新生成它,然后将其精确地放回原位。
3.4 架构
- 基础模型。 TRELLIS.2-4B [1],一个稀疏体素的“图像到 3D”生成器,使用流匹配变换器 [3] 生成结构、形状和纹理。
- 适配器。 在每个注意力层和 MLP 层上使用秩为 32 的 LoRA [2]:在一个固定的主干网络上,有 3700 万个可训练参数。
- 分解式注意力。 对一个含 30 个组件的场景进行密集注意力计算,每个训练步骤耗时 43 秒。在我们的设计中,三十个层级中有五层进行跨场景注意力计算,其余层级则在各组件内部计算,这与基础模型的预训练机制一致。这种方式的成本降低了约 3 倍。
4. 结果
4.1 与相机对齐
真实世界评估需要在相机的度量框架内进行预测。我们将生成的场景与可见深度图对齐,并根据深度图的一致性为每个候选姿态评分。若无此步骤,仅 5% 的缩放误差就会导致 F1 分数降低 26 分。
4.2 模型扩展
LifeSim Interiors 的性能随训练计算量的增加而提升。在留存的合成场景上,10 厘米标准下的 F1 分数(越高越好)在每个检查点都会攀升,训练量每翻一倍,分数约增加 9 分(表 1)。
| 训练步数 | 250 | 500 | 1,000 | 1,500 |
|---|---|---|---|---|
| F-score@0.1 | 4.3% | 11.6% | 21.3% | 26.8% |
管线本身是可靠的:解码基准真相的潜在变量并将其作为预测进行评分,F1 分数可达 100%。模型在训练过的场景和新场景上的得分也大致相同,说明模型仍处于训练不足状态,而非过拟合。该模型所用的训练计算量仅是此类方法常规用量的一小部分。
5 后续工作
模型仍在学习中,我们只是提前停止了训练。后续有三个步骤:延长训练时间,合成更真实的房间,以及生成真正空旷的环境。
我们在第二步上已占得先机。我们的“文本到室内”实验室使用大语言模型编写房间布局,并用视觉模型检查每项资产。将这些房间输入世界工厂,是我们的下一个实验。
处于核心地位的模型是紧凑的。大部分实际工作都在其周边展开:制造可信的世界,高效地渲染它们,并以真实世界为基准诚实地测量结果。随着 LifeSim Interiors 的成熟,我们将分享更多信息。
参考文献
- Xiang, J., Chen, X., Xu, S., Wang, R., Lv, Z., et al. Native and Compact Structured Latents for 3D Generation. arXiv:2512.14692, 2025.
- Hu, E. J., Shen, Y., Wallis, P., Allen-Zhu, Z., Li, Y., Wang, S., Wang, L., Chen, W. LoRA: Low-Rank Adaptation of Large Language Models. arXiv:2106.09685, 2021.
- Lipman, Y., Chen, R. T. Q., Ben-Hamu, H., Nickel, M., Le, M. Flow Matching for Generative Modeling. arXiv:2210.02747, 2022.
引用
引用本文请注明:
@misc{lifesim2026interiors,
  title  = {LifeSim Interiors: From One Photo to a 3D Room You Can Take Apart},
  author = {{João Nobre} and {Cris Lenta}},
  year   = {2026},
  month  = {oct},
  url    = {https://lifesim.com/research/interiors}
}