


 English
 Español
 Português
 Bahasa Indonesia
 Română
 हिन्दी
 العربية
 Deutsch
 Русский
 Italiano
 Polski
 한국어
 日本語
 简体中文
 Türkçe
 Kiswahili
 বাংলা
 Filipino
10 oct. 2026
Intérieurs LifeSim : d'une photo à une pièce 3D que tu peux démonter
Résumé
Nous présentons LifeSim Interiors, un système de recherche qui génère une scène 3D décomposée à partir d'une seule image : un environnement et chaque objet qui le compose, sous forme de maillages distincts et placés correctement. Le système étend TRELLIS.2 [1] pour générer conjointement un environnement et jusqu'à trente objets dans un repère partagé. Faute de grand jeu de données de pièces 3D décomposées, nous avons créé une chaîne de traitement qui a produit 5 500 ressources et composé 10 216 scènes d'entraînement physiquement valides. Sur des scènes de synthèse non vues à l'entraînement, le F-score à 10 cm passe de 4,3 % à 26,8 % lorsque l'entraînement passe de 250 à 1 500 itérations, et la courbe ne montre aucun plateau.
1. Introduction
Une scène 3D est plus qu'une simple surface. C'est une pièce que l'on peut réarranger, un canapé que l'on peut déplacer, une étagère que l'on peut remplacer. Un système qui comprend l'espace doit retrouver ces éléments, et pas seulement un maillage unique et figé.
LifeSim Interiors génère un environnement ainsi que chaque objet en tant que maillage distinct. Il s'appuie sur des travaux récents sur la distillation objet-scène et sur TRELLIS.2 de Microsoft [1]. Nous avons construit l'ensemble de la pile applicative en deux jours sur Google Cloud. Nos contributions sont les suivantes :
- Une usine à mondes : du texte aux images, des images aux ressources 3D, et des ressources 3D aux pièces physiquement valides, le tout à grande échelle (section 2).
- Un générateur de scènes : un modèle d'objet 3D étendu pour générer conjointement un environnement et de nombreux objets, dans un repère partagé unique (section 3).
- Raffinement des objets : chaque objet est régénéré dans son propre repère avec plus de détails, en fonction du reste de la scène (section 3.3).
- Mesure : un protocole de test public, ainsi que notre propre méthode pour placer les scènes générées dans le repère d'une caméra réelle (section 4).
2. Fabrication de mondes
Il n'existe pas de grand jeu de données de pièces 3D décomposées en éléments distincts, alors nous en fabriquons un. Un générateur d'objets pré-entraîné crée les éléments, et notre chaîne de traitement les assemble en pièces.
2.1 Des mots aux éléments
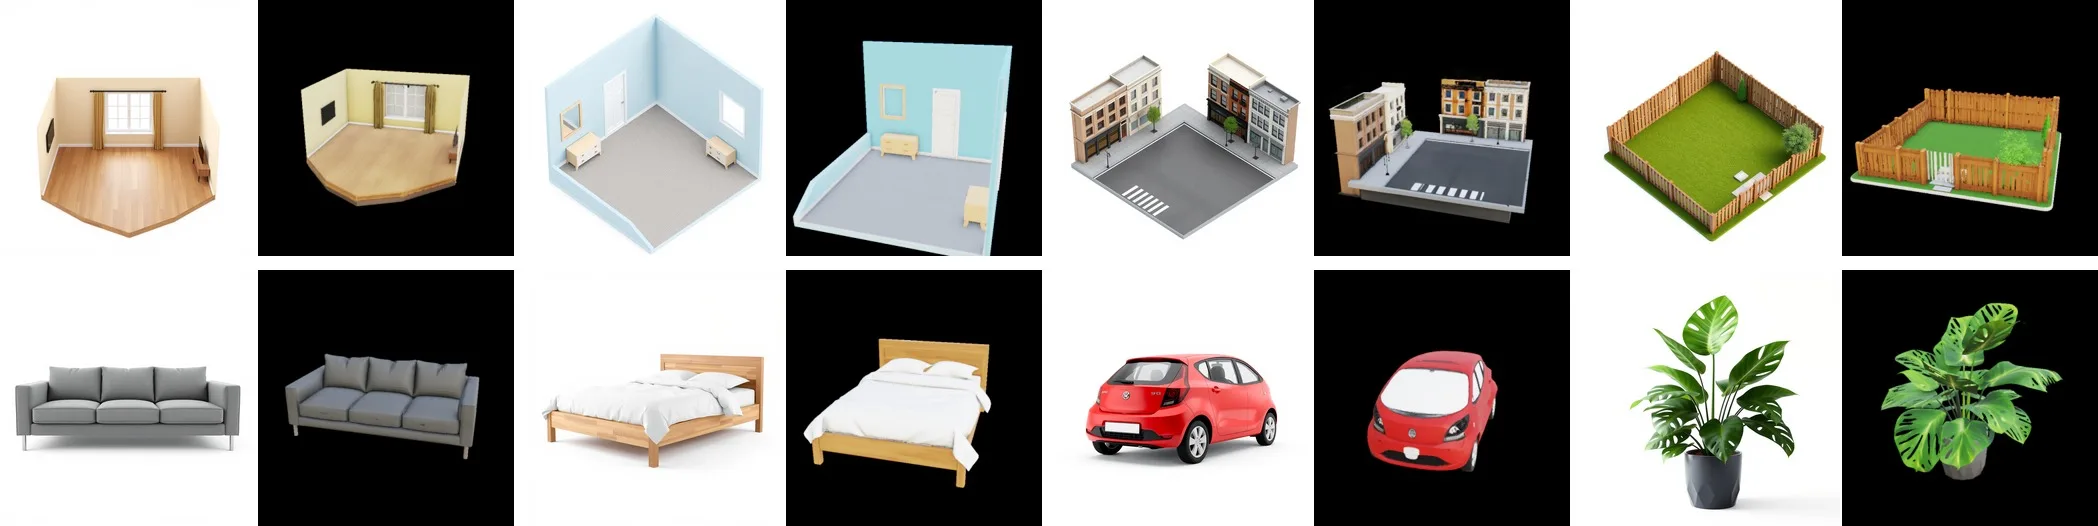
Chaque objet et chaque pièce commence par une courte description. Un modèle d'image la dessine, et TRELLIS.2 transforme le dessin en une ressource 3D texturée (figure 1).
2.2 La ressource la plus difficile : une pièce vide
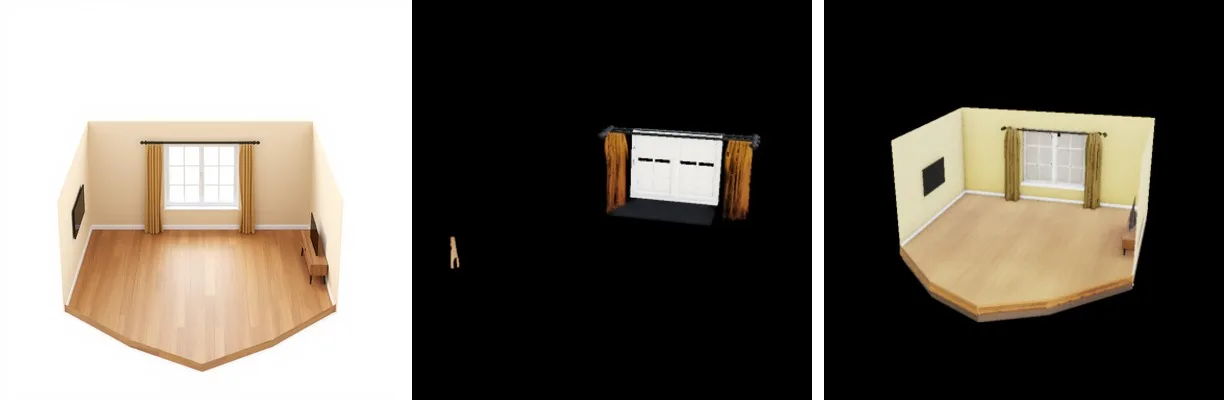
Une pièce vide est étonnamment difficile à générer. La suppression d'arrière-plan standard traite les murs et les sols pâles comme un arrière-plan, si bien que notre premier « salon vide » n'était plus qu'une fenêtre et deux rideaux. Le détourage des environnements par couleur conserve la pièce entière intacte (figure 2).
2.3 Des pièces qui respectent la physique
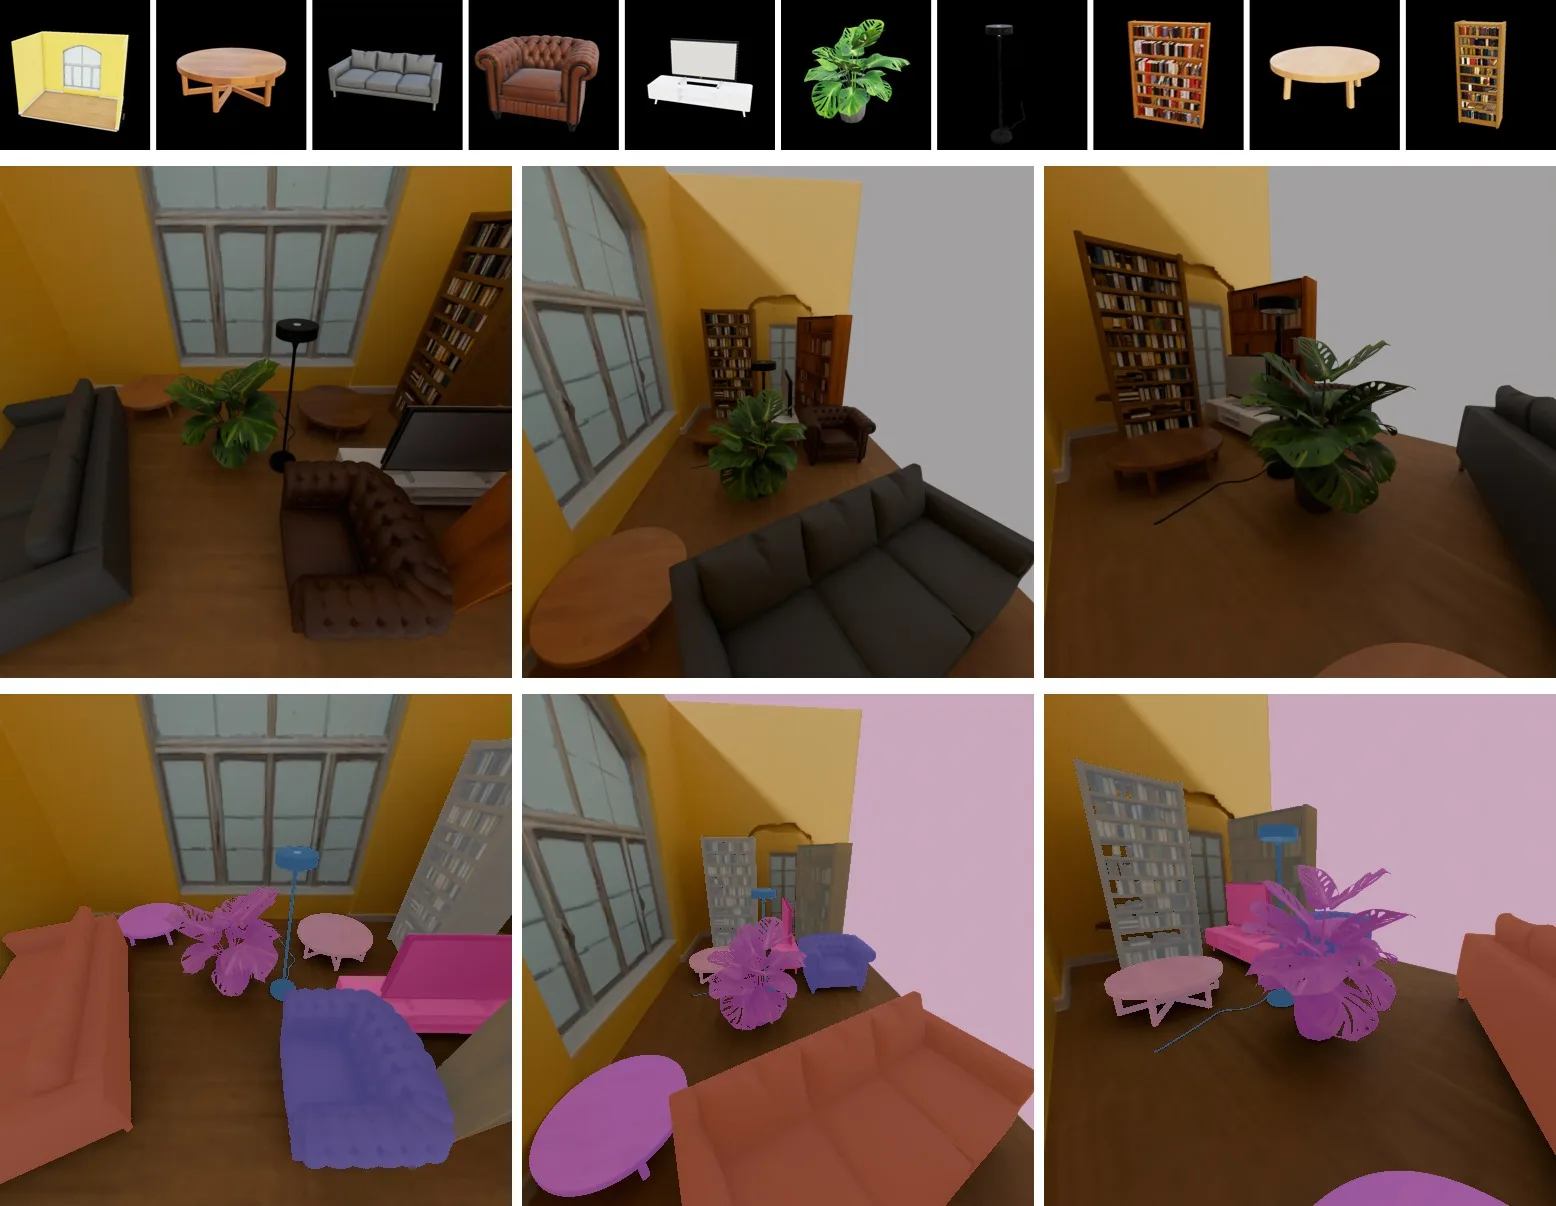
Chaque objet est placé sur une surface de support réelle. Tout ce qui flotte ou traverse un mur est rejeté, et les collisions sont résolues. Les caméras visent la région meublée, avec un champ de vision ajusté à chaque objet, et seules les vues où chaque objet est visible sont conservées (figure 3).
2.4 À grande échelle
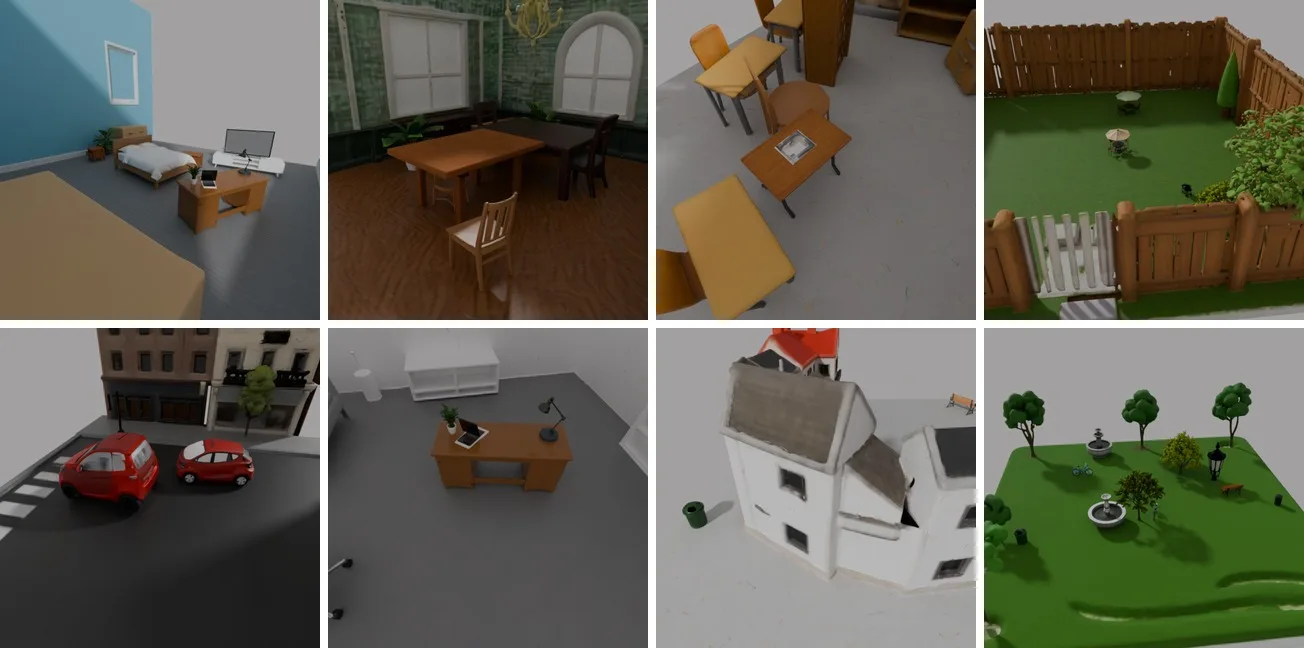
En moins d'une heure, l'usine a produit 5 500 ressources réparties dans 16 types de pièces et 89 catégories d'objets. À partir de celles-ci, elle a composé 10 216 scènes d'entraînement, avec environ six objets chacune (figure 4).
Le passage à l'échelle a révélé un problème que le projet pilote avait masqué : les modèles d'image ignorent souvent « sans meubles » et dessinent quand même des pièces meublées, ce qui enseigne le contraire de la décomposition. Notre filtre géométrique examine chaque pièce en vue de dessus et mesure la surface de sol libre. Il a conservé 537 environnements sur 1 493.
3. Génération de scènes, pas d'objets
3.1 Une seule séquence pour toute la pièce
Tous les composants d'une scène, un environnement et jusqu'à trente objets, partagent une seule séquence de tokens sur un générateur 3D figé. Chaque objet peut prêter attention à tous les autres objets et à la pièce qui l'entoure.
3.2 Partir des connaissances du modèle
Des embeddings de type et de position apprenables permettent de distinguer l'environnement des objets, et les objets les uns des autres. Ils sont initialisés à zéro, de sorte qu'à la première itération d'entraînement, le modèle se comporte exactement comme le modèle pré-entraîné. Seuls des adaptateurs légers sont entraînés.
3.3 Raffinement dans le repère de l'objet
Les objets n'occupent que quelques voxels dans une grille à l'échelle d'une pièce. Le raffinement déplace chaque objet dans son propre repère normalisé, le régénère en tenant compte de la scène entière, puis le replace exactement là où il était.
3.4 Architecture
- Modèle de base. TRELLIS.2-4B [1], un générateur image-3D à voxels épars avec des transformeurs à mise en correspondance de flux [3] pour la structure, la forme et la texture.
- Adaptateurs. LoRA [2] de rang 32 sur chaque couche d'attention et MLP : 37 millions de paramètres entraînables sur un modèle de base figé.
- Attention factorisée. Une attention dense sur une scène à 30 composants coûte 43 secondes par itération d'entraînement. Dans notre conception, cinq des trente couches effectuent une attention sur toute la scène, tandis que les autres l'effectuent au sein de chaque composant, le régime pour lequel le modèle de base a été pré-entraîné. Le coût est ainsi réduit d'un facteur 3 environ.
4. Résultats
4.1 Alignement sur la caméra
L'évaluation en conditions réelles nécessite des prédictions dans le repère métrique de la caméra. Nous recalons la scène générée sur la carte de profondeur visible et évaluons chaque pose candidate en fonction de la cohérence de cette carte. Sans cela, une erreur d'échelle de 5 % coûte à elle seule 26 points de F-score.
4.2 Mise à l'échelle du modèle
LifeSim Interiors s'améliore avec la puissance de calcul allouée à l'entraînement. Sur des scènes synthétiques non vues, le F-score à 10 cm (le plus élevé est le meilleur) augmente à chaque point de contrôle, gagnant environ neuf points chaque fois que la durée d'entraînement double (tableau 1).
| Itérations d'entraînement | 250 | 500 | 1,000 | 1,500 |
|---|---|---|---|---|
| F-score à 0,1 | 4.3% | 11.6% | 21.3% | 26.8% |
La chaîne de traitement elle-même est saine : décoder les latents de référence et les évaluer comme des prédictions donne un F-score de 100 %. Le modèle obtient également des scores similaires sur les scènes d'entraînement et sur les nouvelles scènes, ce qui indique qu'il est encore sous-entraîné et non en sur-apprentissage. Le modèle n'a reçu qu'une petite fraction de la puissance de calcul habituellement allouée à ce type de méthode.
5. Prochaines étapes
Le modèle est en phase d'apprentissage ; nous nous sommes arrêtés tôt. Les trois prochaines étapes sont : entraîner plus longtemps, composer des pièces plus réalistes et générer des environnements vraiment vides.
Nous avons déjà une longueur d'avance sur la deuxième étape. Notre laboratoire texte-intérieur conçoit des agencements de pièces avec un LLM et vérifie chaque ressource avec un modèle de vision. Notre prochaine expérience consistera à intégrer ces pièces dans l'usine à mondes.
Le modèle au cœur du système est compact. L'essentiel du travail se fait autour : fabriquer des mondes crédibles, en faire le rendu efficacement et mesurer les résultats honnêtement par rapport au monde réel. Nous vous en dirons plus à mesure que LifeSim Interiors mûrira.
Références
- Xiang, J., Chen, X., Xu, S., Wang, R., Lv, Z., et al. Native and Compact Structured Latents for 3D Generation. arXiv:2512.14692, 2025.
- Hu, E. J., Shen, Y., Wallis, P., Allen-Zhu, Z., Li, Y., Wang, S., Wang, L., Chen, W. LoRA : Adaptation de bas rang pour les grands modèles de langage. arXiv:2106.09685, 2021.
- Lipman, Y., Chen, R. T. Q., Ben-Hamu, H., Nickel, M., Le, M. Flow Matching pour la modélisation générative. arXiv:2210.02747, 2022.
Citation
Merci de citer ce travail ainsi :
@misc{lifesim2026interiors,
  title  = {LifeSim Interiors: From One Photo to a 3D Room You Can Take Apart},
  author = {{João Nobre} and {Cris Lenta}},
  year   = {2026},
  month  = {oct},
  url    = {https://lifesim.com/research/interiors}
}