


 English
 Español
 Português
 Bahasa Indonesia
 Română
 हिन्दी
 Français
 Deutsch
 Русский
 Italiano
 Polski
 한국어
 日本語
 简体中文
 Türkçe
 Kiswahili
 বাংলা
 Filipino
27 أكتوبر 2026
آدم وحواء: 700 عضلة يتحكم بها نموذج لغوي كبير عبر نماذج اتخاذ قرار مُحسَّنة
ملخص
آدم وحواء هما بشريان مُحاكيان لكل منهما 700 عضلة، يعيشان معًا في قصر الفنون الجميلة بسان فرانسيسكو. تدير النماذج اللغوية كل طبقة يمكنها إدارتها: ماذا يفعلان في يومهما، وأين يمشيان، وكيف يحافظان على توازنهما، وأين تهبط كل قدم، وما مدى قوة شد كل عضلة. ثلاثة من هذه النماذج من تطويرنا: وهي نماذج معدَّلة بدقة (fine-tunes) بـ 144 مليون مُعامِل، دُرِّب كل منها على معالج مركزي (CPU) في مدة من 4 إلى 11 دقيقة، وتحاكي معلميها بمعامل ارتباط يتراوح بين 0.958 و0.9998 على مُدخلات لم ترها من قبل. وبدون أي دعامة، يتحمل الجسدان دفعات بقوة 80 نيوتن ويمشيان بضع عشرات من الخطوات بين السقطات. هذه تجربة وليست منتجًا، ونحن نقدم تقريرًا عما نجح، وما لم ينجح، والأرقام.
1. تجربة
تتطور التكنولوجيا بسرعة كبيرة لدرجة أن لا أحد يعرف إلى أين تتجه المحاكاة. قبل عام، كان النموذج اللغوي قادرًا على إجراء محادثة. أما اليوم، فيمكنه التخطيط لأسبوع كامل، واستخدام الأدوات، والعمل لساعات. لا نعرف أين هي الحدود، لذلك حاولنا اكتشافها.
كان السؤال بسيطًا: إلى أي مدى يمكن للنموذج اللغوي أن يصل؟ شخصيات LifeSim تفكر بالفعل باستخدام النماذج اللغوية، فهي تقرر ما يجب فعله، ومع من تتحدث، وإلى أين تذهب. عدا ذلك، تستخدم كل الألعاب الرسوم المتحركة، فالجسد الذي يمشي هو جسد يؤدي حركة مسجلة.
استبدلنا الحركة المسجلة بجسد. MS-Human-700 [1] هو نموذج مفتوح للجهاز العضلي الهيكلي البشري بـ 700 عضلة، تمت محاكاته في MuJoCo [2]. وضعنا جسدين منه في مشهد واحد، على أرضية مأخوذة من الخريطة الحقيقية، وأوكلنا كل قرار ممكن إلى نموذج لغوي. لم نكن نعرف ما إذا كان سيقف. لكنه فعل.
2. الطبقات
نسخنا طبقات الجسد والعقل، وأعطينا كل طبقة يمكن أن تكون نموذجًا لغويًا لنموذج واحد (الجدول 1). الحبل الشوكي فقط هو الذي يعمل بالكود البرمجي: فهو يحول عبارات مثل "انحنِ للخلف قليلاً" أو "ضع القدم هنا" إلى 700 شدة عضلية.
| الطبقة | في الإنسان | النموذج | معدل الاستدعاء |
|---|---|---|---|
| الحياة | ماذا تفعل في يومك | Gemma 3 4B [3]، معدَّل بدقة من طرفنا باستخدام GRPO [4] على LifeSim Week | مرة لكل نشاط، ~4 ثوانٍ |
| القشرة الحركية | «امشِ إلى هناك، ثبِّت الجذع» | Gemini 3.1 Flash-Lite | مرة كل ثانية تقريبًا، ~1 ثانية |
| جذع الدماغ | يحافظ على انتصاب قامتك | LifeSim-Brainstem-0.1 (من تطويرنا) | سؤالان لكل نبضة، أثناء الوقوف |
| قرار الخطوة | أين تقع القدم التالية | LifeSim-Step-0.3 (من تطويرنا) | سؤالان لكل نبضة، أثناء المشي |
| الحبل الشوكي | توصيلات ثابتة | كود برمجي | كل نبضة |
| العضلات | تتقلص | LifeSim-Muscle-0.1 (من تطويرنا) | 700 سؤال لكل نبضة، لكل شخص |
تتواصل كل طبقة بالكلمات. يقرأ جذع الدماغ الرسالة: «الوزن على بعد 3 سم من منتصف القدمين، ويتحرك للأمام بسرعة 4 سم/ثانية»، فيحدد كيفية الميل. وتقرأ كل عضلة الأمر الخاص بمنطقتها من القشرة الحركية وإيعازًا من الحبل الشوكي، فتحدد قوة انقباضها.
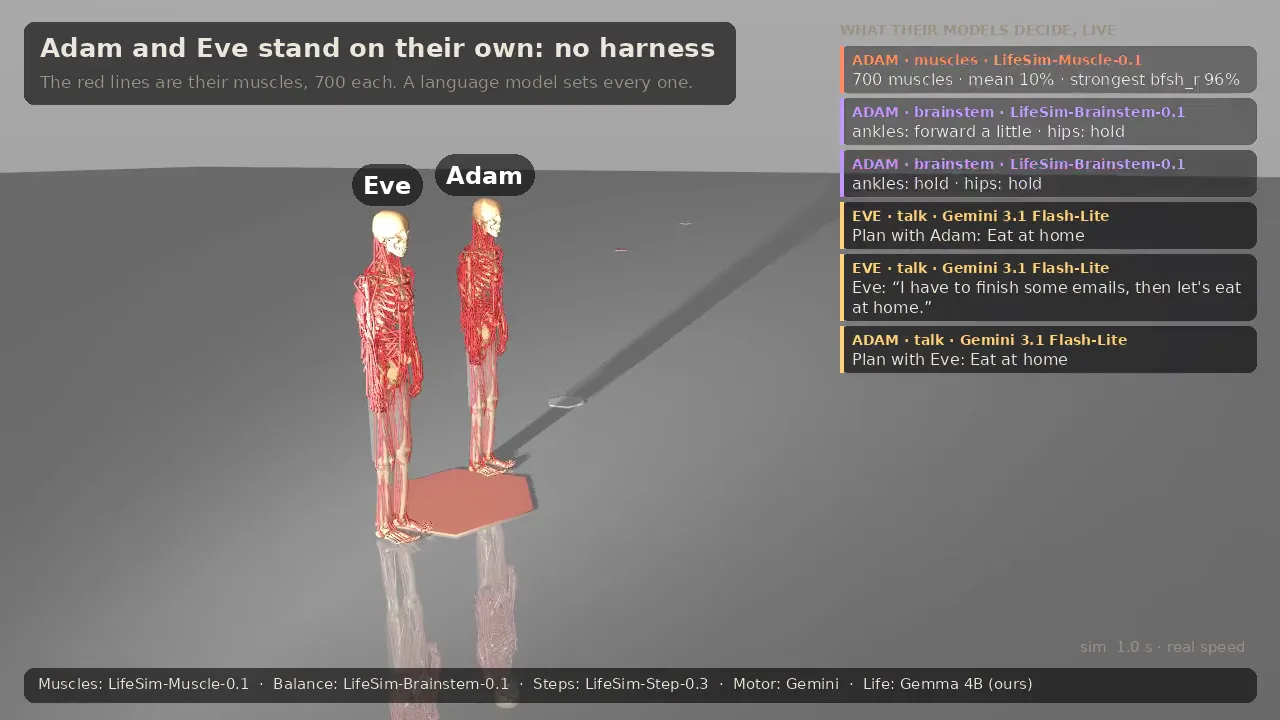
آدم وحواء على دراية ببعضهما البعض أيضًا. يقرأ كل نموذج حياة مكان الشريك وما يفعله. وعندما يلتقيان، يكتب Gemini سطرًا واحدًا لكل منهما، ويمكنهما الاتفاق على خطة: "هل تريد تناول العشاء في كيباتسو لاحقًا؟" (الشكل 3).
3. ثلاثة نماذج صغيرة
تجيب الطبقات الثلاث الدنيا على ما يصل إلى 1400 سؤال كل 10 مللي ثانية، لذا فهي تحتاج إلى نموذج صغير. استخدمنا Julia 1، وهو نموذج بـ 144 مليون مُعامِل مبني على مُشفِّر ModernBERT [5] (22 طبقة، حجم مخفي 384) مع رأس قرار، وعدَّلنا ثلاث نسخ منه بدقة. تعلمت كل نسخة من مُعلِّم مكتوب بالكود البرمجي: كود جذع الدماغ، وكود قاعدة الخطوة، وصيغة العضلات.
| النموذج | التدريب على معالج مركزي | Julia 1 الأساسي | معدَّل بدقة |
|---|---|---|---|
| LifeSim-Brainstem-0.1 | 216 s | r = −0.37 | r = 0.9997 |
| LifeSim-Step-0.3 | 308 s | r = 0.24 | r = 0.9998 |
| LifeSim-Muscle-0.1 | 642 s | r = 0.12 | r = 0.958 |
الارتباط العالي مع المُدخلات المستبعدة ليس كافيًا للمشي. في البداية، تعلم نموذج الخطوة فقط من المواقف التي واجهتها القاعدة البرمجية، وبمجرد أن تولى التحكم، قاد الجسد إلى مواقف لم ترها القاعدة قط. تركناه يمشي، وسجلنا ما واجهه، وسألنا القاعدة عما كانت ستفعله، ثم أعدنا تدريبه (DAgger [6]). ارتفع وقت المشي من 83% إلى 92% من وقت المُعلِّم.
النماذج المعدَّلة حتمية، لذا فإن السؤال نفسه يحصل دائمًا على الإجابة نفسها. نحتفظ بكل إجابة ونسأل النموذج فقط عن الأسئلة التي لم يرها. بعد بضع ثوانٍ، لا تحتاج معظم النبضات إلى أي استدعاء للنموذج على الإطلاق.
4. النتائج
4.1. الوقوف
مع وجود كل طبقة على نموذج لغوي، يقف الجسدان بدون دعامة ويتعافيان من دفعات بقوة 80 نيوتن من الأمام والخلف. على مدار 20 وقفة مع الدفع، يقف نموذج جذع الدماغ لنفس مدة مُعلِّمه تقريبًا: 12.4 ثانية مقابل 12.0 ثانية.
4.2. المشي
آلية المشي هي SIMBICON [7] على العضلات: مؤقت للخطوة، وساق متأرجحة، ووضع للقدم بناءً على موضع الوزن وسرعته. بدون دعامة، تمشي الأجساد بسرعة 0.25 م/ث تقريبًا، وتتجه نحو الهدف. في المحاكاة المباشرة، استمر متوسط المشي 18 خطوة قبل السقوط، وأطولها 133 خطوة (الشكل 2).
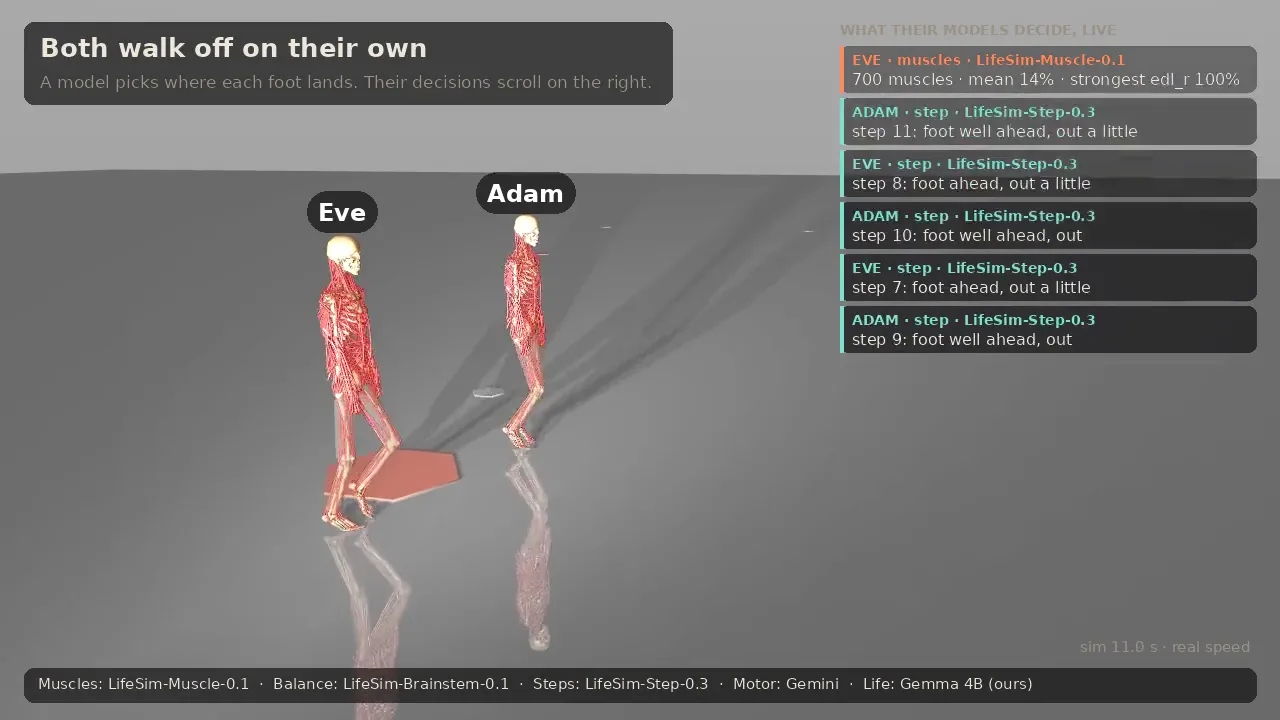
في مشية مدتها 12 ثانية، يحافظ نموذج الخطوة على الجسد منتصبًا لمدة 8.6 ثانية في المتوسط، مقابل 9.4 ثانية للقاعدة البرمجية التي تعلم منها (24 مشية). الوقوف يغتفر الأخطاء الصغيرة، أما المشي فلا.
4.3. السرعة
يعمل كل شيء على جهاز بمعالج مركزي واحد (CPU) فقط، بدون معالج رسومي (GPU). تنتظر المحاكاة النماذج (في وضع "الوقت البطيء")، لأن التوازن يتطلب اتخاذ قرار كل 10 أجزاء من الثانية. يعمل كل من الجسمين مع كل نموذج بسرعة تتراوح بين 0.25 و 0.5 من الوقت الحقيقي، وبسرعة تتراوح بين 0.12 و 0.18 عند عرضهما معًا.
4.4. في LifeSim
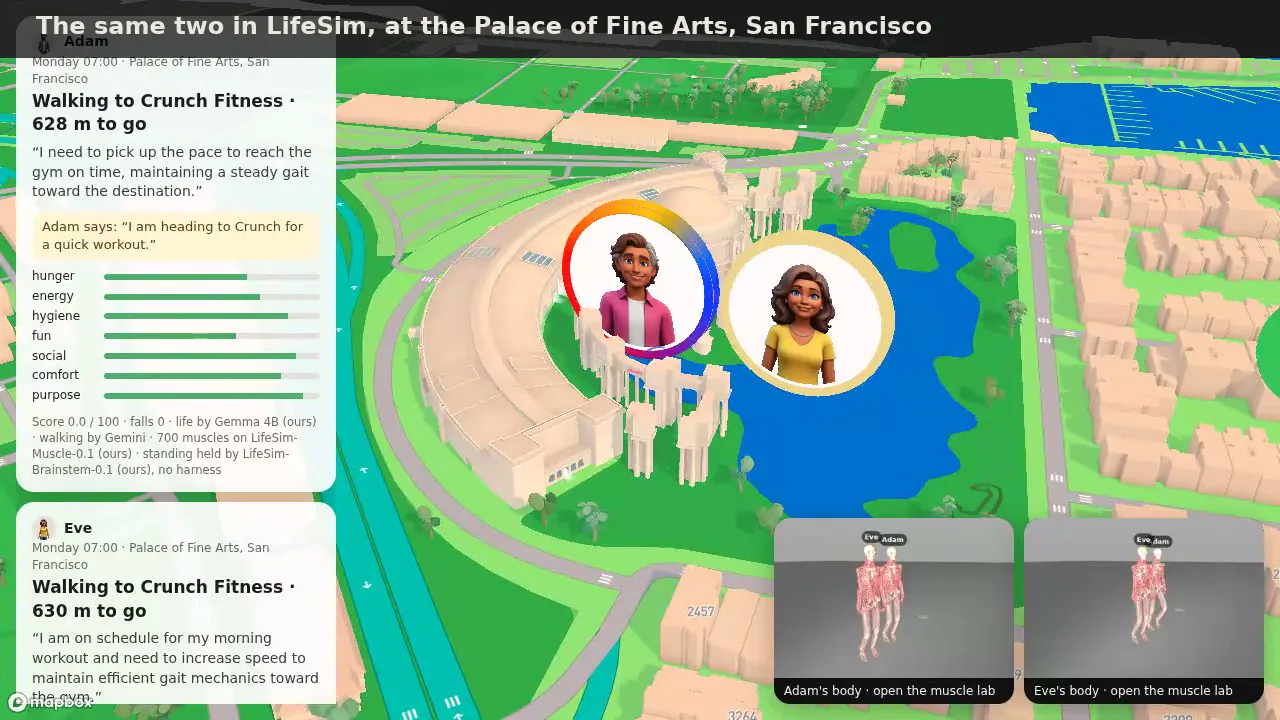
تظهر الشخصيتان نفسهما على خريطة LifeSim، مع احتياجاتهما وخططهما وما يقولانه لبعضهما البعض (الشكل 3).
5. ما تعلمناه
- يجب أن تكون الأرقام جزءًا من الوصف. "الميل قليلًا للأمام" وصف غامض جدًا للحفاظ على التوازن: سقط الجسم في 3 إلى 6 ثوانٍ. "الوزن 3 سم أمام منتصف القدمين، ويتحرك للأمام بسرعة 4 سم/ثانية" يحافظ على التوازن.
- تحدد إشارات الدماغ دقة استجابة العضلات. عند أمر "قف ثابتًا"، يستجيب نموذج العضلات بخطوات تبلغ حوالي 15%. أما عند أمر "حافظ على الثبات بتحكم دقيق"، فتكون الخطوات حوالي 10%، وعندها فقط ينجو الجسم من دفعة من الأمام.
- العضلات تعمل كالعصبونات الحركية. يجيب نموذج العضلات بخطوات متقطعة. التناوب بين الخطوات المتجاورة من نبضة إلى أخرى، مثل معدل الإطلاق، يجعل المشي يستمر لفترة أطول بنحو 50%.
- المشي فوضوي. تغيير مُعامِل واحد بجزء من المليون يغير مدة المشي بمقدار الثلث. جولة واحدة لا تثبت شيئًا، لذا فإن كل رقم للمشي هنا هو متوسط 12 جولة أو أكثر.
6. ما لا يعمل بعد
- التوقف. يسقط الجسد الماشي الذي يُسلَّم إلى توازن الوقوف في غضون ثانية: لم تنجح أي محاولة من أصل 20. عند الوصول، يندمج الجسد في وضع الوقوف. هذه حركة رسوم متحركة، ونحن نشير إليها على هذا النحو.
- النهوض. بعد السقوط، يعود الجسد إلى وضع الوقوف في ثانية واحدة. هذه أيضًا حركة رسوم متحركة.
- سرعات أخرى. تعمل فقط السرعة التي ضُبطت عليها آلية المشي.
- المزيد من الضبط. لم تتمكن ثلاث طرق بحث (التطور، وCMA-ES، والبحث العشوائي المعزز) من تحسين آلية المشي. تتطلب آلية أقوى وحدة تحكم لكامل الجسد، أو سياسة مدربة بالتعلم المعزز على معالج رسوميات (GPU).
7. لماذا جربنا هذا
لم نسعَ لبناء أفضل مشّاء، فتعلّم التعزيز يصنع ما هو أفضل. سعينا لمعرفة ما إذا كان نموذج واحد يمكنه الانتقال من "ماذا أفعل هذا المساء؟" إلى "ما العضلة التي تشدّ بقوة؟". وقد أثبت ذلك، بمساعدة بضعة أسطر برمجية. فالنماذج المفتوحة الصغيرة، التي تُضبط بدقة على وحدة المعالجة المركزية في دقائق، يمكنها أن تتولى معظم الطبقات.
لا نعرف بعد ما الغرض من هذا. ربما شخصيات في LifeSim تتحرك لأنها تقرر ذلك، وليس لأن حركة رسوم متحركة تعمل. وربما لا شيء. تتطور التكنولوجيا بسرعة كبيرة يصعب معها التكهن، وهذا هو سبب تجربة أشياء كهذه الآن، ومشاركة ما نكتشفه.
8. العمل المستقبلي
النتيجة الواعدة هي أن الكلمات تغير الجسم: فعبارة «حافظ على ثباتك بتحكم دقيق» منحت العضلات دقة أعلى من «قف ساكنًا»، وعندها فقط صمد الجسم أمام دفعة من الأمام. والتجربة التالية هي عرض استجابة الجسم نفسه لكلمات مختلفة، مثل «امشِ كأنك متعب»، أو «استعد لدفعة»، أو «استرخِ». لا يمكن لمتحكم برمجي تلقي أمر كهذا، لكن النموذج اللغوي يستطيع.
المراجع
- Zuo, C., He, K., Shao, J., Sui, Y. نموذج ذاتي للذكاء المتجسد: نمذجة نظام الهيكل العضلي البشري الكامل والتحكم في الحركة بتمثيل هرمي منخفض الأبعاد. ICRA, 2024.
- Todorov, E., Erez, T., Tassa, Y. MuJoCo: محرك فيزيائي للتحكم القائم على النموذج. IROS, 2012.
- فريق Gemma. التقرير التقني لـ Gemma 3. arXiv:2503.19786, 2025.
- Shao, Z., Wang, P., Zhu, Q., Xu, R., Song, J., et al. DeepSeekMath: تخطي حدود الاستدلال الرياضي في النماذج اللغوية المفتوحة. arXiv:2402.03300, 2024.
- Warner, B., Chaffin, A., Clavié, B., Weller, O., Hallström, O., et al. أذكى وأفضل وأسرع وأطول: مُشفّر حديث ثنائي الاتجاه لضبط دقيق واستدلال سريع وفعال في الذاكرة وذي سياق طويل. arXiv:2412.13663, 2024.
- Ross, S., Gordon, G. J., Bagnell, J. A. اختزال تعلم المحاكاة والتنبؤ المنظم إلى تعلم عبر الإنترنت دون أسف. AISTATS, 2011.
- Yin, K., Loken, K., van de Panne, M. SIMBICON: تحكم بسيط في حركة المشي على قدمين. ACM SIGGRAPH, 2007.
الاقتباس
يرجى الاستشهاد بهذا العمل على النحو التالي:
@misc{lifesim2026adamandeve,
  title  = {Adam & Eve: 700 LLM-Controlled Muscles via Fine-Tuned Decision Models},
  author = {{Cris Lenta}},
  year   = {2026},
  month  = {oct},
  url    = {https://lifesim.com/research/adam-and-eve}
}