


 English
 Español
 Português
 Bahasa Indonesia
 Română
 हिन्दी
 العربية
 Deutsch
 Русский
 Italiano
 Polski
 한국어
 日本語
 简体中文
 Türkçe
 Kiswahili
 বাংলা
 Filipino
27 oct. 2026
Adam & Ève : 700 muscles contrôlés par LLM via des modèles de décision affinés
Résumé
Adam et Ève sont deux humains simulés dotés de 700 muscles chacun, vivant ensemble au Palace of Fine Arts de San Francisco. Des modèles de langage gèrent toutes les couches de leur être qui peuvent l'être : quoi faire de leur journée, où marcher, comment garder l'équilibre, où poser chaque pied et avec quelle force chaque muscle doit tirer. Trois de ces modèles sont les nôtres : des modèles de 144 millions de paramètres affinés par nos soins, entraînés sur un processeur en 4 à 11 minutes chacun, qui imitent leurs modèles avec une corrélation de 0,958 à 0,9998 sur des données qu'ils n'ont jamais vues. Sans harnais, les deux corps résistent à des poussées de 80 N et font quelques dizaines de pas avant de tomber. Ceci est une expérience, pas un produit. Nous présentons ce qui fonctionne, ce qui ne fonctionne pas, et les chiffres.
1. Une expérience
La technologie évolue si vite que personne ne sait où va la simulation. Il y a un an, un modèle de langage pouvait tenir une conversation. Aujourd'hui, il peut planifier une semaine, utiliser des outils et fonctionner pendant des heures. Nous ne savons pas où se situe la limite, alors nous avons essayé de la trouver.
La question était simple : jusqu'où un modèle de langage peut-il aller ? Les personnages de LifeSim réfléchissent déjà avec des modèles de langage. Ils décident quoi faire, à qui parler et où aller. En dessous, tous les jeux utilisent l'animation. Un corps qui marche est un corps qui joue un enregistrement.
Nous avons remplacé l'enregistrement par un corps. MS-Human-700 [1] est un modèle ouvert du système musculo-squelettique humain avec 700 muscles, simulé dans MuJoCo [2]. Nous en avons mis deux dans une scène, sur un sol créé à partir de la carte réelle, et avons confié chaque décision possible à un modèle de langage. Nous ne savions pas s'il tiendrait debout. Il a tenu.
2. Les couches
Nous avons copié les couches d'un corps et d'un esprit, et avons attribué chaque couche pouvant être un modèle de langage à un modèle (Tableau 1). Seule la moelle épinière est du code : elle transforme « penche-toi un peu en arrière » ou « pose le pied ici » en 700 contractions musculaires.
| Couche | Chez une personne | Modèle | Fréquence |
|---|---|---|---|
| Vie | Quoi faire de la journée | Gemma 3 4B [3], affiné par nos soins avec GRPO [4] sur LifeSim Week | Une fois par activité, ~4 s |
| Cortex moteur | « Marche là-bas, gaine le tronc » | Gemini 3.1 Flash-Lite | Environ une fois par seconde, ~1 s |
| Tronc cérébral | Te maintient debout | LifeSim-Brainstem-0.1 (notre) | 2 questions par tick, debout |
| Décision du pas | Où le prochain pied se pose | LifeSim-Step-0.3 (notre) | 2 questions par tick, en marchant |
| Moelle épinière | Câblage fixe | Code | À chaque tick |
| Muscles | Se contracter | LifeSim-Muscle-0.1 (notre) | 700 questions par tick, par personne |
Chaque couche s'exprime avec des mots. Le tronc cérébral lit « le poids est 3 cm devant le milieu des pieds, avançant à 4 cm/s » et répond comment s'incliner. Chaque muscle lit l'instruction de sa région corporelle venant du cortex moteur et une impulsion de la moelle épinière, et répond avec quelle force se contracter.
Adam et Ève sont également conscients l'un de l'autre. Chaque modèle de vie sait où se trouve son partenaire et ce qu'il fait. Lorsqu'ils se rencontrent, Gemini écrit une réplique pour chacun, et ils peuvent convenir d'un plan : « Envie de dîner au Kibatsu plus tard ? » (Figure 3).
3. Trois petits modèles
Les trois couches inférieures traitent jusqu'à 1 400 questions toutes les 10 ms, ce qui requiert un petit modèle. Nous avons utilisé Julia 1, un modèle de 144 millions de paramètres basé sur un encodeur ModernBERT [5] (22 couches, dimension cachée de 384) avec une tête de décision, et en avons affiné trois copies, chacune entraînée par un tuteur logiciel différent : le tronc cérébral, la règle de marche et la formule musculaire.
| Modèle | Entraînement sur CPU | Julia 1 de base | Affiné |
|---|---|---|---|
| LifeSim-TroncCerebral-0.1 | 216 s | r = −0.37 | r = 0.9997 |
| LifeSim-Marche-0.3 | 308 s | r = 0.24 | r = 0.9998 |
| LifeSim-Muscle-0.1 | 642 s | r = 0.12 | r = 0.958 |
Une forte corrélation sur des données non vues ne suffit pas pour marcher. Le modèle de marche a d'abord appris uniquement à partir des situations rencontrées par la règle codée. Une fois aux commandes, il a mené le corps dans des situations que la règle n'avait jamais vues. Nous l'avons laissé marcher, avons enregistré les situations rencontrées, avons demandé à la règle ce qu'elle aurait fait, et l'avons ré-entraîné (DAgger [6]). Le temps de marche est passé de 83 % à 92 % de celui du professeur.
Les modèles affinés sont déterministes : la même question obtient toujours la même réponse. Nous conservons chaque réponse et ne posons au modèle que des questions qu'il n'a pas encore vues. Après quelques secondes, la plupart des cycles de simulation n'ont plus besoin d'appeler le modèle.
4. Résultats
4.1. Tenue debout
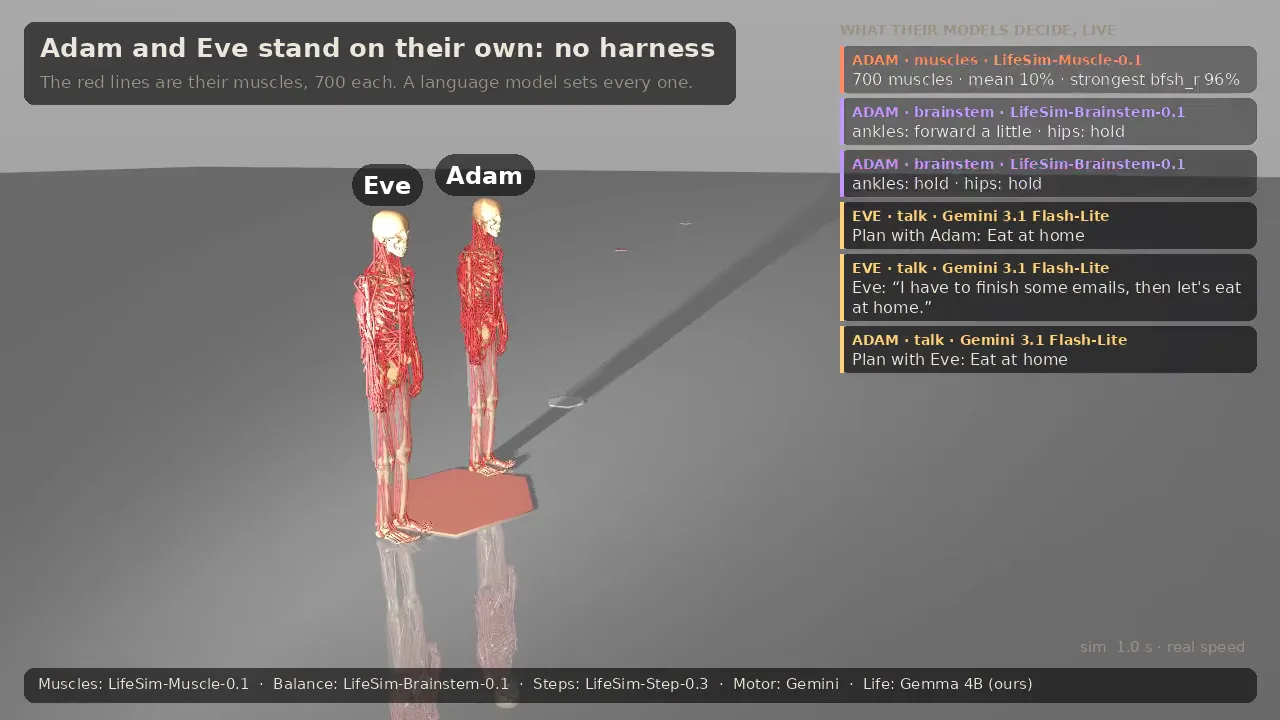
Avec chaque couche sur un modèle de langage, les deux corps tiennent debout sans harnais et se remettent de poussées de 80 N par l'avant et par l'arrière. Sur 20 essais avec poussée, le modèle du tronc cérébral reste debout aussi longtemps que son professeur : 12,4 s contre 12,0 s.
4.2. Marche
Le marcheur est SIMBICON [7] sur des muscles : un minuteur de pas, une jambe d'appui et un placement du pied basés sur la position et la vitesse du centre de gravité. Sans harnais, les corps marchent à environ 0,25 m/s en se dirigeant vers l'objectif. Dans la simulation en direct, la marche médiane a duré 18 pas entre deux chutes, et la plus longue 133 (Figure 2).
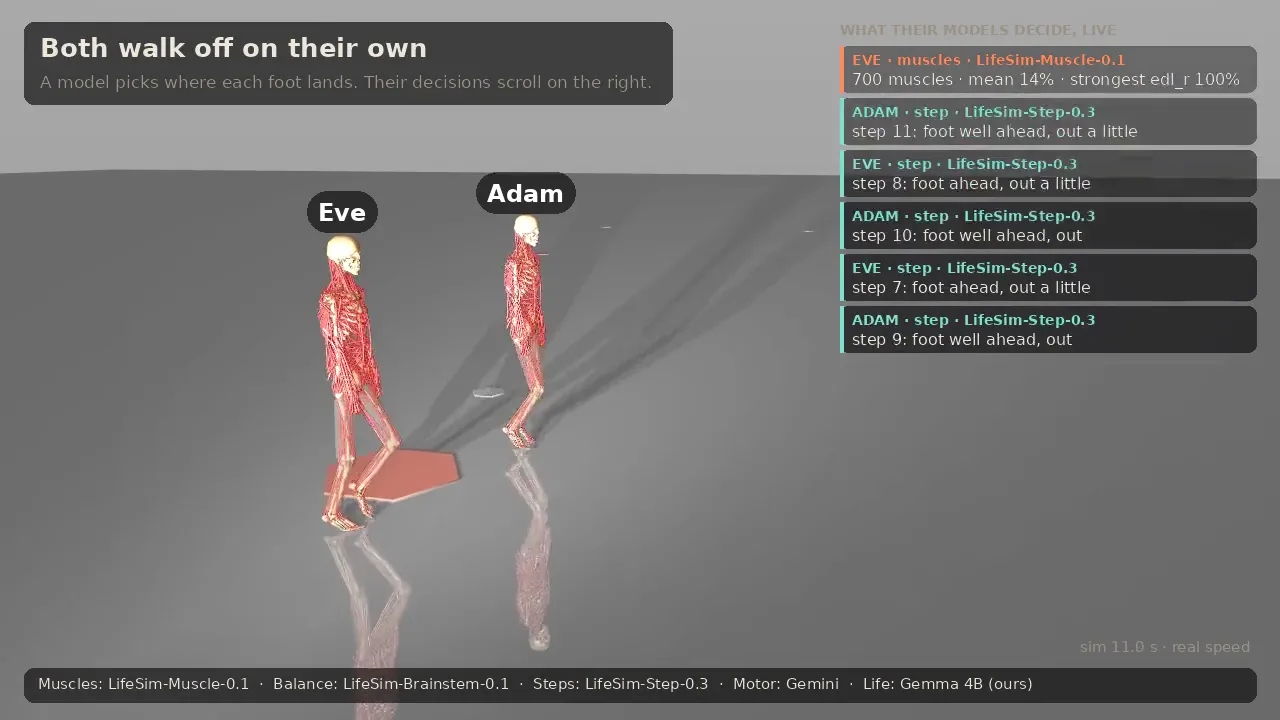
Sur une marche de 12 s, le modèle de marche maintient le corps debout pendant 8,6 s en moyenne, contre 9,4 s pour la règle codée qui lui a servi de professeur (24 marches). La station debout pardonne les petites erreurs, pas la marche.
4.3. Vitesse
Tout s'exécute sur une seule machine avec CPU, sans GPU. La simulation attend les modèles (« temps ralenti »), car l'équilibre nécessite une décision toutes les 10 ms. Les deux corps avec tous les modèles tournent entre 0,25 et 0,5 fois le temps réel, et entre 0,12 et 0,18 fois lorsque les deux sont affichés.
4.4. Dans LifeSim
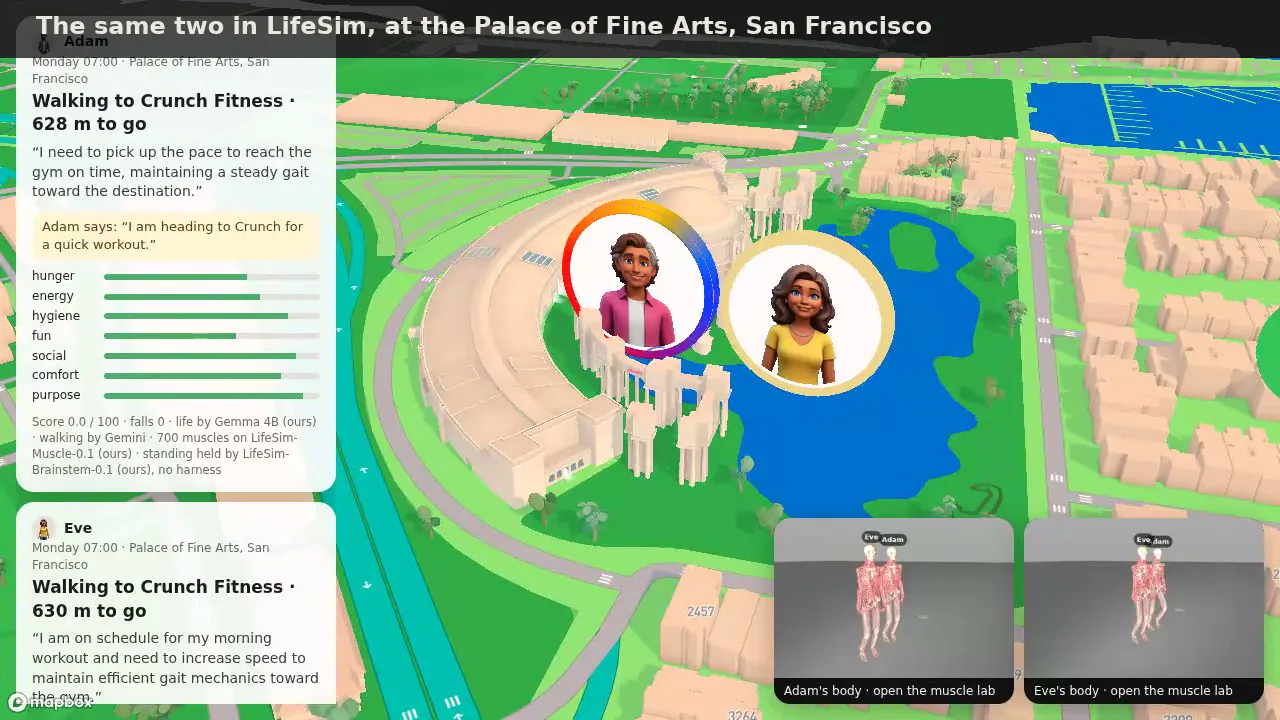
Les deux mêmes personnages apparaissent sur la carte de LifeSim, avec leurs besoins, leurs plans et ce qu'ils se disent (Figure 3).
5. Enseignements
- Les mots doivent véhiculer des chiffres. « Un peu penché en avant » est trop vague pour garder l'équilibre : le corps tombait en 3 à 6 s. « Le poids est 3 cm en avant du milieu des pieds, se déplaçant vers l'avant à 4 cm/s » le maintient debout.
- Les mots du cerveau définissent la résolution des muscles. Avec l'instruction « rester immobile », le modèle musculaire répond par paliers d'environ 15 %. Avec « maintenir l'équilibre avec un contrôle fin », les paliers sont d'environ 10 %, et c'est seulement là que le corps survit à une poussée frontale.
- Les muscles fonctionnent comme des motoneurones. Le modèle musculaire répond par paliers grossiers. L'alternance entre des paliers voisins à chaque cycle, comme une fréquence de décharge, prolonge les marches d'environ 50 %.
- La marche est chaotique. Changer un gain d'une partie par million modifie la durée d'une marche d'un tiers. Une seule exécution ne prouve rien, donc chaque chiffre concernant la marche ici est une moyenne sur 12 marches ou plus.
6. Ce qui ne fonctionne pas encore
- L'arrêt. Un corps en marche confié au modèle d'équilibre debout tombe en moins d'une seconde : 0 tentative sur 20 a réussi. À l'arrivée, le corps adopte une posture debout par fondu. C'est une animation, et nous l'indiquons comme telle.
- Se relever. Après une chute, le corps se remet debout en une seconde par fondu. C'est aussi une animation.
- Les autres vitesses. Seule la vitesse pour laquelle le marcheur a été réglé fonctionne.
- Plus de réglages. Trois méthodes de recherche (évolution, CMA-ES et Augmented Random Search) n'ont pas pu améliorer le marcheur. Un modèle plus robuste nécessiterait un contrôleur pour le corps entier, ou une politique entraînée par apprentissage par renforcement sur un GPU.
7. Pourquoi nous avons fait cette expérience
Nous n'avons pas cherché à créer le meilleur marcheur. L'apprentissage par renforcement en produit de meilleurs. Nous voulions voir si un seul type de modèle pouvait couvrir tout le spectre, de « qu'est-ce que je fais ce soir ? » à « quel muscle tire et avec quelle force ? ». C'est possible, avec l'aide de quelques lignes de code au milieu. De petits modèles ouverts, affinés sur un CPU en quelques minutes, peuvent gérer la plupart des couches.
Nous ne savons pas encore à quoi cela peut servir. Peut-être à avoir des personnages dans LifeSim qui bougent parce qu'ils le décident, et non parce qu'une animation se lance. Peut-être à rien. La technologie évolue trop vite pour le dire, c'est pourquoi il faut tenter ce genre d'expériences maintenant, et partager nos découvertes.
8. Pistes de recherche
Le résultat le plus prometteur est que les mots modifient le corps : « maintenir l'équilibre avec un contrôle fin » a donné aux muscles une résolution plus fine que « rester immobile », et c'est seulement là que le corps a survécu à une poussée frontale. La prochaine expérience consistera à montrer le même corps réagissant à différents mots, comme « marche comme si tu étais fatigué », « prépare-toi à une poussée » ou « détends-toi ». Un contrôleur codé ne peut pas interpréter une telle instruction. Un modèle de langage, si.
Références
- Zuo, C., He, K., Shao, J., Sui, Y. Self Model for Embodied Intelligence: Modeling Full-Body Human Musculoskeletal System and Locomotion Control with Hierarchical Low-Dimensional Representation. ICRA, 2024.
- Todorov, E., Erez, T., Tassa, Y. MuJoCo: A physics engine for model-based control. IROS, 2012.
- Gemma Team. Gemma 3 Technical Report. arXiv:2503.19786, 2025.
- Shao, Z., Wang, P., Zhu, Q., Xu, R., Song, J., et al. DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models. arXiv:2402.03300, 2024.
- Warner, B., Chaffin, A., Clavié, B., Weller, O., Hallström, O., et al. Smarter, Better, Faster, Longer: A Modern Bidirectional Encoder for Fast, Memory Efficient, and Long Context Finetuning and Inference. arXiv:2412.13663, 2024.
- Ross, S., Gordon, G. J., Bagnell, J. A. A Reduction of Imitation Learning and Structured Prediction to No-Regret Online Learning. AISTATS, 2011.
- Yin, K., Loken, K., van de Panne, M. SIMBICON: Simple Biped Locomotion Control. ACM SIGGRAPH, 2007.
Citation
Merci de citer ce travail ainsi :
@misc{lifesim2026adamandeve,
  title  = {Adam & Eve: 700 LLM-Controlled Muscles via Fine-Tuned Decision Models},
  author = {{Cris Lenta}},
  year   = {2026},
  month  = {oct},
  url    = {https://lifesim.com/research/adam-and-eve}
}