


 English
 Español
 Português
 Bahasa Indonesia
 Română
 العربية
 Français
 Deutsch
 Русский
 Italiano
 Polski
 한국어
 日本語
 简体中文
 Türkçe
 Kiswahili
 বাংলা
 Filipino
27 अक्टूबर 2026
एडम और ईव: फ़ाइन-ट्यून किए गए डिसीज़न मॉडल्स से 700 LLM-नियंत्रित मांसपेशियाँ
सार
एडम और ईव, 700 मांसपेशियों वाले दो सिम्युलेटेड इंसान हैं, जो सैन फ्रांसिस्को के पैलेस ऑफ़ फाइन आर्ट्स में एक साथ रहते हैं। लैंग्वेज मॉडल उनकी हर उस परत को चलाते हैं जिसे एक लैंग्वेज मॉडल चला सकता है: दिन में क्या करना है, कहाँ चलना है, संतुलन कैसे बनाए रखना है, हर कदम कहाँ रखना है, और हर मांसपेशी कितनी ज़ोर से खिंचेगी। इनमें से तीन मॉडल हमारे अपने हैं: 144M-पैरामीटर वाले फाइन-ट्यून, जिन्हें एक सीपीयू पर 4 से 11 मिनट में प्रशिक्षित किया गया है। ये मॉडल उन इनपुट पर अपने शिक्षकों की 0.958 से 0.9998 के सहसंबंध के साथ नकल करते हैं, जिन्हें उन्होंने पहले कभी नहीं देखा था। बिना किसी सहारे के, दोनों शरीर 80 N के धक्कों के बावजूद खड़े रहते हैं और गिरने से पहले कुछ दर्जन कदम चल लेते हैं। यह एक प्रयोग है, कोई उत्पाद नहीं। हम बताते हैं कि क्या काम करता है, क्या नहीं, और क्या हैं इसके आँकड़े।
1. एक प्रयोग
टेक्नोलॉजी इतनी तेज़ी से आगे बढ़ रही है कि कोई नहीं जानता कि सिमुलेशन का भविष्य क्या होगा। एक साल पहले, एक लैंग्वेज मॉडल बातचीत कर सकता था। आज, यह एक हफ़्ते की योजना बना सकता है, टूल का उपयोग कर सकता है और घंटों तक चल सकता है। हम नहीं जानते कि इसकी सीमा कहाँ है, इसलिए हमने इसे खोजने की कोशिश की।
सवाल सीधा था: एक लैंग्वेज मॉडल कितनी गहराई तक जा सकता है? LifeSim के लोग पहले से ही लैंग्वेज मॉडल से सोचते हैं। वे तय करते हैं कि क्या करना है, किससे बात करनी है और कहाँ जाना है। इसके नीचे, हर गेम एनीमेशन का उपयोग करता है। एक चलता हुआ शरीर असल में एक रिकॉर्डिंग चला रहा होता है।
हमने रिकॉर्डिंग को एक शरीर से बदल दिया। MS-Human-700 [1] मानव मस्कुलोस्केलेटल सिस्टम का एक खुला मॉडल है जिसमें 700 मांसपेशियाँ हैं, जिसे MuJoCo [2] में सिम्युलेट किया गया है। हमने उनमें से दो को एक ही सीन में, असली नक्शे से बने फ़र्श पर रखा, और हर संभव फ़ैसला एक लैंग्वेज मॉडल को सौंप दिया। हमें नहीं पता था कि यह खड़ा हो पाएगा या नहीं। पर यह खड़ा हो गया।
2. परतें
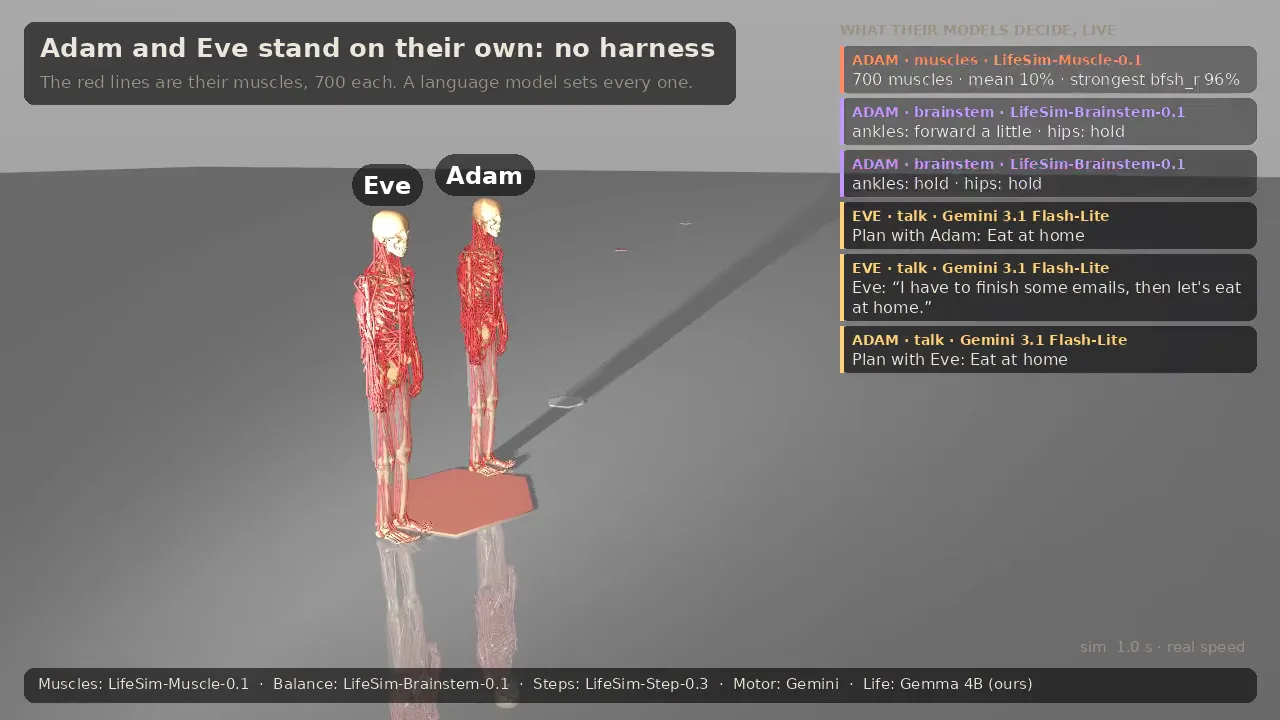
हमने एक शरीर और एक मन की परतों की नकल की, और हर उस परत को, जो एक लैंग्वेज मॉडल हो सकती थी, एक मॉडल को सौंप दिया (तालिका 1)। केवल रीढ़ की हड्डी कोड है: यह "थोड़ा पीछे झुको" या "पैर यहाँ रखो" जैसे आदेशों को 700 मांसपेशियों के खिंचाव में बदल देती है।
| परत | एक व्यक्ति में | मॉडल | कितनी बार |
|---|---|---|---|
| जीवन | दिन में क्या करना है | Gemma 3 4B [3], जिसे हमने LifeSim Week पर GRPO [4] के साथ फाइन-ट्यून किया है | हर गतिविधि में एक बार, ~4 सेकंड |
| मोटर कॉर्टेक्स | “वहाँ चलो, धड़ को स्थिर करो” | Gemini 3.1 Flash-Lite | लगभग हर सेकंड में एक बार, ~1 सेकंड |
| ब्रेनस्टेम | आपको सीधा रखता है | LifeSim-Brainstem-0.1 (हमारा) | खड़े होने पर हर टिक में 2 सवाल |
| कदम का फ़ैसला | अगला पैर कहाँ पड़ेगा | LifeSim-Step-0.3 (हमारा) | चलते समय हर टिक में 2 सवाल |
| रीढ़ की हड्डी | निश्चित वायरिंग | कोड | हर टिक |
| मांसपेशियाँ | संकुचन | LifeSim-Muscle-0.1 (हमारा) | हर टिक में 700 सवाल, प्रति व्यक्ति |
हर परत शब्दों में बोलती है। ब्रेनस्टेम पढ़ता है "वजन पैरों के बीच से 3 सेमी आगे है, और 4 सेमी/सेकंड की गति से आगे बढ़ रहा है" और जवाब देता है कि कैसे झुकना है। हर मांसपेशी मोटर कॉर्टेक्स से अपने शरीर के हिस्से के लिए आदेश और रीढ़ की हड्डी से एक संकेत पढ़ती है, और जवाब देती है कि कितनी ज़ोर से सिकुड़ना है।
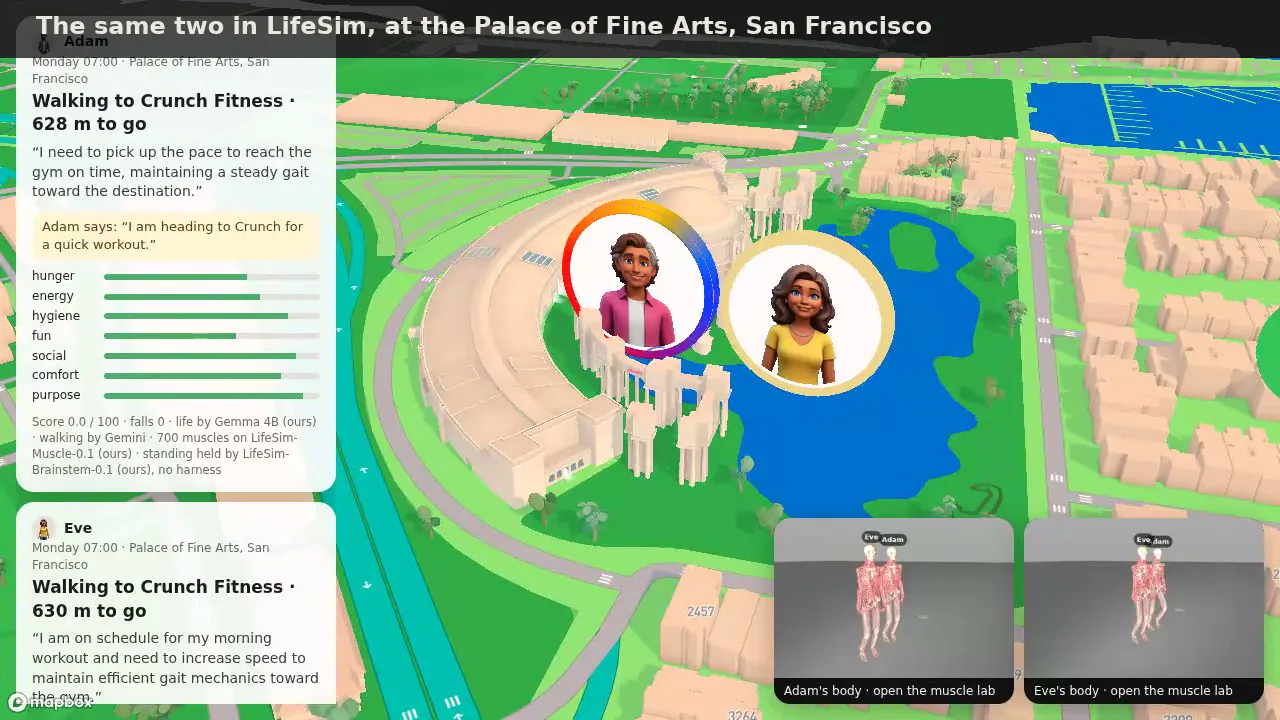
एडम और ईव भी एक-दूसरे के बारे में जानते हैं। हर लाइफ़ मॉडल यह देखता है कि उसका पार्टनर कहाँ है और क्या कर रहा है। जब दोनों मिलते हैं, तो Gemini दोनों के लिए एक-एक लाइन लिखता है और वे मिलकर कोई प्लान बना सकते हैं: “बाद में Kibatsu में डिनर पर चलें?” (चित्र 3)।
3 तीन छोटे मॉडल
सबसे निचली तीन परतें हर 10 मिलीसेकंड में 1,400 सवालों तक के जवाब देती हैं, इसलिए उन्हें एक छोटे मॉडल की ज़रूरत होती है। हमने Julia 1 का इस्तेमाल किया, जो एक 144M-पैरामीटर वाला मॉडल है। इसे ModernBERT [5] एन्कोडर (22 परतें, हिडन साइज़ 384) पर एक डिसीज़न हेड के साथ बनाया गया है और इसकी तीन कॉपियों को फ़ाइन-ट्यून किया गया है। हर कॉपी ने कोड में लिखे एक टीचर से सीखा: कोड ब्रेनस्टेम, कोड स्टेप रूल और मसल फ़ॉर्मूला।
| मॉडल | CPU पर ट्रेनिंग | बेस Julia 1 | फ़ाइन-ट्यून किया गया |
|---|---|---|---|
| LifeSim-Brainstem-0.1 | 216 s | r = −0.37 | r = 0.9997 |
| LifeSim-Step-0.3 | 308 s | r = 0.24 | r = 0.9998 |
| LifeSim-Muscle-0.1 | 642 s | r = 0.12 | r = 0.958 |
बाहर रखे गए इनपुट पर ज़्यादा मेल होना चलने के लिए काफ़ी नहीं है। स्टेप मॉडल ने पहले सिर्फ़ उन स्थितियों से सीखा जिनका सामना कोड रूल ने किया था। एक बार कंट्रोल मिलने पर, यह शरीर को ऐसी स्थितियों में ले गया जो रूल ने कभी नहीं देखी थीं। हमने इसे चलने दिया, इसने जिन स्थितियों का सामना किया उन्हें रिकॉर्ड किया, रूल से पूछा कि उसने क्या किया होता और फिर से ट्रेन किया (DAgger [6])। चलने का समय टीचर के 83% से बढ़कर 92% हो गया।
फ़ाइन-ट्यून निश्चित व्यवहार करते हैं, इसलिए एक ही सवाल का जवाब हमेशा एक ही मिलता है। हम हर जवाब को सेव कर लेते हैं और मॉडल से केवल वे सवाल पूछते हैं जो उसने पहले नहीं देखे हैं। कुछ सेकंड के बाद, ज़्यादातर टिक के लिए किसी मॉडल कॉल की ज़रूरत ही नहीं पड़ती।
4 नतीजे
4.1 खड़ा होना
जब हर परत एक लैंग्वेज मॉडल पर होती है, तो दोनों शरीर बिना हार्नेस के खड़े होते हैं और आगे और पीछे से 80 N के धक्कों से सँभल जाते हैं। 20 बार धक्का देकर खड़ा करने पर, ब्रेनस्टेम मॉडल अपने टीचर जितनी ही देर खड़ा रहता है: 12.0 सेकंड के मुकाबले 12.4 सेकंड।
4.2 चलना
वॉकर असल में SIMBICON [7] है जिसे मसल्स पर लागू किया गया है: एक स्टेप टाइमर, एक स्विंग लेग और वज़न की पोज़िशन और स्पीड के हिसाब से पैर रखना। बिना हार्नेस के, शरीर लगभग 0.25 मीटर/सेकंड की रफ़्तार से चलते हैं और मंज़िल की ओर बढ़ते हैं। लाइव सिमुलेशन में, गिरने से पहले की औसत चाल 18 क़दमों की थी और सबसे लंबी 133 क़दमों की (चित्र 2)।
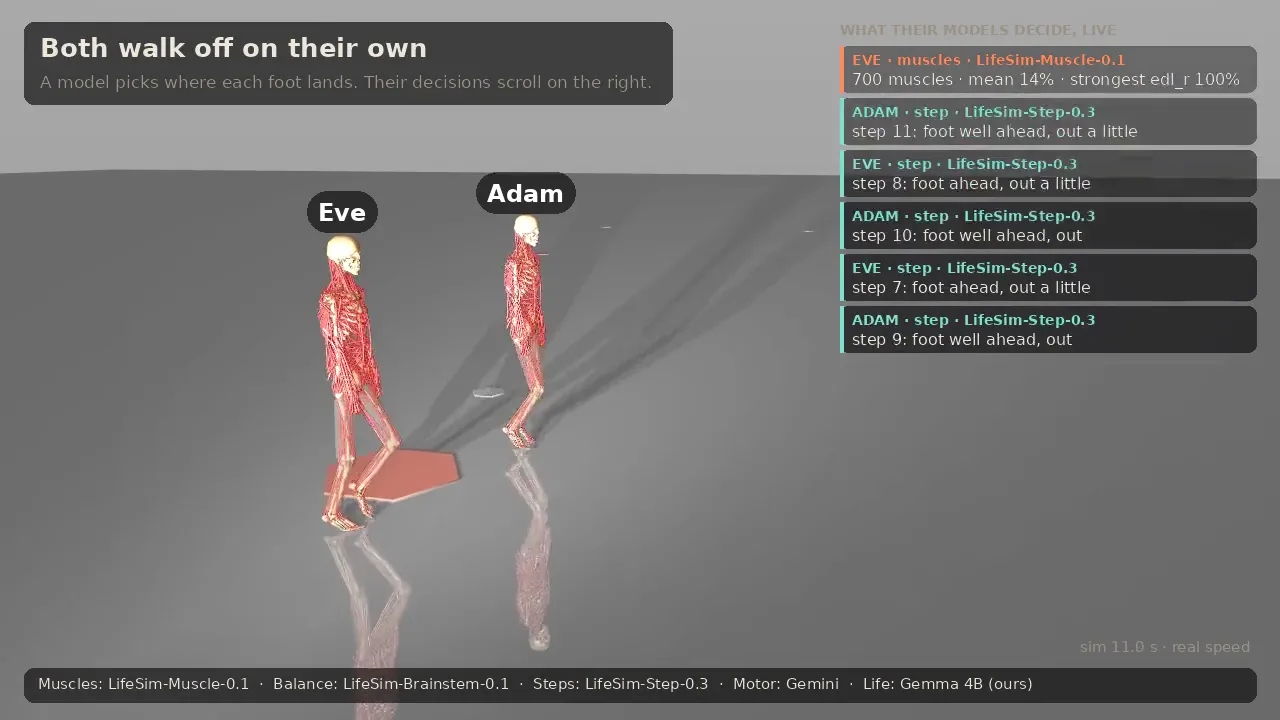
12 सेकंड की वॉक में, स्टेप मॉडल शरीर को औसतन 8.6 सेकंड तक सीधा रखता है, जबकि इसे सिखाने वाले कोड रूल के लिए यह 9.4 सेकंड है (24 वॉक)। खड़े होने में छोटी-मोटी गलतियाँ चल जाती हैं, लेकिन चलने में नहीं।
4.3 स्पीड
सब कुछ एक ही CPU मशीन पर बिना GPU के चलता है। सिमुलेशन मॉडल का इंतज़ार करता है (“स्लो टाइम”), क्योंकि संतुलन के लिए हर 10 मिलीसेकंड में एक फ़ैसले की ज़रूरत होती है। हर मॉडल के साथ दोनों शरीर 0.25 से 0.5 गुना असल समय पर चलते हैं और जब दोनों को ड्रॉ किया जाता है तो 0.12 से 0.18 गुना पर।
4.4 LifeSim में
वही दो लोग LifeSim मैप पर अपनी ज़रूरतों, अपने प्लान और एक-दूसरे से कही गई बातों के साथ दिखाई देते हैं (चित्र 3)।
5 हमने क्या सीखा
- शब्दों में संख्याएँ होनी चाहिए। “थोड़ा आगे झुकना” संतुलन बनाने के लिए बहुत अस्पष्ट है: शरीर 3 से 6 सेकंड में गिर गया। “वज़न पैरों के बीच से 3 सेमी आगे है और 4 सेमी/सेकंड की रफ़्तार से आगे बढ़ रहा है” इसे सीधा रखता है।
- दिमाग़ के शब्द मसल्स का रिज़ॉल्यूशन तय करते हैं। “स्थिर खड़े रहो” कमांड पर, मसल मॉडल लगभग 15% के स्टेप में जवाब देता है। “बारीक कंट्रोल के साथ स्थिर रहो” कमांड पर, स्टेप लगभग 10% के होते हैं और तभी शरीर सामने से धक्का झेल पाता है।
- मांसपेशियाँ मोटर न्यूरॉन्स की तरह काम करती हैं। मसल मॉडल मोटे स्टेप में जवाब देता है। एक टिक से दूसरे टिक तक आस-पास के स्टेप्स के बीच बारी-बारी से बदलने पर, जैसे कि फ़ायरिंग रेट, वॉक लगभग 50% ज़्यादा देर तक चलती है।
- चलना अव्यवस्थित है। एक गेन को दस लाख में एक हिस्से से बदलने पर वॉक की अवधि एक-तिहाई बदल जाती है। एक रन से कुछ भी साबित नहीं होता, इसलिए यहाँ चलने की हर संख्या 12 या उससे ज़्यादा वॉक का औसत है।
6 क्या चीज़ें अभी काम नहीं करतीं
- रुकना। चलते हुए शरीर को जब खड़े होने का संतुलन दिया जाता है, तो वह एक सेकंड में गिर जाता है: 20 में से 0 कोशिशें कामयाब रहीं। पहुँचने पर, शरीर एक खड़े पोज़ में ब्लेंड हो जाता है। यह एक एनिमेशन है और हम इसे ऐसा ही बताते हैं।
- उठना। गिरने के बाद, शरीर एक सेकंड में वापस खड़े होने की स्थिति में ब्लेंड हो जाता है। यह भी एक एनिमेशन है।
- दूसरी स्पीड। सिर्फ़ वही स्पीड काम करती है जिस पर वॉकर को ट्यून किया गया था।
- और ट्यूनिंग। तीन सर्च मेथड (इवोल्यूशन, CMA-ES और ऑगमेंटेड रैंडम सर्च) वॉकर को बेहतर नहीं बना सके। एक ज़्यादा मज़बूत वॉकर के लिए पूरे शरीर का कंट्रोलर या GPU पर रीइन्फ़ोर्समेंट लर्निंग से ट्रेन की गई पॉलिसी की ज़रूरत है।
7 हमने यह कोशिश क्यों की
हमारा मक़सद सबसे अच्छा वॉकर बनाना नहीं था। रीइन्फ़ोर्समेंट लर्निंग इससे बेहतर वॉकर बनाती है। हम यह देखना चाहते थे कि क्या एक ही तरह का मॉडल “आज शाम क्या करूँ” से लेकर “कौन-सी मसल कितनी ज़ोर से खींचेगी” तक पहुँच सकता है। यह बीच में कोड की कुछ लाइनों की मदद से ऐसा कर सकता है। छोटे ओपन मॉडल, जिन्हें CPU पर मिनटों में फ़ाइन-ट्यून किया गया है, ज़्यादातर परतें सँभाल सकते हैं।
हम अभी तक नहीं जानते कि यह किस काम आएगा। शायद LifeSim में लोग इसलिए हिलें-डुलें क्योंकि वे ऐसा करने का फ़ैसला करते हैं, न कि इसलिए कि कोई एनिमेशन चलता है। शायद किसी काम न आए। टेक्नोलॉजी इतनी तेज़ी से आगे बढ़ रही है कि कुछ कहा नहीं जा सकता, और यही वजह है कि अभी इस तरह की चीज़ों को आज़माना चाहिए और जो हम सीखते हैं उसे शेयर करना चाहिए।
8 भविष्य में होने वाला काम
सबसे उम्मीद भरा नतीजा यह है कि शब्द शरीर को बदलते हैं: “बारीक कंट्रोल के साथ स्थिर रहो” ने मसल्स को “स्थिर खड़े रहो” की तुलना में बेहतर रिज़ॉल्यूशन दिया और तभी शरीर सामने से धक्का झेल पाया। अगला प्रयोग यह दिखाना है कि वही शरीर अलग-अलग शब्दों पर कैसे प्रतिक्रिया करता है, जैसे “थके हुए की तरह चलो”, “धक्के के लिए तैयार हो जाओ” या “आराम करो”। एक कोड कंट्रोलर इस तरह के निर्देश नहीं ले सकता। एक लैंग्वेज मॉडल ले सकता है।
संदर्भ
- Zuo, C., He, K., Shao, J., Sui, Y. Self Model for Embodied Intelligence: Modeling Full-Body Human Musculoskeletal System and Locomotion Control with Hierarchical Low-Dimensional Representation. ICRA, 2024.
- Todorov, E., Erez, T., Tassa, Y. MuJoCo: A physics engine for model-based control. IROS, 2012.
- Gemma Team. Gemma 3 Technical Report. arXiv:2503.19786, 2025.
- Shao, Z., Wang, P., Zhu, Q., Xu, R., Song, J., et al. DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models. arXiv:2402.03300, 2024.
- Warner, B., Chaffin, A., Clavié, B., Weller, O., Hallström, O., et al. Smarter, Better, Faster, Longer: A Modern Bidirectional Encoder for Fast, Memory Efficient, and Long Context Finetuning and Inference. arXiv:2412.13663, 2024.
- Ross, S., Gordon, G. J., Bagnell, J. A. A Reduction of Imitation Learning and Structured Prediction to No-Regret Online Learning. AISTATS, 2011.
- Yin, K., Loken, K., van de Panne, M. SIMBICON: Simple Biped Locomotion Control. ACM SIGGRAPH, 2007.
उद्धरण
कृपया इस काम को इस तरह से उद्धृत करें:
@misc{lifesim2026adamandeve,
  title  = {Adam & Eve: 700 LLM-Controlled Muscles via Fine-Tuned Decision Models},
  author = {{Cris Lenta}},
  year   = {2026},
  month  = {oct},
  url    = {https://lifesim.com/research/adam-and-eve}
}