


 English
 Español
 Português
 Bahasa Indonesia
 Română
 हिन्दी
 العربية
 Français
 Русский
 Italiano
 Polski
 한국어
 日本語
 简体中文
 Türkçe
 Kiswahili
 বাংলা
 Filipino
10. Okt. 2026
LifeSim Interiors: Von einem Foto zu einem zerlegbaren 3D-Raum
Zusammenfassung
Wir präsentieren LifeSim Interiors, ein Forschungssystem, das eine zerlegte 3D-Szene aus einem Bild generiert: eine Umgebung plus jedes Objekt als eigenes Mesh, jedes am richtigen Ort. Das System erweitert TRELLIS.2 [1], um eine Umgebung und bis zu dreißig Objekte gemeinsam in einem gemeinsamen Rahmen zu generieren. Da kein großer Datensatz zerlegter 3D-Räume existiert, haben wir eine Pipeline entwickelt, die 5.500 Assets produzierte und 10.216 physikalisch gültige Trainingsszenen zusammensetzte. Bei zurückgehaltenen synthetischen Szenen steigt der F-Score bei 10 cm von 4,3 % auf 26,8 %, wenn das Training von 250 auf 1.500 Schritte anwächst, und die Kurve zeigt kein Plateau.
1 Einleitung
Eine 3D-Szene ist mehr als eine Oberfläche. Es ist ein Raum, den man umgestalten könnte, ein Sofa, das man verschieben könnte, ein Regal, das man ersetzen könnte. Ein System, das den Raum versteht, muss diese Teile wiederherstellen, nicht nur ein einziges eingefrorenes Mesh.
LifeSim Interiors generiert eine Umgebung plus jedes Objekt als eigenes Mesh. Es baut auf neueren Arbeiten zur Objekt-zu-Szene-Destillation und auf Microsofts TRELLIS.2 [1] auf. Wir haben den gesamten Stack innerhalb von zwei Tagen auf Google Cloud aufgebaut. Unsere Beiträge sind:
- Eine Weltfabrik: Text wird zu Bildern, Bilder werden zu 3D-Assets und Assets werden zu physikalisch gültigen Räumen, im großen Maßstab (Abschnitt 2).
- Ein Szenengenerator: ein 3D-Objektmodell, das erweitert wurde, um eine Umgebung und viele Objekte gemeinsam in einem gemeinsamen Rahmen zu generieren (Abschnitt 3).
- Objektverfeinerung: Jedes Objekt wird in seinem eigenen Rahmen detaillierter neu generiert, konditioniert auf den Rest der Szene (Abschnitt 3.3).
- Messung: ein öffentliches Benchmark-Protokoll sowie unsere eigene Methode zur Platzierung generierter Szenen im Rahmen einer realen Kamera (Abschnitt 4).
2 Welten erschaffen
Es gibt keinen großen Datensatz von 3D-Räumen, die in einzelne Teile zerlegt sind, also erstellen wir einen. Ein vortrainierter Objektgenerator erstellt die Teile, und unsere Pipeline fügt sie zu Räumen zusammen.
2.1 Von Wörtern zu Teilen
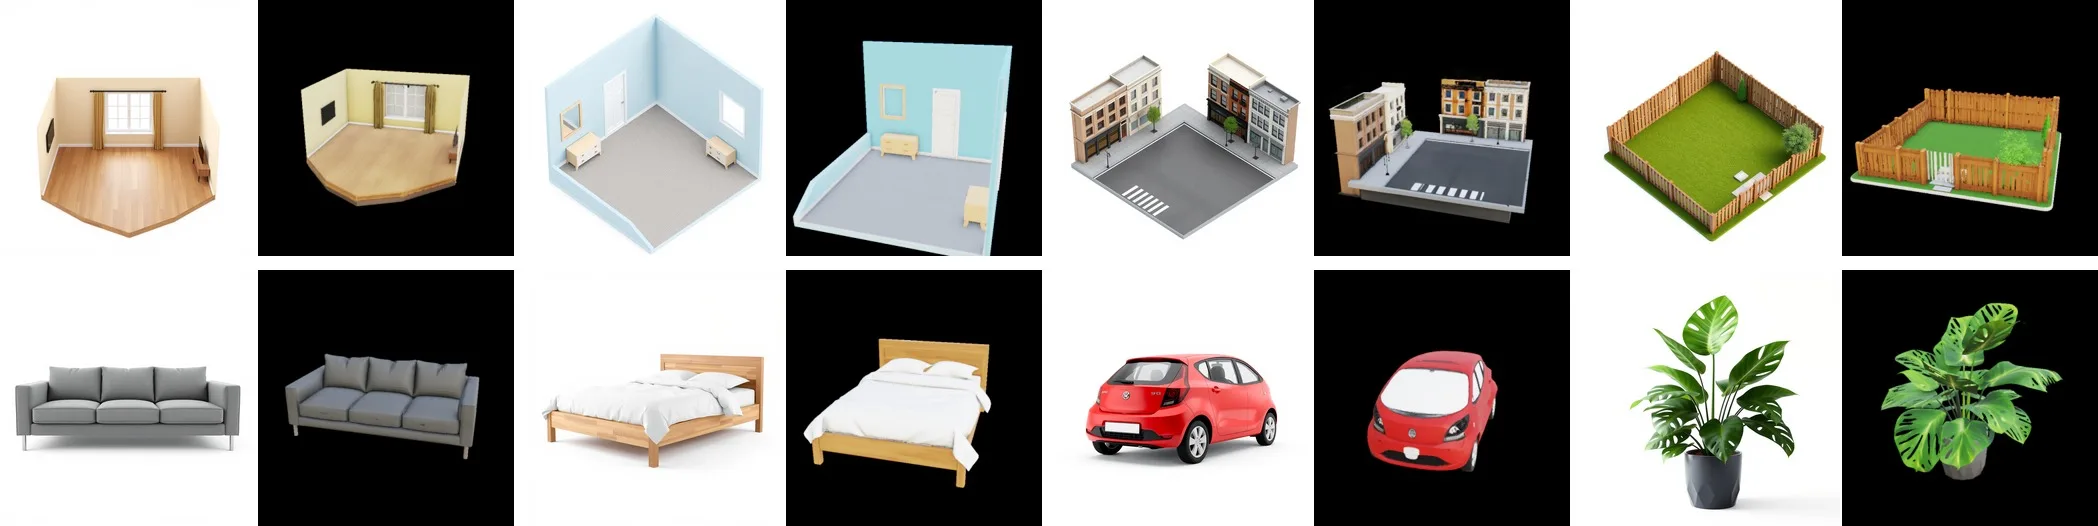
Jedes Objekt und jeder Raum beginnt als kurze Beschreibung. Ein Bildmodell zeichnet es, und TRELLIS.2 wandelt die Zeichnung in ein texturiertes 3D-Asset um (Abbildung 1).
2.2 Das schwierigste Asset ist ein leerer Raum
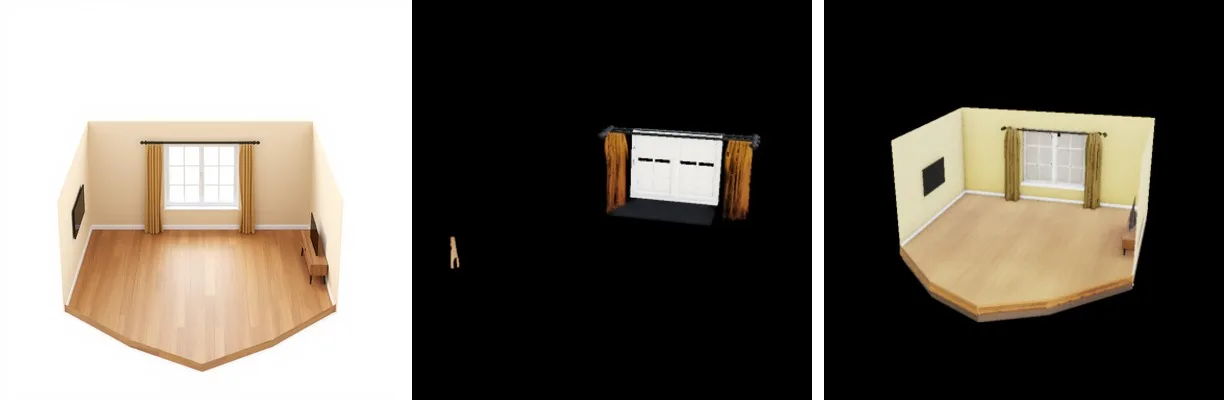
Ein leerer Raum ist überraschend schwer zu generieren. Die Standard-Hintergrundentfernung behandelt helle Wände und Böden als Hintergrund, sodass unser erstes „leeres Wohnzimmer“ als Fenster und zwei Vorhänge zurückkam. Das Maskieren von Umgebungen nach Farbe hält den gesamten Raum intakt (Abbildung 2).
2.3 Räume, die der Physik gehorchen
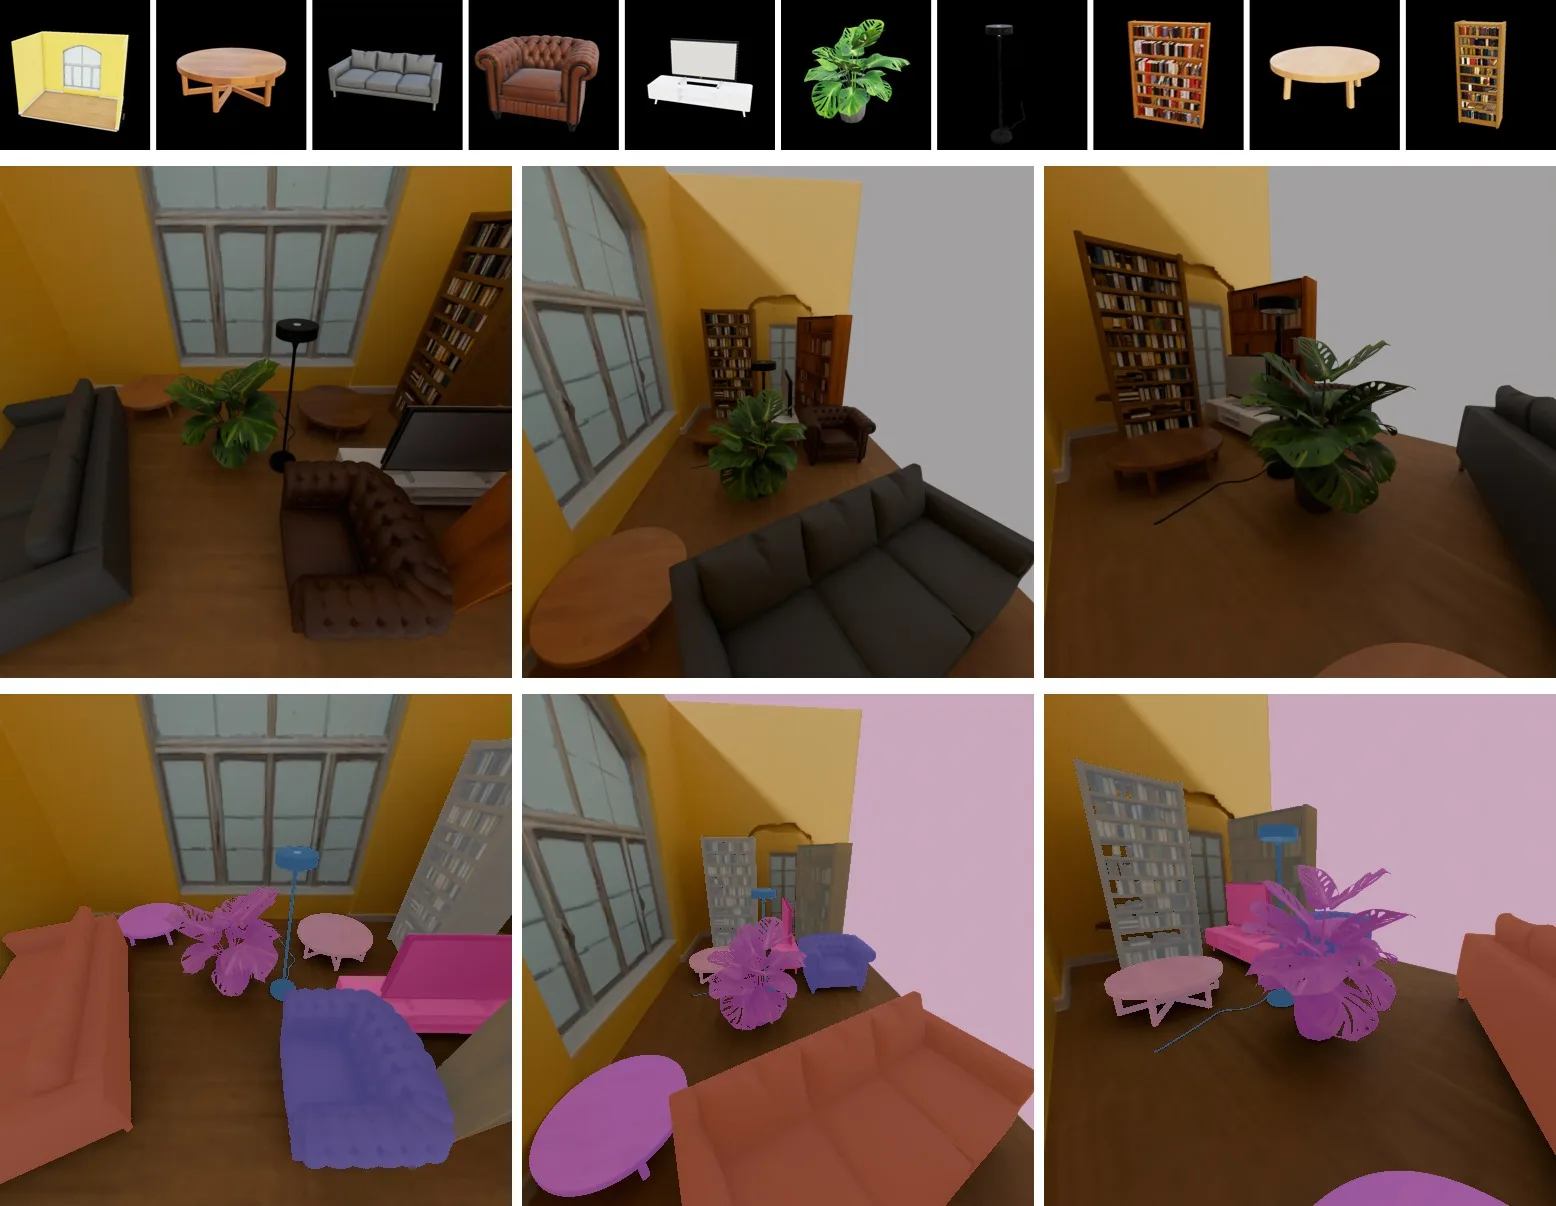
Jedes Objekt wird auf eine reale Auflagefläche fallen gelassen. Alles, was schwebt oder durch eine Wand geht, wird abgelehnt, und Kollisionen werden aufgelöst. Kameras zielen auf den möblierten Bereich, wobei das Sichtfeld an jedes Objekt angepasst wird, und nur Ansichten, in denen jedes Objekt sichtbar ist, werden beibehalten (Abbildung 3).
2.4 Im großen Maßstab
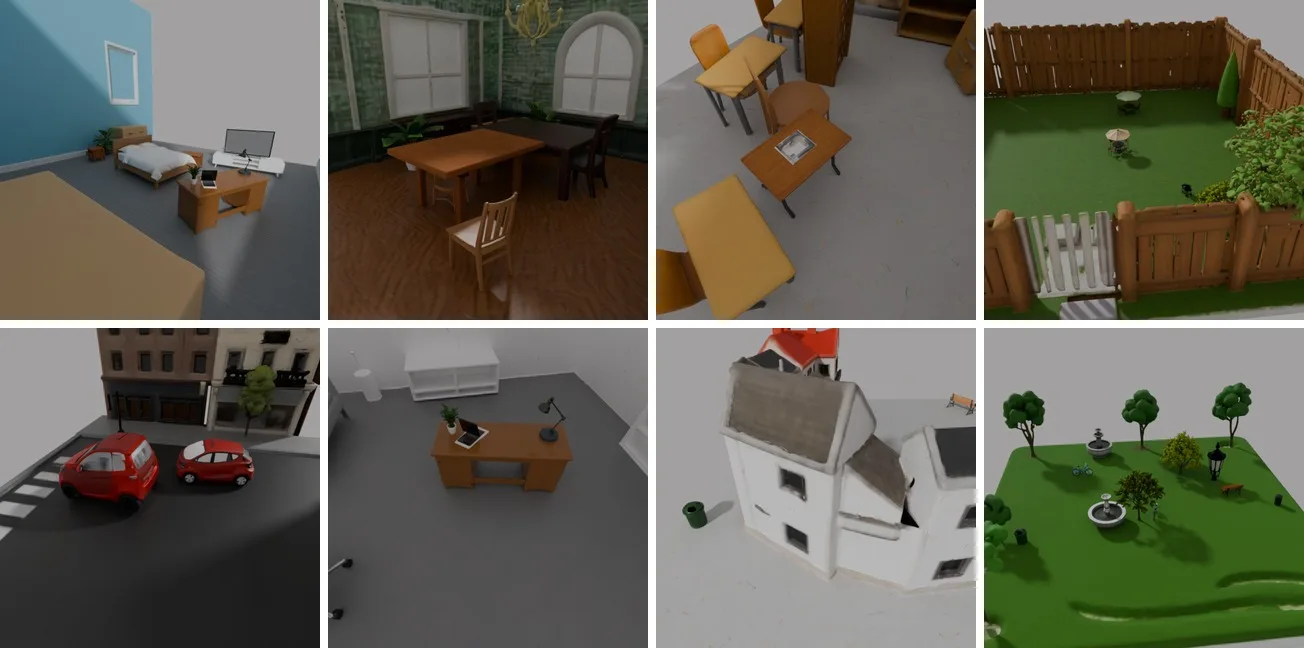
In weniger als einer Stunde produzierte die Fabrik 5.500 Assets in 16 Raumtypen und 89 Objektkategorien. Daraus wurden 10.216 Trainingsszenen mit jeweils etwa sechs Objekten zusammengestellt (Abbildung 4).
Der Maßstab deckte ein Problem auf, das der Pilot verborgen hatte: Bildmodelle ignorieren oft „keine Möbel“ und zeichnen trotzdem möblierte Räume, was das Gegenteil von Zerlegung lehrt. Unser geometrischer Filter blickt auf jeden Raum und misst, wie viel Boden frei ist. Er behielt 537 von 1.493 Umgebungen.
3 Szenen generieren, nicht Objekte
3.1 Eine Sequenz für den gesamten Raum
Alle Komponenten einer Szene, eine Umgebung und bis zu dreißig Objekte, teilen sich eine einzige Token-Sequenz über einen eingefrorenen 3D-Generator. Jedes Objekt kann auf jedes andere Objekt und auf den Raum um es herum achten.
3.2 Beginnend mit dem, was das Modell bereits weiß
Lernbare Typ- und Slot-Embeddings unterscheiden die Umgebung von Objekten und Objekte voneinander. Sie beginnen bei Null, sodass sich das Modell im ersten Trainingsschritt genau wie das vortrainierte verhält. Nur leichte Adapter werden trainiert.
3.3 Verfeinerung im eigenen Rahmen des Objekts
Objekte belegen nur wenige Voxel eines raumgroßen Rasters. Die Verfeinerung verschiebt jedes Objekt in seinen eigenen normalisierten Rahmen, generiert es neu, während es die gesamte Szene berücksichtigt, und platziert es genau dort zurück, wo es war.
3.4 Architektur
- Basismodell. TRELLIS.2-4B [1], ein Sparse-Voxel-Bild-zu-3D-Generator mit Flow-Matching-Transformatoren [3] für Struktur, Form und Textur.
- Adapter. LoRA [2] mit Rang 32 auf jeder Aufmerksamkeits- und MLP-Schicht: 37 Millionen trainierbare Parameter auf einem eingefrorenen Backbone.
- Faktorisierte Aufmerksamkeit. Dichte Aufmerksamkeit über eine 30-Komponenten-Szene kostet 43 Sekunden pro Trainingsschritt. In unserem Design achten fünf von dreißig Schichten über die Szene hinweg und der Rest innerhalb jeder Komponente, das Regime, in dem das Basismodell vortrainiert wurde. Dies ist etwa 3-mal billiger.
4 Ergebnisse
4.1 Ausrichtung an der Kamera
Die Bewertung in der realen Welt erfordert Vorhersagen im metrischen Rahmen der Kamera. Wir registrieren die generierte Szene mit der sichtbaren Tiefe und bewerten jede Kandidatenpose nach der Konsistenz der Tiefenkarte. Ohne dies kostet allein ein Skalierungsfehler von 5 % 26 Punkte des F-Scores.
4.2 Modellskalierung
LifeSim Interiors verbessert sich mit der Trainingsrechenleistung. Bei ungesehenen synthetischen Szenen steigt der F-Score bei 10 cm (höher ist besser) bei jedem Checkpoint und gewinnt jedes Mal etwa neun Punkte, wenn das Training verdoppelt wird (Tabelle 1).
| Trainingsschritte | 250 | 500 | 1,000 | 1,500 |
|---|---|---|---|---|
| F-Score@0.1 | 4.3% | 11.6% | 21.3% | 26.8% |
Die Pipeline selbst ist solide: Das Dekodieren von Ground-Truth-Latenten und deren Bewertung als Vorhersagen ergibt einen F-Score von 100 %. Das Modell erzielt auch bei Szenen, an denen es trainiert wurde, ungefähr den gleichen Wert wie bei neuen, ist also noch untertrainiert, nicht überangepasst. Das Modell hat einen kleinen Bruchteil der Trainingsrechenleistung gesehen, die diese Art von Methode normalerweise erhält.
5 Was als Nächstes kommt
Das Modell lernt; wir haben frühzeitig aufgehört. Drei Schritte folgen als Nächstes: länger trainieren, realistischere Räume komponieren und wirklich leere Umgebungen generieren.
Wir haben bereits einen Vorsprung beim zweiten Schritt. Unser Text-zu-Interieur-Labor schreibt Raumlayouts mit einem LLM und überprüft jedes Asset mit einem Vision-Modell. Diese Räume in die Weltfabrik einzuspeisen, ist unser nächstes Experiment.
Das zentrale Modell ist kompakt. Die meiste eigentliche Arbeit findet darum herum statt: glaubwürdige Welten herstellen, sie effizient rendern und die Ergebnisse ehrlich mit der Realität vergleichen. Wir werden mehr teilen, wenn LifeSim Interiors reifer wird.
Referenzen
- Xiang, J., Chen, X., Xu, S., Wang, R., Lv, Z., et al. Native and Compact Structured Latents for 3D Generation. arXiv:2512.14692, 2025.
- Hu, E. J., Shen, Y., Wallis, P., Allen-Zhu, Z., Li, Y., Wang, S., Wang, L., Chen, W. LoRA: Low-Rank Adaptation of Large Language Models. arXiv:2106.09685, 2021.
- Lipman, Y., Chen, R. T. Q., Ben-Hamu, H., Nickel, M., Le, M. Flow Matching for Generative Modeling. arXiv:2210.02747, 2022.
Zitat
Bitte zitiere diese Arbeit wie folgt:
@misc{lifesim2026interiors,
  title  = {LifeSim Interiors: From One Photo to a 3D Room You Can Take Apart},
  author = {{João Nobre} and {Cris Lenta}},
  year   = {2026},
  month  = {oct},
  url    = {https://lifesim.com/research/interiors}
}