


 English
 Español
 Português
 Bahasa Indonesia
 Română
 हिन्दी
 العربية
 Français
 Deutsch
 Русский
 Italiano
 Polski
 한국어
 简体中文
 Türkçe
 Kiswahili
 বাংলা
 Filipino
2026年10月10日
LifeSim Interiors:1枚の写真から分解可能な3Dルームへ
概要
私たちは、1枚の画像から分解された3Dシーン、つまり環境とすべてのオブジェクトをそれぞれ独自のメッシュとして適切な位置に生成する研究システムであるLifeSim Interiorsを発表します。このシステムは、TRELLIS.2 [1]を拡張し、環境と最大30個のオブジェクトを1つの共有フレーム内で同時に生成します。分解された3Dルームの大規模なデータセットが存在しないため、5,500個のアセットを生成し、10,216個の物理的に有効なトレーニングシーンを構成するパイプラインを構築しました。保留された合成シーンでは、トレーニングが250ステップから1,500ステップに増加するにつれて、10cmでのFスコアは4.3%から26.8%に上昇し、曲線はプラトーを示しません。
1 はじめに
3Dシーンは単なる表面ではありません。それは、配置を変えられる部屋、動かせるソファ、交換できる棚です。空間を理解するシステムは、単一の固定されたメッシュだけでなく、それらの部分を復元する必要があります。
LifeSim Interiorsは、環境とすべてのオブジェクトをそれぞれ独自のメッシュとして生成します。これは、オブジェクトからシーンへの蒸留に関する最近の研究と、MicrosoftのTRELLIS.2 [1]に基づいています。私たちはGoogle Cloud上で2日間でその周りのフルスタックを構築しました。私たちの貢献は次のとおりです。
- ワールドファクトリー: テキストが画像になり、画像が3Dアセットになり、アセットが物理的に有効な部屋になります(セクション2)。
- シーンジェネレーター: 環境と多くのオブジェクトを1つの共有フレーム内で同時に生成するように拡張された3Dオブジェクトモデル(セクション3)。
- オブジェクトの洗練: 各オブジェクトは、シーンの残りの部分に基づいて、より詳細に独自のフレームで再生成されます(セクション3.3)。
- 測定: 公開ベンチマークプロトコルと、生成されたシーンを実際のカメラのフレームに配置するための独自の方法(セクション4)。
2. 世界の生成
3Dルームを個別のパーツに分解した大規模なデータセットがないため、独自に作成しています。事前学習済みのオブジェクトジェネレーターがパーツを作り、当社のパイプラインがそれらを組み立ててルームを生成します。
2.1 言葉からパーツへ
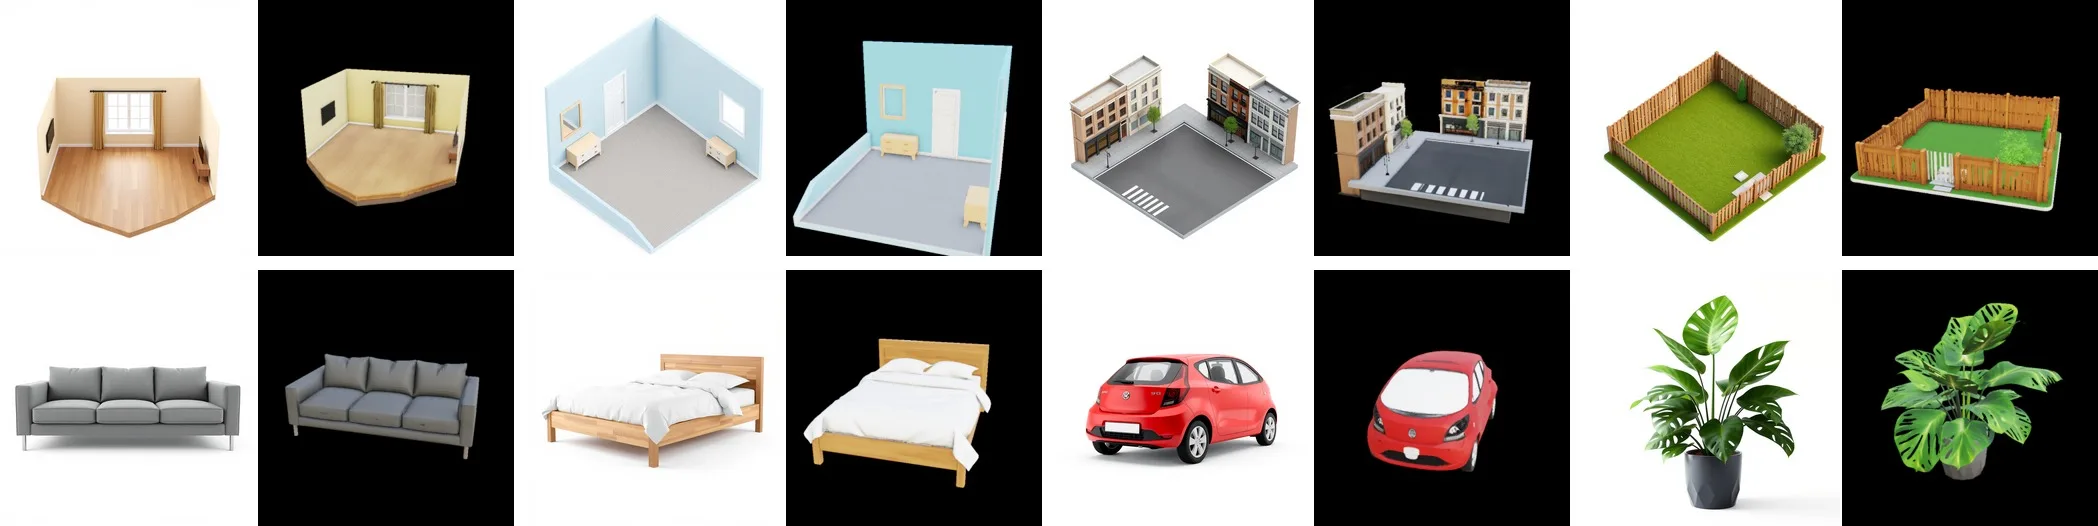
すべてのオブジェクトとルームは、短い説明から始まります。画像モデルがそれを描き、TRELLIS.2がその描画をテクスチャ付きの3Dアセットに変換します(図1)。
2.2 最も難しいアセット:空の部屋
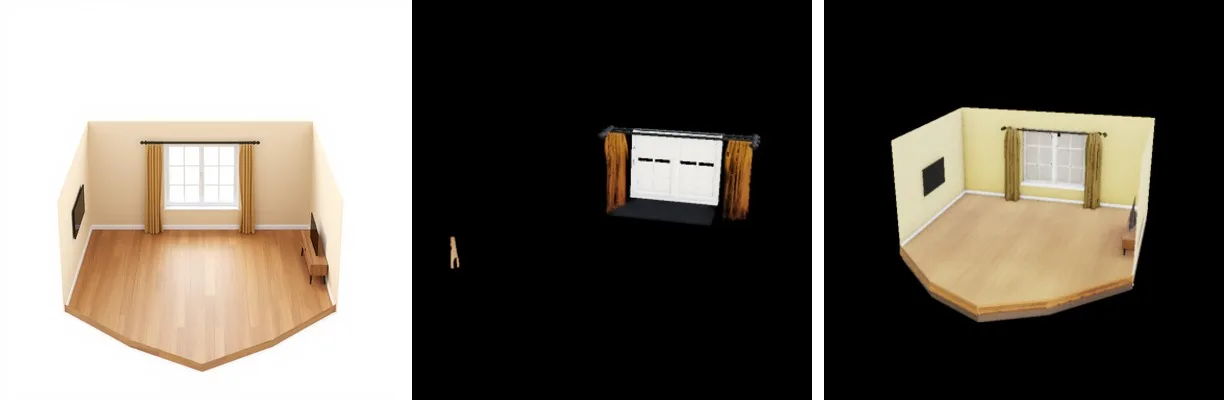
空の部屋の生成は驚くほど困難です。標準的な背景除去では、薄い壁や床が背景として扱われるため、最初の「空のリビングルーム」は窓と2枚のカーテンとして返されました。色による環境マスキングを使用することで、部屋全体をそのまま保持できます(図2)。
2.3 物理法則に従う部屋
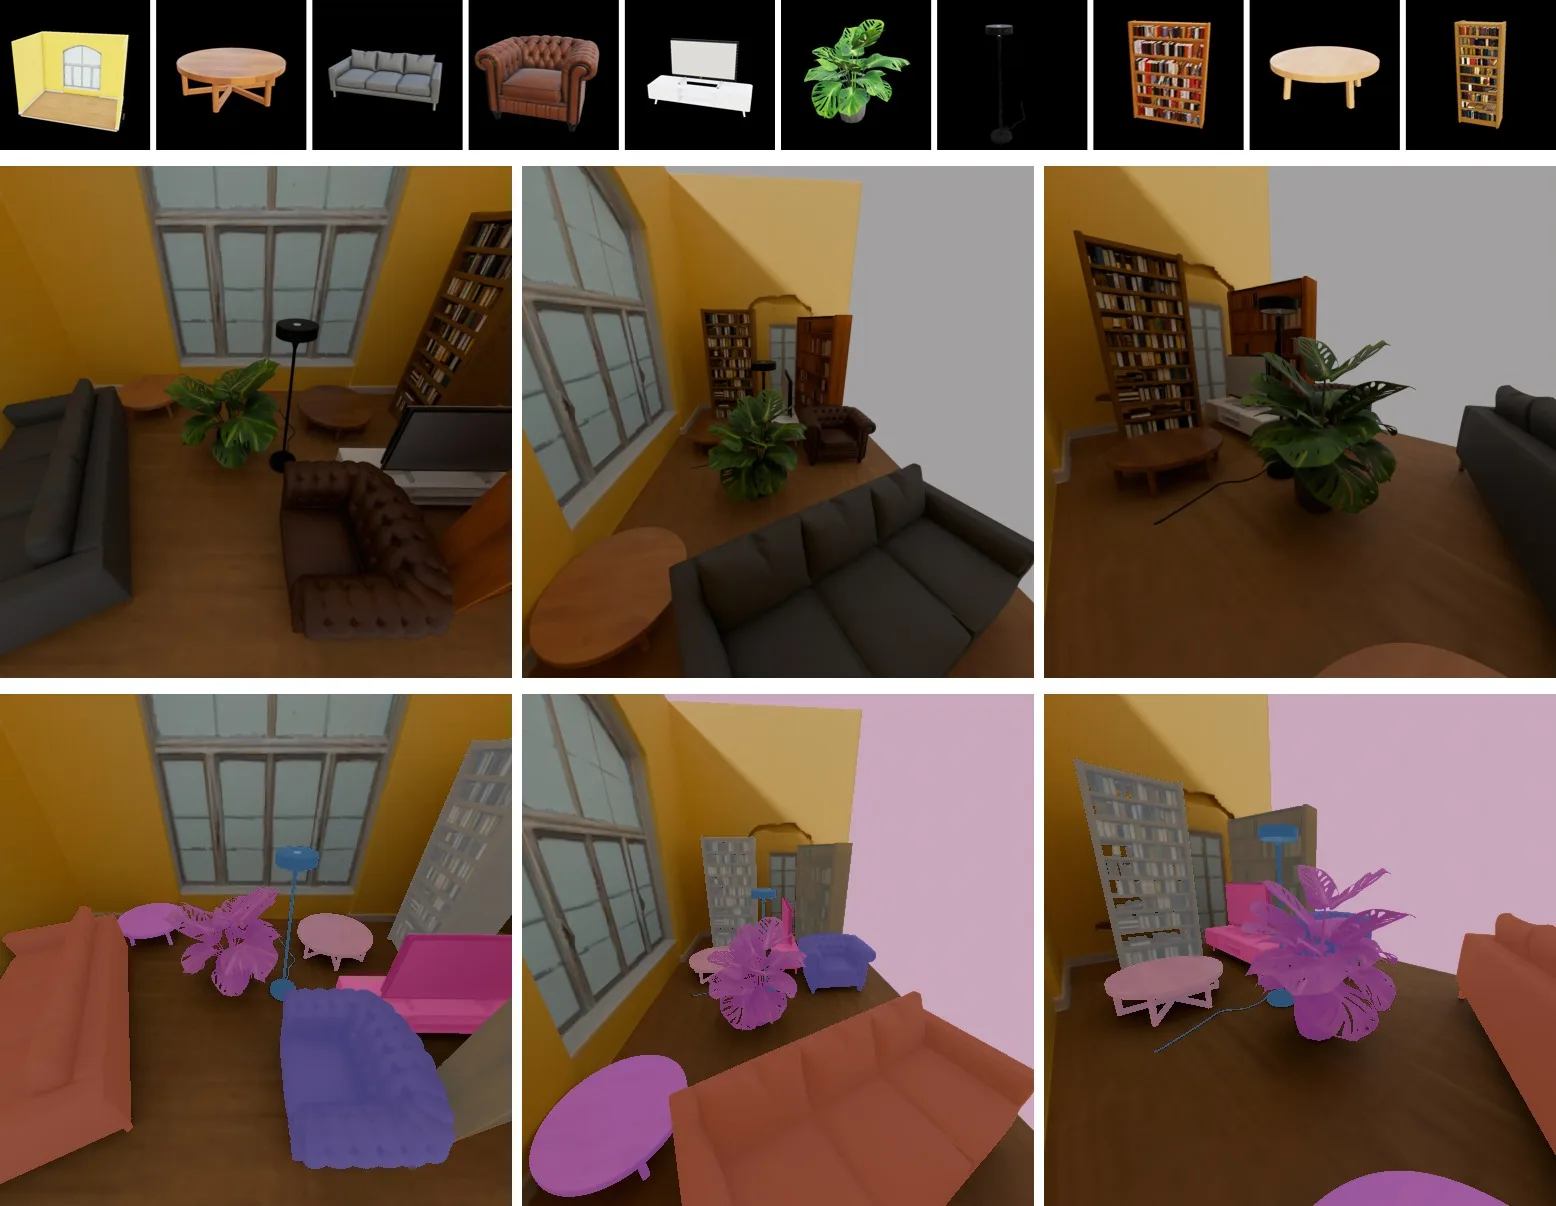
各オブジェクトは実際の支持面に配置されます。浮遊したり壁を通過したりするものはすべて拒否され、衝突は解決されます。カメラは家具が配置された領域を狙い、視野はすべてのオブジェクトに合わせて調整されます。すべてのオブジェクトが見えるビューのみが保持されます(図3)。
2.4 大規模な展開
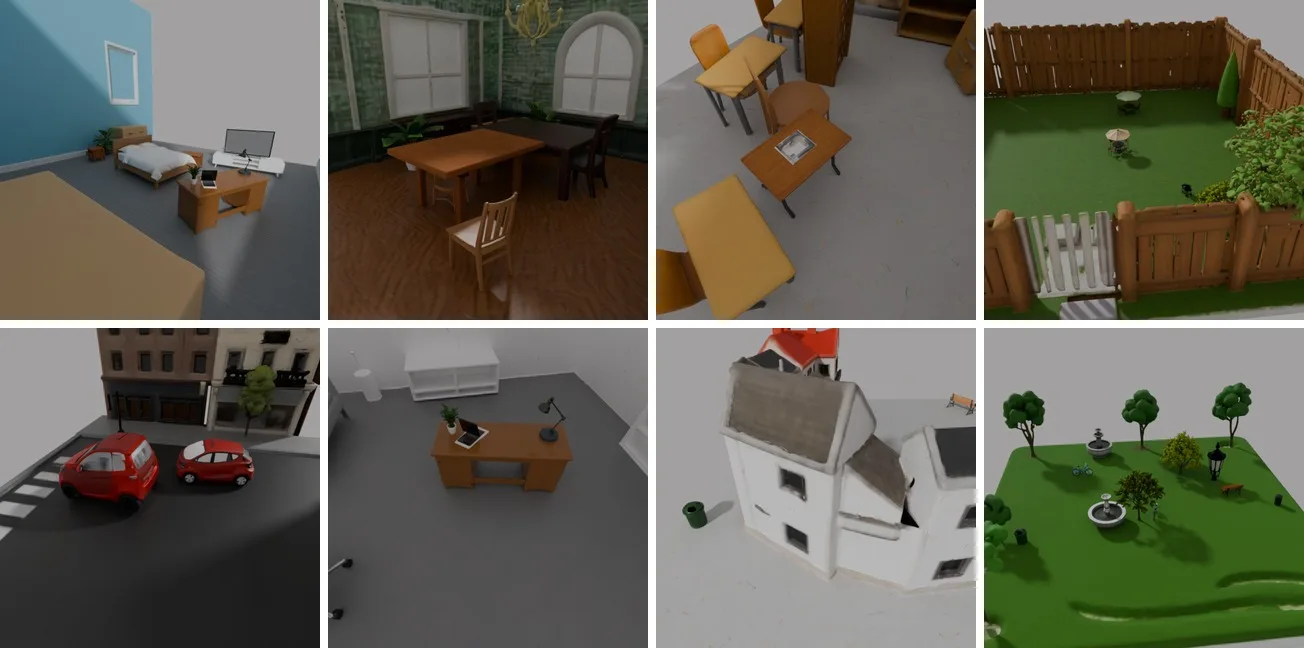
1時間足らずで、工場は16種類の部屋タイプと89種類のオブジェクトカテゴリにわたる5,500のアセットを生産しました。これらから、約6つのオブジェクトを含む10,216のトレーニングシーンが構成されました(図4)。
スケールによって、パイロット段階では隠れていた問題が露呈しました。画像モデルは「家具なし」を無視して家具付きの部屋を描画することが多く、これは分解とは逆の学習をさせてしまいます。当社の幾何学的フィルターは、各部屋を見下ろし、床の自由な部分を測定します。これにより、1,493の環境のうち537が保持されました。
3. オブジェクトではなくシーンの生成
3.1 部屋全体に対する1つのシーケンス
1つの環境と最大30個のオブジェクトからなるシーンのすべてのコンポーネントは、フリーズされた3Dジェネレーター上で単一のトークンシーケンスを共有します。各オブジェクトは、他のすべてのオブジェクトと周囲の部屋に注意を払うことができます。
3.2 モデルがすでに知っていることから始める
学習可能なタイプとスロットの埋め込みは、環境をオブジェクトから、オブジェクトを互いから区別します。これらはゼロから始まるため、最初のトレーニングステップでは、モデルは事前学習済みのモデルとまったく同じように動作します。軽量なアダプターのみがトレーニングされます。
3.3 オブジェクト自身のフレームでの洗練
オブジェクトは、部屋サイズのグリッドのわずかなボクセルしか占めません。洗練により、各オブジェクトは自身の正規化されたフレームに移動し、シーン全体に注意を払いながら再生成され、元の位置に正確に戻されます。
3.4 アーキテクチャ
- ベースモデル。 TRELLIS.2-4B [1] は、構造、形状、テクスチャにフローマッチングトランスフォーマー [3] を使用したスパースボクセル画像-3Dジェネレーターです。
- アダプター。 すべてのアテンション層とMLP層にランク32のLoRA [2] を適用:フリーズされたバックボーン上に37Mの学習可能なパラメーター。
- 因数分解されたアテンション。 30コンポーネントのシーンに対する密なアテンションは、トレーニングステップあたり43秒かかります。私たちの設計では、30層のうち5層がシーン全体にアテンションを払い、残りは各コンポーネント内でアテンションを払います。これは、ベースモデルが事前学習されたレジームです。これにより、約3倍のコスト削減が実現します。
4 結果
4.1 カメラへのアライメント
実世界での評価には、カメラのメートル法フレームでの予測が必要です。生成されたシーンを可視深度に登録し、深度マップの一貫性によって各候補ポーズを評価します。これがないと、5%のスケール誤差だけでFスコアが26ポイント低下します。
4.2 モデルのスケーリング
LifeSim Interiorsは、トレーニング計算量とともに改善されます。保持された合成シーンでは、10cmでのFスコア(高いほど良い)は各チェックポイントで上昇し、トレーニングが2倍になるたびに約9ポイント増加します(表1)。
| トレーニングステップ | 250 | 500 | 1,000 | 1,500 |
|---|---|---|---|---|
| Fスコア@0.1 | 4.3% | 11.6% | 21.3% | 26.8% |
パイプライン自体は健全です。グラウンドトゥルースの潜在変数をデコードし、それを予測として評価すると、Fスコアは100%になります。モデルは、トレーニングしたシーンと新しいシーンでほぼ同じスコアを出すため、まだトレーニング不足であり、過学習ではありません。この種のメソッドに通常与えられるトレーニング計算量のごく一部しかモデルは見ていません。
5. 次のステップ
モデルは学習中ですが、早期に停止しました。次の3つのステップがあります:より長くトレーニングする、より現実的な部屋を構成する、そして真に空の環境を生成する。
2番目のステップについては、すでに先行しています。当社のテキスト-インテリアラボは、LLMで部屋のレイアウトを作成し、ビジョンモデルですべてのアセットをチェックしています。これらの部屋をワールドファクトリーに供給することが、次の実験です。
中心にあるモデルはコンパクトです。実際の作業のほとんどは、その周りに存在します。信じられる世界を製造し、それらを効率的にレンダリングし、現実のものと正直に結果を比較することです。LifeSim Interiorsが成熟するにつれて、さらに多くのことを共有していきます。
参考文献
- Xiang, J., Chen, X., Xu, S., Wang, R., Lv, Z., et al. Native and Compact Structured Latents for 3D Generation. arXiv:2512.14692, 2025.
- Hu, E. J., Shen, Y., Wallis, P., Allen-Zhu, Z., Li, Y., Wang, S., Wang, L., Chen, W. LoRA: Low-Rank Adaptation of Large Language Models. arXiv:2106.09685, 2021.
- Lipman, Y., Chen, R. T. Q., Ben-Hamu, H., Nickel, M., Le, M. Flow Matching for Generative Modeling. arXiv:2210.02747, 2022.
引用
この作品を引用する際は、以下のように記載してください:
@misc{lifesim2026interiors,
  title  = {LifeSim Interiors: From One Photo to a 3D Room You Can Take Apart},
  author = {{João Nobre} and {Cris Lenta}},
  year   = {2026},
  month  = {oct},
  url    = {https://lifesim.com/research/interiors}
}