


 English
 Español
 Português
 Bahasa Indonesia
 Română
 हिन्दी
 العربية
 Français
 Deutsch
 Русский
 Italiano
 Polski
 日本語
 简体中文
 Türkçe
 Kiswahili
 বাংলা
 Filipino
2026년 10월 27일
아담 & 이브: 미세 조정된 의사 결정 모델을 통한 700개의 LLM 제어 근육
초록
아담과 이브는 각각 700개의 근육을 가진 두 명의 시뮬레이션된 인간으로, 샌프란시스코의 Palace of Fine Arts에서 함께 살고 있습니다. 언어 모델은 언어 모델이 실행할 수 있는 모든 계층을 실행합니다. 즉, 하루 동안 무엇을 할지, 어디로 걸어갈지, 균형을 유지하는 방법, 각 발이 어디에 착지할지, 각 근육이 얼마나 세게 당겨질지 등을 결정합니다. 이 모델 중 세 가지는 저희 자체 모델입니다. 1억 4,400만 개의 매개변수를 가진 미세 조정 모델로, CPU에서 각각 4분에서 11분 만에 훈련되었으며, 이전에 본 적 없는 입력에 대해 0.958에서 0.9998의 상관관계로 교사를 모방합니다. 하네스 없이도 두 몸은 80N의 밀림을 견디고 넘어지기 전에 수십 걸음을 걷습니다. 이것은 실험이며 제품이 아닙니다. 우리는 작동하는 것, 작동하지 않는 것, 그리고 수치를 보고합니다.
1. 실험
기술이 너무 빠르게 발전하고 있어서 시뮬레이션이 다음에 어디로 갈지 아무도 모릅니다. 1년 전에는 언어 모델이 대화를 나눌 수 있었습니다. 오늘날에는 일주일을 계획하고, 도구를 사용하며, 몇 시간 동안 실행할 수 있습니다. 우리는 그 한계가 어디인지 모르기 때문에 찾아보려고 노력했습니다.
질문은 간단했습니다. 언어 모델이 얼마나 깊이 들어갈 수 있을까? LifeSim의 사람들은 이미 언어 모델로 생각합니다. 그들은 무엇을 할지, 누구와 이야기할지, 어디로 갈지 결정합니다. 그 아래에서는 모든 게임이 애니메이션을 사용합니다. 걷는 몸은 녹화된 것을 재생하는 몸입니다.
우리는 녹화된 것을 몸으로 대체했습니다. MS-Human-700 [1]은 MuJoCo [2]에서 시뮬레이션된 700개의 근육을 가진 인간 근골격계의 오픈 모델입니다. 우리는 실제 지도로 만들어진 바닥에 두 개의 모델을 배치하고, 언어 모델에 가능한 모든 결정을 맡겼습니다. 우리는 그것이 설 수 있을지 몰랐습니다. 하지만 설 수 있었습니다.
2. 계층
우리는 몸과 마음의 계층을 복사하고, 언어 모델이 될 수 있는 각 계층을 하나씩 주었습니다(표 1). 척수만이 코드입니다. 척수는 “조금 뒤로 기대세요” 또는 “발을 여기에 놓으세요”를 700개의 근육 당김으로 바꿉니다.
| 계층 | 사람에게서 | 모델 | 얼마나 자주 |
|---|---|---|---|
| 삶 | 하루 동안 무엇을 할지 | Gemma 3 4B [3], LifeSim Week에서 GRPO [4]로 미세 조정됨 | 활동당 한 번, 약 4초 |
| 운동 피질 | “저기로 걸어가, 몸통을 지탱해” | Gemini 3.1 Flash-Lite | 약 1초에 한 번, 약 1초 |
| 뇌간 | 몸을 똑바로 세움 | LifeSim-Brainstem-0.1 (저희 모델) | 틱당 2개의 질문, 서 있는 상태 |
| 걸음 결정 | 다음 발이 착지할 위치 | LifeSim-Step-0.3 (저희 모델) | 틱당 2개의 질문, 걷는 상태 |
| 척수 | 고정된 배선 | 코드 | 매 틱마다 |
| 근육 | 수축 | LifeSim-Muscle-0.1 (저희 모델) | 사람당 틱당 700개의 질문 |
모든 계층은 단어로 말합니다. 뇌간은 “무게가 발 중앙에서 3cm 앞에 있고, 4cm/s로 앞으로 움직이고 있습니다”를 읽고 어떻게 기울여야 할지 답합니다. 각 근육은 운동 피질에서 해당 신체 부위의 선과 척수에서 오는 충동을 읽고 얼마나 세게 수축해야 할지 답합니다.
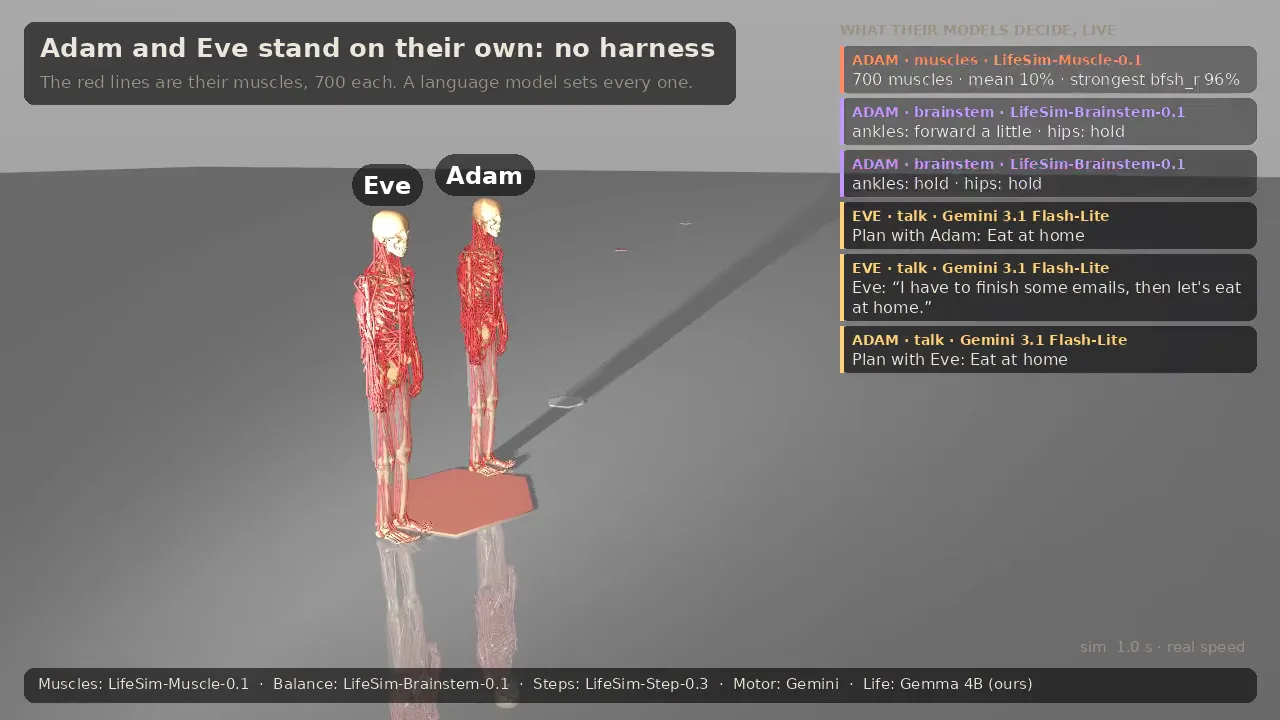
아담과 이브는 서로에 대해서도 알고 있습니다. 각 생명 모델은 파트너가 어디에 있고 무엇을 하는지 읽습니다. 둘이 만나면 Gemini는 각자에게 한 줄씩 쓰고, 그들은 계획에 동의할 수 있습니다. “나중에 키바츠에서 저녁 먹을까?” (그림 3).
3. 세 가지 작은 모델
가장 낮은 세 계층은 10ms마다 최대 1,400개의 질문에 답해야 하므로 작은 모델이 필요합니다. 우리는 ModernBERT [5] 인코더(22개 계층, 숨겨진 크기 384)에 결정 헤드를 추가하여 구축된 1억 4,400만 개의 매개변수를 가진 Julia 1 모델을 사용하고, 세 개의 복사본을 미세 조정했습니다. 각 모델은 코드에 작성된 교사로부터 학습했습니다. 즉, 코드 뇌간, 코드 단계 규칙 및 근육 공식입니다.
| 모델 | CPU에서 훈련 | 기본 Julia 1 | 미세 조정됨 |
|---|---|---|---|
| LifeSim-Brainstem-0.1 | 216 s | r = −0.37 | r = 0.9997 |
| LifeSim-Step-0.3 | 308 s | r = 0.24 | r = 0.9998 |
| LifeSim-Muscle-0.1 | 642 s | r = 0.12 | r = 0.958 |
보류된 입력에 대한 높은 상관관계만으로는 걷기에 충분하지 않습니다. 단계 모델은 처음에 코드 규칙이 만난 상황에서만 학습했으며, 일단 제어권을 잡으면 규칙이 본 적 없는 상황으로 몸을 이끌었습니다. 우리는 그것이 걷도록 허용하고, 만난 것을 기록하고, 규칙에게 무엇을 했을지 물어보고, 다시 훈련했습니다(DAgger [6]). 걷는 시간은 교사의 83%에서 92%로 증가했습니다.
미세 조정은 결정론적이므로 동일한 질문에는 항상 동일한 답변이 나옵니다. 우리는 모든 답변을 유지하고 모델에 본 적 없는 질문만 합니다. 몇 초 후에는 대부분의 틱에서 모델 호출이 전혀 필요하지 않습니다.
4. 결과
4.1. 서기
모든 계층이 언어 모델에 있을 때, 두 몸은 하네스 없이 서 있고 앞뒤에서 80N의 밀림에서 회복합니다. 20번의 밀림 서기에서 뇌간 모델은 교사와 동일한 시간 동안 서 있습니다. 12.0초 대 12.4초.
4.2. 걷기
보행자는 근육에 SIMBICON [7]을 사용합니다. 즉, 걸음 타이머, 스윙 다리, 그리고 무게의 위치와 속도에서 발 배치입니다. 하네스 없이 몸은 약 0.25m/s로 걸으며 목표를 향해 조종합니다. 라이브 시뮬레이션에서 중간 보행은 넘어지기 전에 18걸음 지속되었고, 가장 긴 보행은 133걸음 지속되었습니다(그림 2).
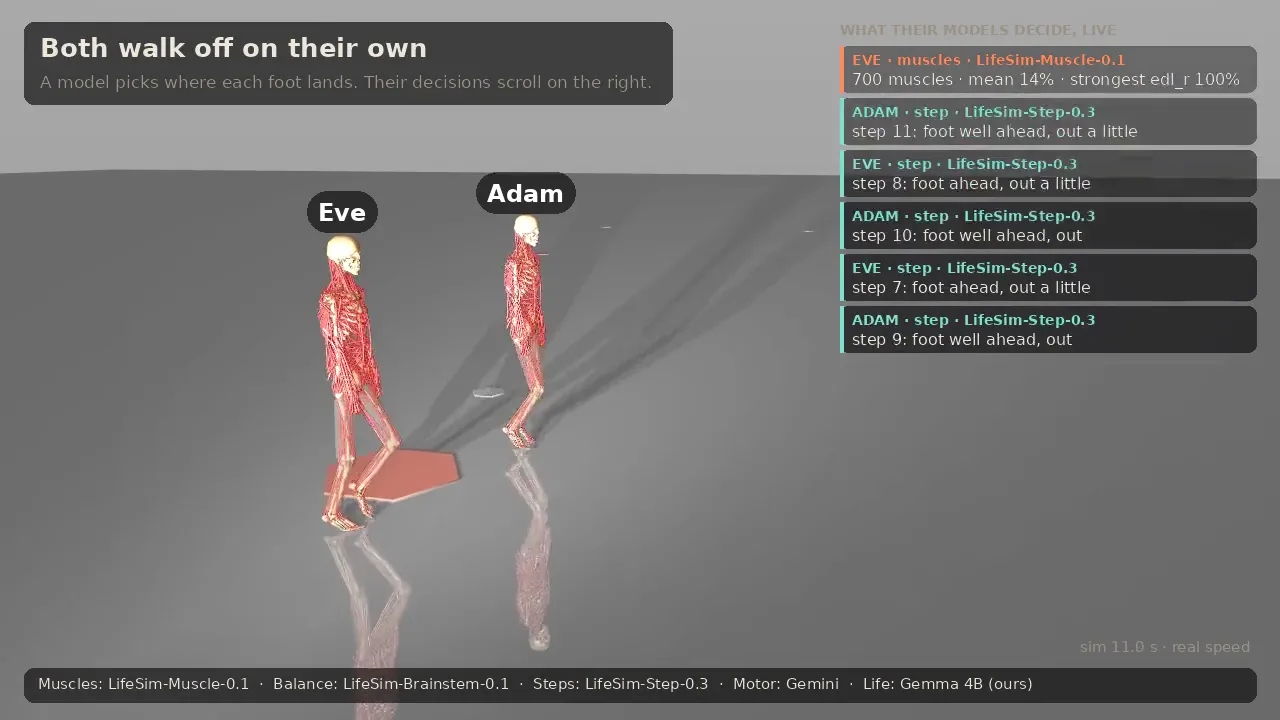
12초 걷기에서 단계 모델은 평균 8.6초 동안 몸을 지탱하며, 이를 가르친 코드 규칙은 9.4초 동안 지탱합니다(24번 걷기). 서 있는 것은 작은 오류를 용서합니다. 걷는 것은 그렇지 않습니다.
4.3. 속도
모든 것은 GPU 없이 하나의 CPU 머신에서 실행됩니다. 균형을 잡으려면 10ms마다 결정이 필요하므로 시뮬레이션은 모델을 기다립니다(“느린 시간”). 모든 모델을 가진 두 몸은 실제 시간의 0.25~0.5배로 실행되며, 둘 다 그려질 때는 0.12~0.18배로 실행됩니다.
4.4. LifeSim에서
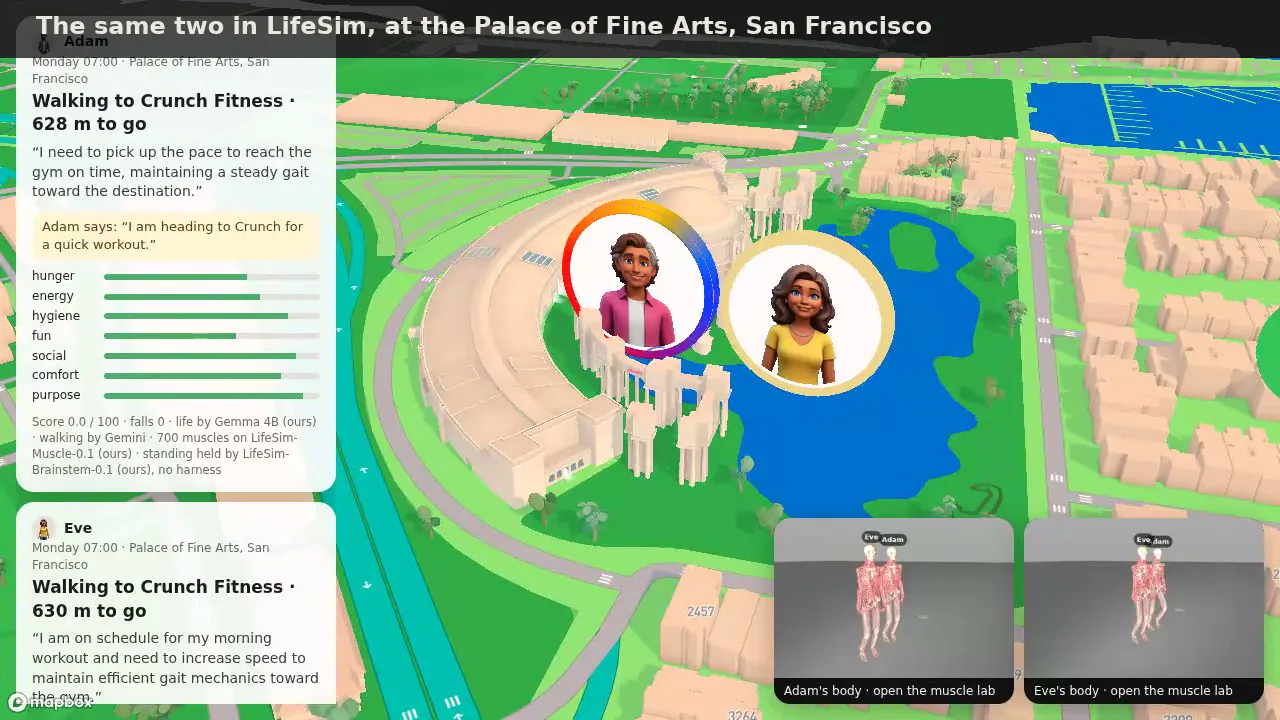
동일한 두 사람이 LifeSim 지도에 나타나며, 그들의 필요, 계획, 그리고 서로에게 하는 말이 표시됩니다(그림 3).
5. 우리가 배운 것
- 단어는 숫자를 포함해야 합니다. “조금 앞으로 기울이기”는 균형을 잡기에는 너무 모호합니다. 몸은 3~6초 안에 넘어졌습니다. “무게가 발 중앙에서 3cm 앞에 있고, 4cm/s로 앞으로 움직이고 있습니다”는 몸을 지탱합니다.
- 뇌의 단어는 근육의 해상도를 설정합니다. “가만히 서 있기” 아래에서 근육 모델은 약 15% 단계로 응답합니다. “미세 제어로 안정적으로 유지하기” 아래에서는 단계가 약 10%이며, 그때서야 몸이 앞에서 밀리는 것을 견딜 수 있습니다.
- 근육은 운동 뉴런처럼 작동합니다. 근육 모델은 거친 단계로 응답합니다. 발사 속도처럼 틱마다 인접한 단계를 번갈아 사용하면 걷는 시간이 약 50% 더 길어집니다.
- 걷기는 예측 불가능합니다. 이득을 백만 분의 일만 바꿔도 걷는 시간이 3분의 1이나 달라집니다. 한 번의 시도만으로는 알 수 없으므로, 여기에 있는 모든 걷기 수치는 12회 이상 걷기의 평균값입니다.
6 아직 구현되지 않은 기능
- 멈추기. 걷던 몸이 균형을 잃으면 1초 안에 넘어집니다. 20번 시도 중 한 번도 서 있지 못했습니다. 도착하면 몸은 서 있는 자세로 자연스럽게 전환됩니다. 이것은 애니메이션이며, 그렇게 분류됩니다.
- 일어나기. 넘어진 후, 몸은 1초 안에 다시 서 있는 자세로 돌아옵니다. 이것도 애니메이션입니다.
- 다른 속도. 보행자가 설정된 속도에서만 작동합니다.
- 추가 조정. 세 가지 탐색 방법(진화, CMA-ES, 증강 무작위 탐색)으로는 보행자를 개선할 수 없었습니다. 더 안정적인 보행자를 만들려면 전신 컨트롤러나 GPU에서 강화 학습으로 훈련된 정책이 필요합니다.
7 시도한 이유
저희는 최고의 보행자를 만들려고 한 것이 아닙니다. 강화 학습이 더 나은 보행자를 만듭니다. 저희는 한 종류의 모델이 “오늘 저녁에 무엇을 할까”부터 “어떤 근육이 얼마나 세게 당겨야 할까”까지 구현할 수 있는지 확인하려고 했습니다. 중간에 몇 줄의 코드를 추가하면 가능합니다. CPU에서 몇 분 안에 미세 조정된 작은 오픈 모델이 대부분의 레이어를 처리할 수 있습니다.
이것이 무엇을 위한 것인지는 아직 모릅니다. 아마 LifeSim에서 애니메이션이 재생되기 때문이 아니라 스스로 결정해서 움직이는 사람들을 위한 것일 수도 있습니다. 아니면 아무것도 아닐 수도 있고요. 기술은 너무 빠르게 발전하고 있어서 단정하기 어렵습니다. 이것이 바로 지금과 같은 시도를 하고 저희가 발견한 것을 공유하는 이유입니다.
8 향후 계획
가장 유망한 결과는 단어가 몸을 변화시킨다는 것입니다. “정밀한 제어로 안정적으로 유지”는 “가만히 서 있기”보다 근육에 더 미세한 해상도를 제공했으며, 그제서야 몸이 앞에서 밀치는 것을 견뎌냈습니다. 다음 실험은 “피곤한 것처럼 걷기”, “밀치는 것에 대비하기” 또는 “긴장을 풀기”와 같은 다른 단어에 반응하는 동일한 몸을 보여주는 것입니다. 코드 컨트롤러는 그런 지시를 받을 수 없습니다. 언어 모델은 가능합니다.
참고 문헌
- Zuo, C., He, K., Shao, J., Sui, Y. Self Model for Embodied Intelligence: Modeling Full-Body Human Musculoskeletal System and Locomotion Control with Hierarchical Low-Dimensional Representation. ICRA, 2024.
- Todorov, E., Erez, T., Tassa, Y. MuJoCo: A physics engine for model-based control. IROS, 2012.
- Gemma Team. Gemma 3 Technical Report. arXiv:2503.19786, 2025.
- Shao, Z., Wang, P., Zhu, Q., Xu, R., Song, J., et al. DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models. arXiv:2402.03300, 2024.
- Warner, B., Chaffin, A., Clavié, B., Weller, O., Hallström, O., et al. Smarter, Better, Faster, Longer: A Modern Bidirectional Encoder for Fast, Memory Efficient, and Long Context Finetuning and Inference. arXiv:2412.13663, 2024.
- Ross, S., Gordon, G. J., Bagnell, J. A. A Reduction of Imitation Learning and Structured Prediction to No-Regret Online Learning. AISTATS, 2011.
- Yin, K., Loken, K., van de Panne, M. SIMBICON: Simple Biped Locomotion Control. ACM SIGGRAPH, 2007.
인용
이 자료는 다음과 같이 인용해 주세요:
@misc{lifesim2026adamandeve,
  title  = {Adam & Eve: 700 LLM-Controlled Muscles via Fine-Tuned Decision Models},
  author = {{Cris Lenta}},
  year   = {2026},
  month  = {oct},
  url    = {https://lifesim.com/research/adam-and-eve}
}