


 English
 Español
 Português
 Bahasa Indonesia
 Română
 हिन्दी
 العربية
 Français
 Русский
 Italiano
 Polski
 한국어
 日本語
 简体中文
 Türkçe
 Kiswahili
 বাংলা
 Filipino
27. Okt. 2026
Adam & Eva: 700 LLM-gesteuerte Muskeln über feinabgestimmte Entscheidungsmodelle
Zusammenfassung
Adam und Eva sind zwei simulierte Menschen mit jeweils 700 Muskeln, die zusammen im Palace of Fine Arts in San Francisco leben. Sprachmodelle steuern jede Schicht, die ein Sprachmodell steuern kann: was sie tagsüber tun, wohin sie gehen, wie sie das Gleichgewicht halten, wo jeder Fuß landet und wie stark jeder Muskel zieht. Drei dieser Modelle sind unsere eigenen: 144M-Parameter-Feinabstimmungen, die auf einer CPU in 4 bis 11 Minuten trainiert wurden und ihre Lehrer mit einer Korrelation von 0,958 bis 0,9998 bei noch nie gesehenen Eingaben kopieren. Ohne Gurt stehen beide Körper 80 N Stöße aus und gehen ein paar Dutzend Schritte zwischen den Stürzen. Dies ist ein Experiment, kein Produkt. Wir berichten, was funktioniert, was nicht und die Zahlen.
1 Ein Experiment
Die Technologie entwickelt sich so schnell, dass niemand weiß, wohin die Simulation als Nächstes geht. Vor einem Jahr konnte ein Sprachmodell ein Gespräch führen. Heute kann es eine Woche planen, Werkzeuge benutzen und stundenlang laufen. Wir wissen nicht, wo die Grenze ist, also haben wir versucht, sie zu finden.
Die Frage war einfach: Wie weit kann ein Sprachmodell gehen? Die Menschen in LifeSim denken bereits mit Sprachmodellen. Sie entscheiden, was sie tun, mit wem sie sprechen und wohin sie gehen. Darunter verwendet jedes Spiel Animationen. Ein Körper, der geht, ist ein Körper, der eine Aufzeichnung abspielt.
Wir haben die Aufzeichnung durch einen Körper ersetzt. MS-Human-700 [1] ist ein offenes Modell des menschlichen Bewegungsapparates mit 700 Muskeln, simuliert in MuJoCo [2]. Wir haben zwei davon in eine Szene auf einem Boden aus der realen Karte gesetzt und jede Entscheidung, die wir treffen konnten, einem Sprachmodell überlassen. Wir wussten nicht, ob es stehen würde. Es tat es.
2 Die Schichten
Wir haben die Schichten eines Körpers und eines Geistes kopiert und jede Schicht, die ein Sprachmodell sein kann, einer zugewiesen (Tabelle 1). Nur das Rückenmark ist Code: Es wandelt „etwas zurücklehnen“ oder „den Fuß hier platzieren“ in 700 Muskelzüge um.
| Schicht | Bei einer Person | Modell | Wie oft |
|---|---|---|---|
| Leben | Was man mit dem Tag anfangen soll | Gemma 3 4B [3], von uns mit GRPO [4] auf LifeSim Week feinabgestimmt | Einmal pro Aktivität, ~4 s |
| Motorischer Kortex | „Geh dorthin, stütze den Rumpf“ | Gemini 3.1 Flash-Lite | Etwa einmal pro Sekunde, ~1 s |
| Hirnstamm | Hält dich aufrecht | LifeSim-Hirnstamm-0.1 (unseres) | 2 Fragen pro Tick, stehend |
| Schrittentscheidung | Wo der nächste Fuß landet | LifeSim-Schritt-0.3 (unseres) | 2 Fragen pro Tick, gehend |
| Rückenmark | Feste Verdrahtung | Code | Jeder Tick |
| Muskeln | Kontrahieren | LifeSim-Muskel-0.1 (unseres) | 700 Fragen pro Tick, pro Person |
Jede Schicht spricht in Worten. Der Hirnstamm liest „das Gewicht ist 3 cm vor der Mitte der Füße, bewegt sich mit 4 cm/s vorwärts“ und antwortet, wie man sich lehnen soll. Jeder Muskel liest die Zeile seiner Körperregion vom motorischen Kortex und einen Impuls vom Rückenmark und antwortet, wie stark er sich zusammenziehen soll.
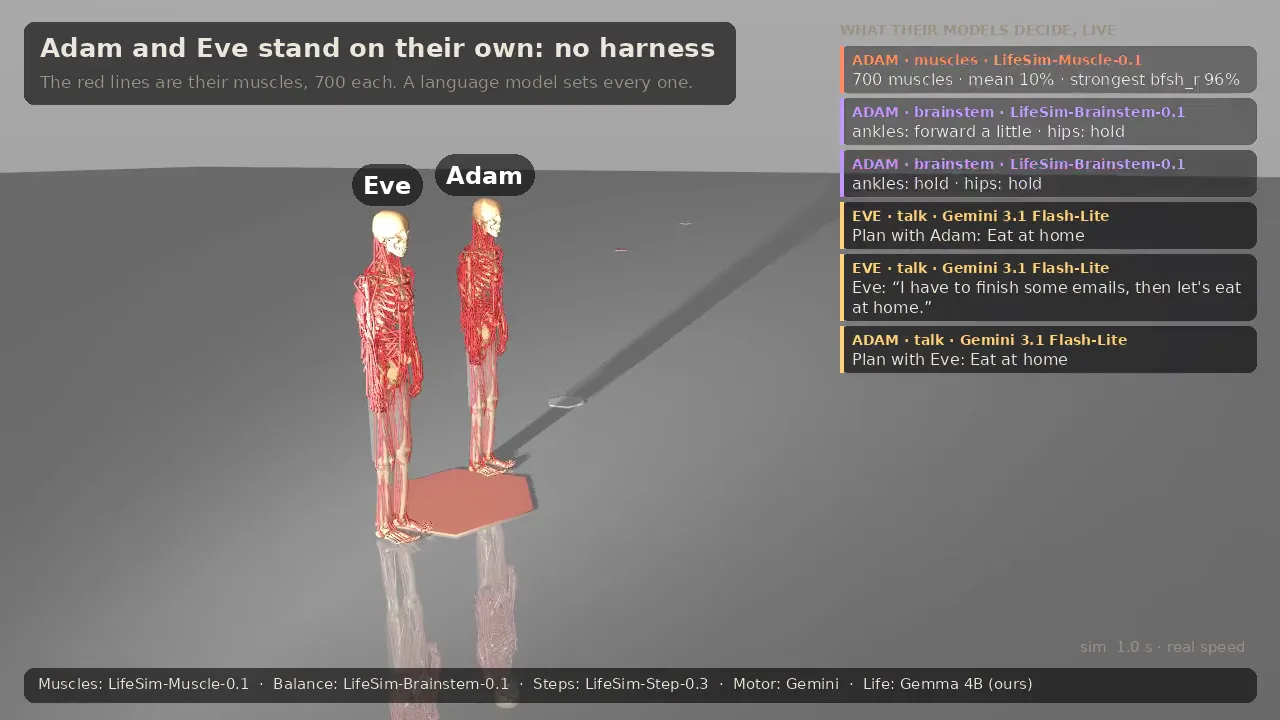
Adam und Eva wissen auch voneinander. Jedes Lebensmodell liest, wo der Partner ist und was er tut. Wenn die beiden sich treffen, schreibt Gemini eine Zeile für jeden von ihnen, und sie können sich auf einen Plan einigen: „Wollen wir später im Kibatsu zu Abend essen?“ (Abbildung 3).
3 Drei kleine Modelle
Die drei untersten Schichten beantworten bis zu 1.400 Fragen alle 10 ms, daher benötigen sie ein kleines Modell. Wir verwendeten Julia 1, ein 144M-Parameter-Modell, das auf einem ModernBERT [5] Encoder (22 Schichten, versteckte Größe 384) mit einem Entscheidungs-Head aufgebaut ist, und haben drei Kopien feinabgestimmt. Jede lernte von einem in Code geschriebenen Lehrer: dem Code-Hirnstamm, der Code-Schrittregel und der Muskelformel.
| Modell | Training auf einer CPU | Basis Julia 1 | Feinabgestimmt |
|---|---|---|---|
| LifeSim-Hirnstamm-0.1 | 216 s | r = −0.37 | r = 0.9997 |
| LifeSim-Schritt-0.3 | 308 s | r = 0.24 | r = 0.9998 |
| LifeSim-Muskel-0.1 | 642 s | r = 0.12 | r = 0.958 |
Eine hohe Korrelation bei nicht trainierten Eingaben reicht nicht zum Gehen aus. Das Schrittmodell lernte zunächst nur aus Situationen, die die Code-Regel kannte, und führte den Körper, sobald es die Kontrolle hatte, in Situationen, die die Regel nie gesehen hatte. Wir ließen es gehen, zeichneten auf, was es traf, fragten die Regel, was sie getan hätte, und trainierten erneut (DAgger [6]). Die Gehzeit stieg von 83 % auf 92 % der des Lehrers.
Die Feinabstimmungen sind deterministisch, sodass dieselbe Frage immer dieselbe Antwort erhält. Wir speichern jede Antwort und stellen dem Modell nur Fragen, die es noch nicht gesehen hat. Nach wenigen Sekunden benötigen die meisten Ticks überhaupt keinen Modellaufruf mehr.
4 Ergebnisse
4.1 Stehen
Mit jeder Schicht auf einem Sprachmodell stehen beide Körper ohne Gurt und erholen sich von 80 N Stößen von vorne und von hinten. Bei über 20 geschobenen Stehversuchen steht das Hirnstammmodell so lange wie sein Lehrer: 12,4 s gegenüber 12,0 s.
4.2 Gehen
Der Geher ist SIMBICON [7] auf Muskeln: ein Schritt-Timer, ein Schwungbein und Fußplatzierung basierend auf der Position und Geschwindigkeit des Gewichts. Ohne Gurt gehen die Körper mit etwa 0,25 m/s und steuern auf das Ziel zu. In der Live-Simulation dauerte der mittlere Gang 18 Schritte zwischen den Stürzen, der längste 133 (Abbildung 2).
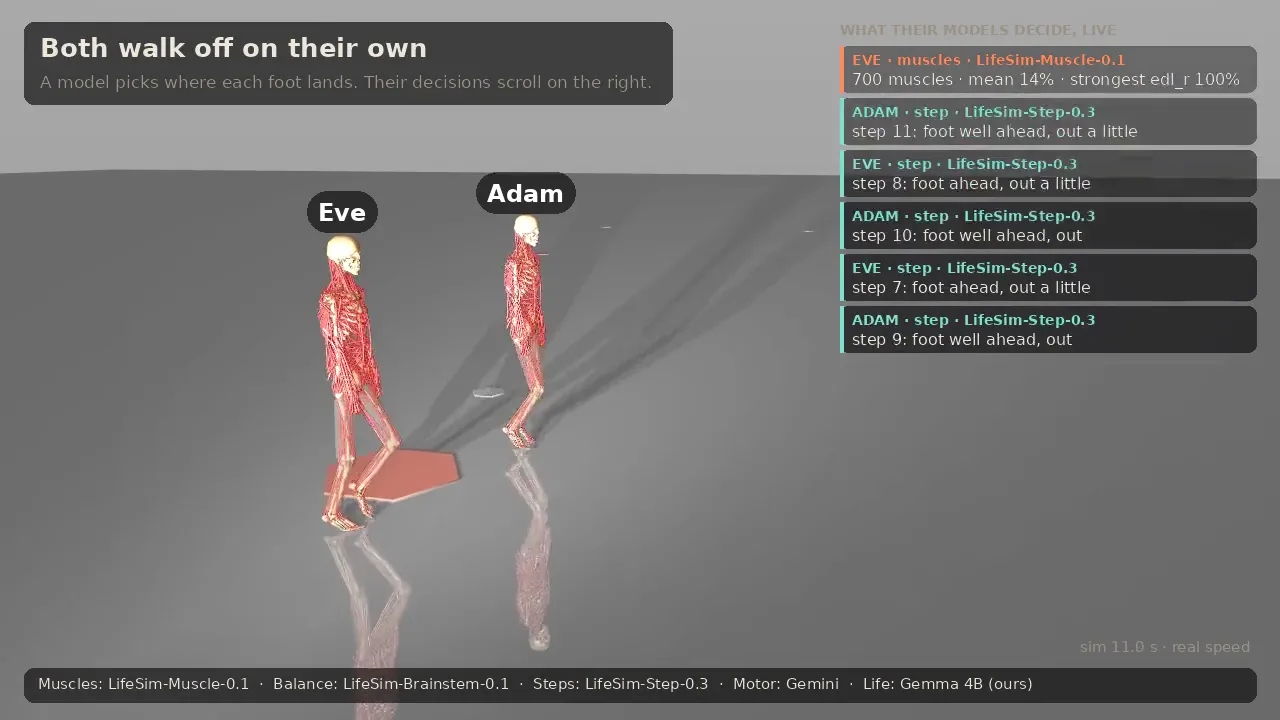
Bei einem 12-Sekunden-Gang hält das Schrittmodell den Körper durchschnittlich 8,6 Sekunden lang aufrecht, gegenüber 9,4 Sekunden bei der Code-Regel, die es gelernt hat (24 Gänge). Stehen verzeiht kleine Fehler. Gehen nicht.
4.3 Geschwindigkeit
Alles läuft auf einer CPU-Maschine, ohne GPU. Die Simulation wartet auf die Modelle („langsame Zeit“), da das Gleichgewicht alle 10 ms eine Entscheidung erfordert. Beide Körper mit jedem Modell laufen mit 0,25 bis 0,5-facher Echtzeit und mit 0,12 bis 0,18-facher, während beide gezeichnet werden.
4.4 In LifeSim
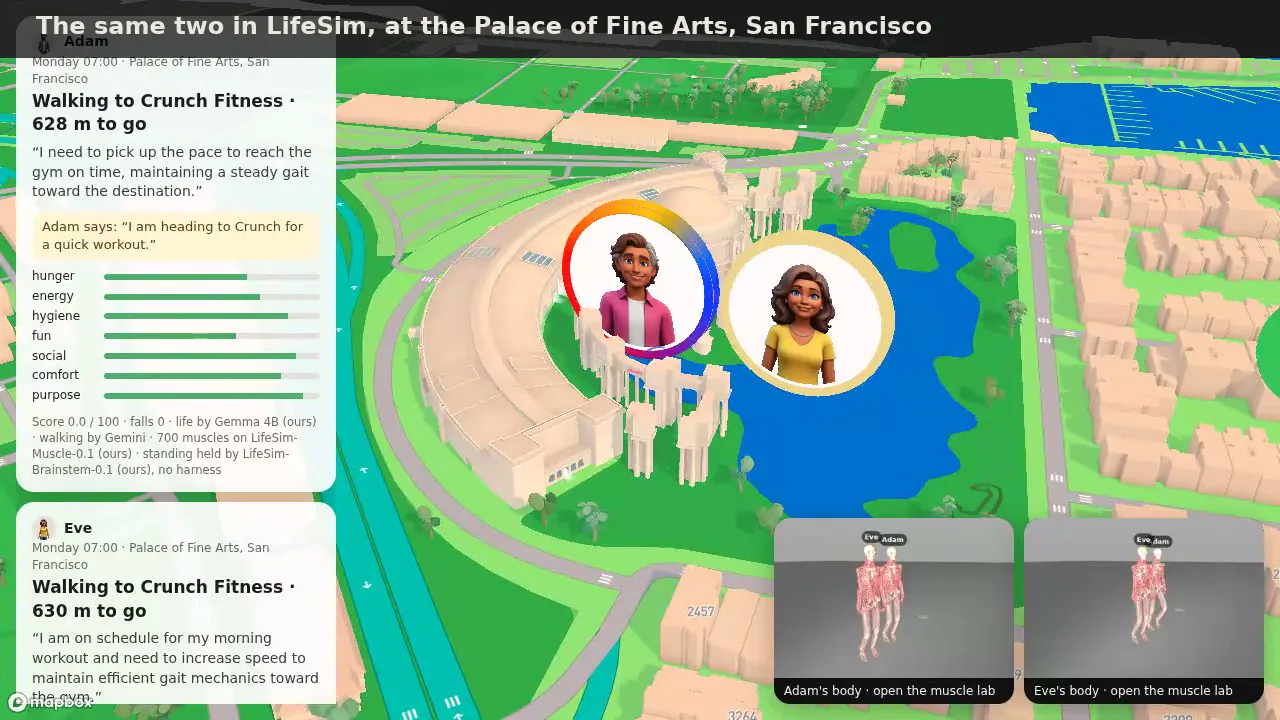
Dieselben zwei Personen erscheinen auf der LifeSim-Karte, mit ihren Bedürfnissen, ihren Plänen und dem, was sie einander sagen (Abbildung 3).
5 Was wir gelernt haben
- Wörter müssen Zahlen tragen. „Ein wenig nach vorne lehnen“ ist zu vage, um das Gleichgewicht zu halten: Der Körper fiel in 3 bis 6 Sekunden. „Das Gewicht ist 3 cm vor der Mitte der Füße, bewegt sich mit 4 cm/s vorwärts“ hält ihn aufrecht.
- Die Worte des Gehirns bestimmen die Auflösung der Muskeln. Unter „still stehen“ antwortet das Muskelmodell in Schritten von etwa 15 %. Unter „ruhig halten mit feiner Kontrolle“ sind die Schritte etwa 10 %, und erst dann überlebt der Körper einen Stoß von vorne.
- Muskeln arbeiten wie Motoneuronen. Das Muskelmodell antwortet in groben Schritten. Das Abwechseln zwischen benachbarten Schritten von Tick zu Tick, wie eine Feuerrate, lässt Gänge etwa 50 % länger dauern.
- Gehen ist chaotisch. Eine Änderung eines Parameters um ein Millionstel ändert die Dauer eines Gangs um ein Drittel. Ein einzelner Lauf beweist nichts, daher ist jede hier angegebene Gehzahl ein Mittelwert aus 12 oder mehr Gängen.
6 Was noch nicht funktioniert
- Anhalten. Ein gehender Körper, der dem stehenden Gleichgewicht übergeben wird, fällt innerhalb einer Sekunde: 0 von 20 Versuchen standen. Bei der Ankunft geht der Körper in eine stehende Pose über. Dies ist eine Animation, und wir bezeichnen sie als solche.
- Aufstehen. Nach einem Sturz geht der Körper in einer Sekunde wieder in den Stand über. Ebenfalls eine Animation.
- Andere Geschwindigkeiten. Nur die Geschwindigkeit, auf die der Geher abgestimmt wurde, funktioniert.
- Mehr Abstimmung. Drei Suchmethoden (Evolution, CMA-ES und Augmented Random Search) konnten den Geher nicht verbessern. Ein robusterer Geher benötigt einen Ganzkörper-Controller oder eine Richtlinie, die mit Reinforcement Learning auf einer GPU trainiert wurde.
7 Warum wir das versucht haben
Wir wollten nicht den besten Geher bauen. Reinforcement Learning macht bessere. Wir wollten sehen, ob ein Modelltyp von „was mache ich heute Abend“ bis hin zu „welcher Muskel zieht wie stark“ reichen kann. Das kann es, mit Hilfe einiger weniger Codezeilen in der Mitte. Kleine offene Modelle, die in wenigen Minuten auf einer CPU feinabgestimmt werden, können die meisten Schichten übernehmen.
Wir wissen noch nicht, wofür das ist. Vielleicht für Leute in LifeSim, die sich bewegen, weil sie es entscheiden, nicht weil eine Animation abgespielt wird. Vielleicht für nichts. Die Technologie entwickelt sich zu schnell, um das sagen zu können, weshalb man solche Dinge jetzt ausprobieren und unsere Erkenntnisse teilen sollte.
8 Zukünftige Arbeit
Das vielversprechendste Ergebnis ist, dass Worte den Körper verändern: „ruhig halten mit feiner Kontrolle“ gab den Muskeln eine feinere Auflösung als „still stehen“, und erst dann überstand der Körper einen Stoß von vorne. Das nächste Experiment besteht darin, denselben Körper auf verschiedene Worte reagieren zu lassen, wie „gehen, als wärst du müde“, „sich auf einen Stoß vorbereiten“ oder „entspannen“. Ein Code-Controller kann eine solche Anweisung nicht entgegennehmen. Ein Sprachmodell kann es.
Referenzen
- Zuo, C., He, K., Shao, J., Sui, Y. Self Model for Embodied Intelligence: Modeling Full-Body Human Musculoskeletal System and Locomotion Control with Hierarchical Low-Dimensional Representation. ICRA, 2024.
- Todorov, E., Erez, T., Tassa, Y. MuJoCo: A physics engine for model-based control. IROS, 2012.
- Gemma Team. Gemma 3 Technical Report. arXiv:2503.19786, 2025.
- Shao, Z., Wang, P., Zhu, Q., Xu, R., Song, J., et al. DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models. arXiv:2402.03300, 2024.
- Warner, B., Chaffin, A., Clavié, B., Weller, O., Hallström, O., et al. Smarter, Better, Faster, Longer: A Modern Bidirectional Encoder for Fast, Memory Efficient, and Long Context Finetuning and Inference. arXiv:2412.13663, 2024.
- Ross, S., Gordon, G. J., Bagnell, J. A. A Reduction of Imitation Learning and Structured Prediction to No-Regret Online Learning. AISTATS, 2011.
- Yin, K., Loken, K., van de Panne, M. SIMBICON: Simple Biped Locomotion Control. ACM SIGGRAPH, 2007.
Zitat
Bitte zitiere diese Arbeit wie folgt:
@misc{lifesim2026adamandeve,
  title  = {Adam & Eve: 700 LLM-Controlled Muscles via Fine-Tuned Decision Models},
  author = {{Cris Lenta}},
  year   = {2026},
  month  = {oct},
  url    = {https://lifesim.com/research/adam-and-eve}
}