


 English
 Español
 Português
 Bahasa Indonesia
 Română
 हिन्दी
 العربية
 Français
 Deutsch
 Русский
 Italiano
 Polski
 한국어
 简体中文
 Türkçe
 Kiswahili
 বাংলা
 Filipino
2026年10月27日
アダムとイブ:微調整された意思決定モデルによる700のLLM制御筋肉
概要
アダムとイブは、それぞれ700の筋肉を持つ2体のシミュレートされた人間で、サンフランシスコのパレス・オブ・ファイン・アーツで一緒に暮らしています。言語モデルは、言語モデルが実行できるあらゆる層を動かしています。一日の過ごし方、歩く場所、バランスの取り方、各足の着地場所、各筋肉の引っ張る強さなどです。これらのモデルのうち3つは当社独自のもので、それぞれ144Mパラメータのファインチューニングモデルで、CPUで4〜11分で学習され、見たことのない入力に対して0.958〜0.9998の相関で教師をコピーします。ハーネスなしで、両方の体は80Nの押しに耐え、転倒するまでに数十歩歩きます。これは実験であり、製品ではありません。何が機能し、何が機能しないか、そしてその数値を報告します。
1 実験
テクノロジーは非常に速く進化しており、シミュレーションが次にどこへ向かうのか誰も知りません。1年前、言語モデルは会話をすることができました。今日では、1週間の計画を立て、ツールを使用し、何時間も稼働することができます。私たちはその限界がどこにあるのかわからないため、それを見つけようとしました。
質問は単純でした。言語モデルはどれくらい深く潜れるのか?LifeSimのキャラクターはすでに言語モデルで考えています。彼らは何をすべきか、誰と話すべきか、どこへ行くべきかを決定します。その下では、すべてのゲームがアニメーションを使用しています。歩く体は、録画を再生する体です。
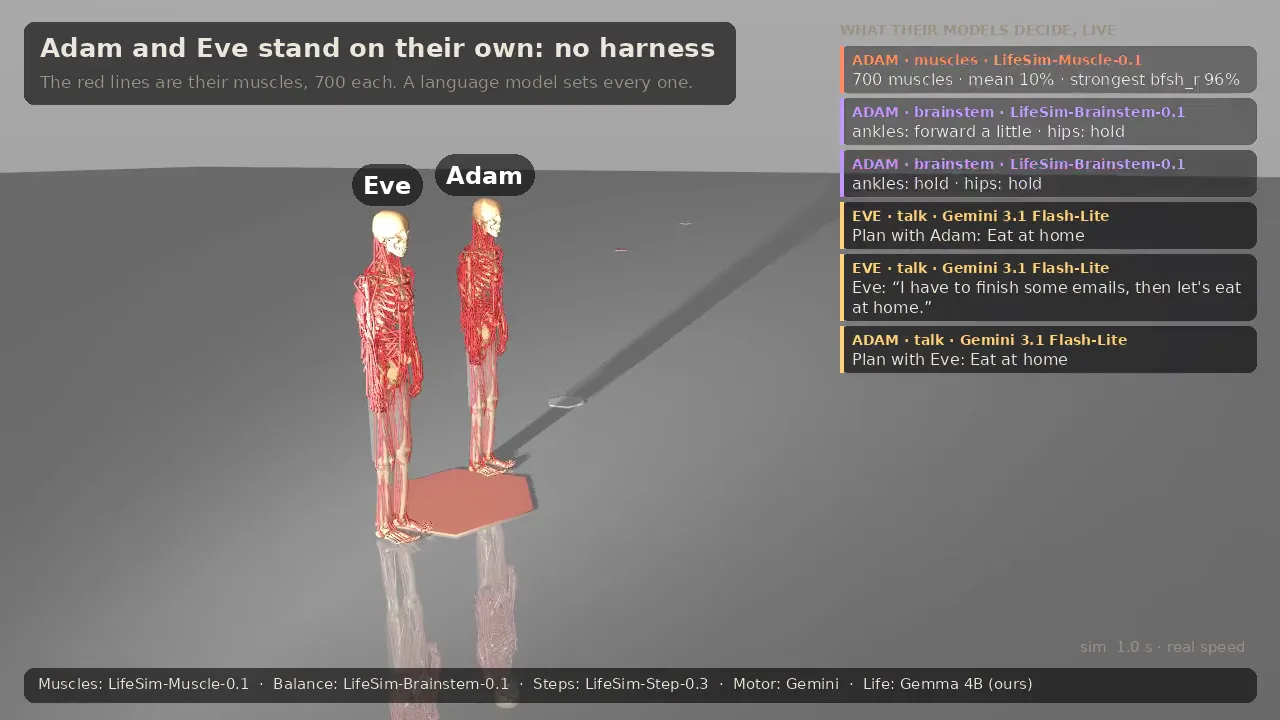
私たちは録画を体に置き換えました。MS-Human-700 [1]は、700の筋肉を持つ人間の筋骨格系のオープンモデルで、MuJoCo [2]でシミュレートされています。私たちはそれらを2体、実際のマップから作られた床の上に配置し、可能なすべての決定を言語モデルに任せました。それが立つかどうかはわかりませんでした。しかし、立ちました。
2 レイヤー
私たちは体と心の層をコピーし、言語モデルになり得る各層を1つの言語モデルに与えました(表1)。脊髄だけがコードです。「少し後ろに傾く」や「ここに足を置く」を700の筋肉の引っ張りに変換します。
| レイヤー | 人間の場合 | モデル | 頻度 |
|---|---|---|---|
| 生活 | 一日をどう過ごすか | Gemma 3 4B [3]、LifeSim WeekでGRPO [4]を使って当社がファインチューニング | アクティビティごとに1回、約4秒 |
| 運動皮質 | 「あそこまで歩いて、体幹を固定して」 | Gemini 3.1 Flash-Lite | 約1秒に1回、約1秒 |
| 脳幹 | 体を直立に保つ | LifeSim-Brainstem-0.1(当社製) | 1ティックあたり2つの質問、立っているとき |
| ステップ決定 | 次の足がどこに着地するか | LifeSim-Step-0.3(当社製) | 1ティックあたり2つの質問、歩いているとき |
| 脊髄 | 固定配線 | コード | 毎ティック |
| 筋肉 | 収縮 | LifeSim-Muscle-0.1(当社製) | 1ティックあたり1人あたり700の質問 |
すべての層は言葉で話します。脳幹は「体重は足の中央から3cm前方にあり、4cm/sで前方に移動している」と読み取り、どのように傾くべきかを答えます。各筋肉は、運動皮質からのその身体領域の線と脊髄からの衝動を読み取り、どれくらいの強さで収縮すべきかを答えます。
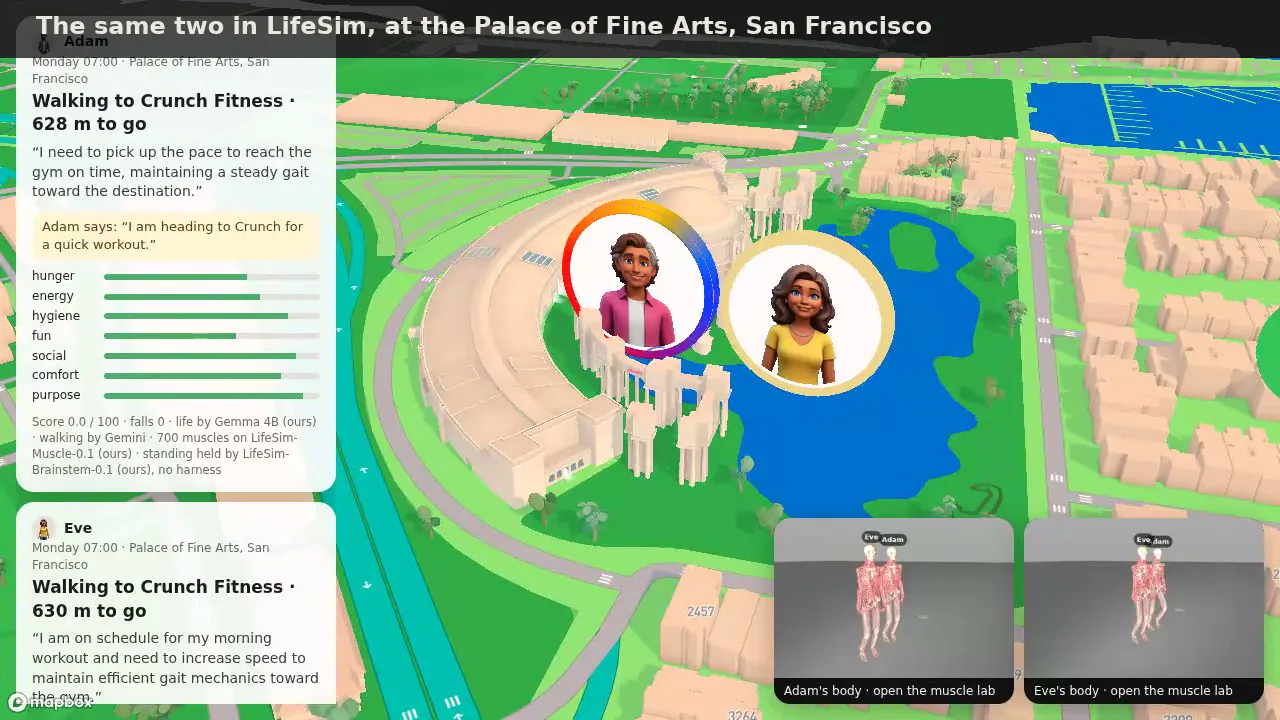
アダムとイブはお互いのことも知っています。各ライフモデルは、パートナーがどこにいて何をしているかを読み取ります。2人が出会うと、Geminiはそれぞれに1行書き、彼らは計画に同意することができます。「後でKibatsuで夕食を食べたい?」(図3)。
3 3つの小さなモデル
下位3層は10ミリ秒ごとに最大1,400の質問に答えるため、小さなモデルが必要です。私たちは、ModernBERT [5]エンコーダ(22層、隠れサイズ384)と決定ヘッドに基づいて構築された144MパラメータモデルであるJulia 1を使用し、3つのコピーをファインチューニングしました。それぞれがコードで書かれた教師から学習しました。コード脳幹、コードステップルール、筋肉の式です。
| モデル | CPUでのトレーニング | ベースJulia 1 | ファインチューニング済み |
|---|---|---|---|
| LifeSim-Brainstem-0.1 | 216 s | r = −0.37 | r = 0.9997 |
| LifeSim-Step-0.3 | 308 s | r = 0.24 | r = 0.9998 |
| LifeSim-Muscle-0.1 | 642 s | r = 0.12 | r = 0.958 |
ホールドアウトされた入力での高い相関だけでは歩行には不十分です。ステップモデルは最初、コードルールが出会った状況からのみ学習し、制御下に入ると、ルールが一度も見たことのない状況に体を導きました。私たちはそれを歩かせ、出会ったものを記録し、ルールが何をしていたかを尋ね、再びトレーニングしました(DAgger [6])。歩行時間は教師の83%から92%に上昇しました。
ファインチューニングは決定論的であるため、同じ質問には常に同じ答えが返されます。私たちはすべての答えを保持し、モデルにはまだ見ていない質問のみを尋ねます。数秒後には、ほとんどのティックでモデル呼び出しがまったく必要なくなります。
4 結果
4.1 立位
すべての層が言語モデル上にある場合、両方の体はハーネスなしで立ち、前方および後方からの80Nの押しから回復します。20回の押し込み立位実験で、脳幹モデルは教師と同じくらい長く立ちます。12.4秒対12.0秒です。
4.2 歩行
歩行器は筋肉上のSIMBICON [7]です。ステップタイマー、スイングレッグ、そして体重の位置と速度からの足の配置です。ハーネスなしで、体は約0.25m/sで歩き、目標に向かって操縦します。ライブシミュレーションでは、転倒間の歩行の中央値は18歩で、最長は133歩でした(図2)。
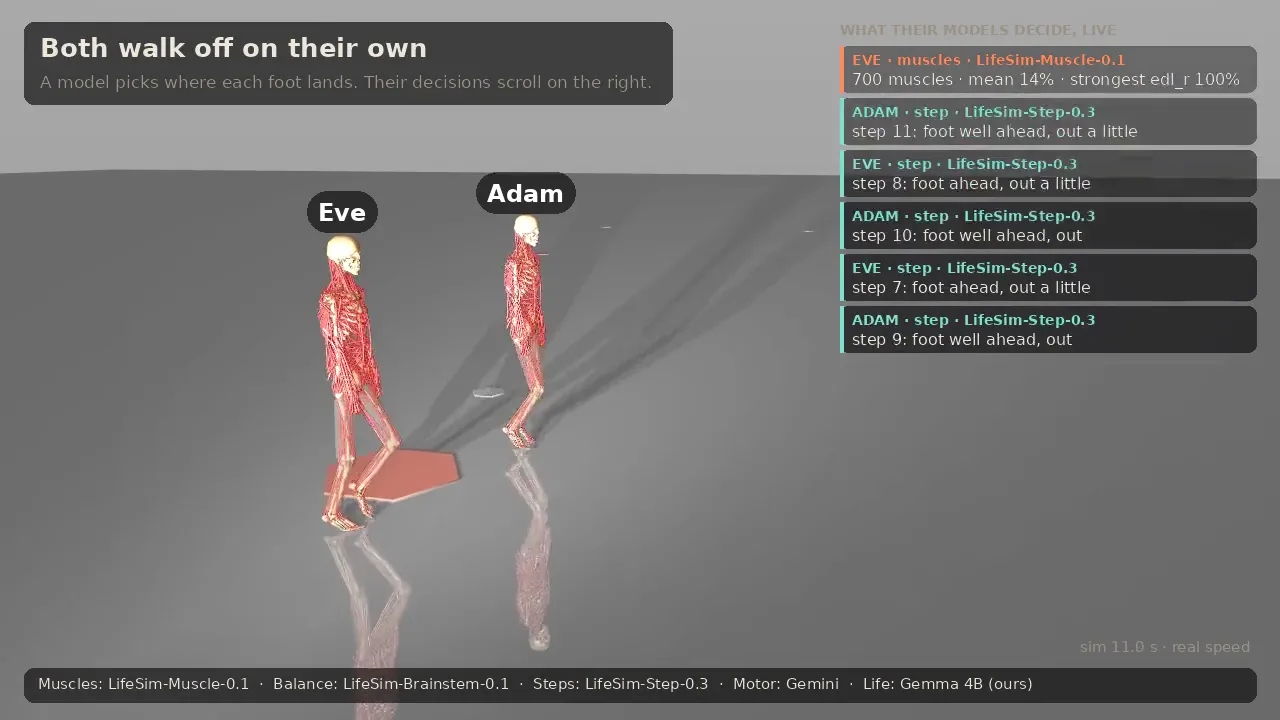
12秒の歩行で、ステップモデルは平均8.6秒間体を支え、それを教えたコードルールは9.4秒でした(24回の歩行)。立位は小さなエラーを許容します。歩行は許容しません。
4.3 速度
すべて1台のCPUマシンで実行され、GPUはありません。バランスには10ミリ秒ごとに決定が必要なため、シミュレーションはモデルを待ちます(「スロータイム」)。両方の体とすべてのモデルは実時間の0.25〜0.5倍で実行され、両方が描画されている間は0.12〜0.18倍で実行されます。
4.4 LifeSim内
同じ2人がLifeSimマップに表示され、彼らのニーズ、計画、そしてお互いに話す内容が表示されます(図3)。
5 学んだこと
- 言葉は数字を伝える必要があります。「少し前かがみになる」ではバランスを取るには曖昧すぎ、体は3〜6秒で倒れました。「体重は足の中央から3cm前方にあり、4cm/sで前方に移動している」とすることで、体を支えることができます。
- 脳の言葉が筋肉の解像度を設定します。「静止する」では、筋肉モデルは約15%のステップで応答します。「微細な制御で安定を保つ」では、ステップは約10%になり、その場合にのみ体が前方からの押しに耐えられます。
- 筋肉は運動ニューロンのように機能します。筋肉モデルは粗いステップで応答します。発火率のように、ティックごとに隣接するステップを交互に繰り返すことで、歩行時間が約50%長くなります。
- 歩行はカオスです。 わずか100万分の1の変更でも、歩行の持続時間は3分の1も変わります。1回の試行では何も証明できないため、ここでの歩行に関する数値はすべて12回以上の歩行の平均値です。
6 まだ機能しないこと
- 停止。 歩行中の体が静止バランスに移行すると、1秒以内に倒れてしまいます。20回の試行のうち、立ったままいられたのは0回でした。到着すると、体は立ちポーズにブレンドされます。これはアニメーションであり、そのように分類しています。
- 起き上がり。 転倒後、体は1秒で立ちポーズに戻ります。これもアニメーションです。
- その他の速度。 ウォーカーが調整された速度のみが機能します。
- さらなる調整。 3つの探索方法(進化、CMA-ES、拡張ランダム探索)では、ウォーカーを改善できませんでした。より頑丈なウォーカーには、全身コントローラー、またはGPUで強化学習によって訓練されたポリシーが必要です。
7 なぜこれを試したのか
私たちは最高のウォーカーを構築しようとしたわけではありません。強化学習はより優れたものを作ります。私たちは、「今夜何をするか」から「どの筋肉がどれくらいの力で引っ張るか」まで、ある種のモデルが到達できるかどうかを確かめようとしました。それは、途中に数行のコードの助けを借りれば可能です。数分でCPU上でファインチューニングされた小さなオープンモデルは、ほとんどのレイヤーを処理できます。
これが何のためになるのか、まだわかりません。もしかしたら、アニメーションが再生されるからではなく、自分で決めて動くLifeSimのキャラクターのためかもしれません。あるいは、何のためにもならないかもしれません。テクノロジーはあまりにも速く進歩しているため、断言できません。だからこそ、今このようなことを試して、発見したことを共有するのです。
8 今後の課題
最も有望な結果は、言葉が体に変化をもたらすことです。「細かく制御して安定させる」という言葉は、「じっと立つ」よりも筋肉に細かい解像度を与え、そのおかげで体は前方からの押しに耐えることができました。次の実験は、「疲れているように歩く」、「押しに備える」、「リラックスする」といった異なる言葉に同じ体が反応することを示すことです。コードコントローラーはこのような指示を受け入れることはできませんが、言語モデルは可能です。
参考文献
- Zuo, C., He, K., Shao, J., Sui, Y. Self Model for Embodied Intelligence: Modeling Full-Body Human Musculoskeletal System and Locomotion Control with Hierarchical Low-Dimensional Representation. ICRA, 2024.
- Todorov, E., Erez, T., Tassa, Y. MuJoCo: A physics engine for model-based control. IROS, 2012.
- Gemma Team. Gemma 3 Technical Report. arXiv:2503.19786, 2025.
- Shao, Z., Wang, P., Zhu, Q., Xu, R., Song, J., et al. DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models. arXiv:2402.03300, 2024.
- Warner, B., Chaffin, A., Clavié, B., Weller, O., Hallström, O., et al. Smarter, Better, Faster, Longer: A Modern Bidirectional Encoder for Fast, Memory Efficient, and Long Context Finetuning and Inference. arXiv:2412.13663, 2024.
- Ross, S., Gordon, G. J., Bagnell, J. A. A Reduction of Imitation Learning and Structured Prediction to No-Regret Online Learning. AISTATS, 2011.
- Yin, K., Loken, K., van de Panne, M. SIMBICON: Simple Biped Locomotion Control. ACM SIGGRAPH, 2007.
引用
この作品を引用する際は、以下のように記載してください:
@misc{lifesim2026adamandeve,
  title  = {Adam & Eve: 700 LLM-Controlled Muscles via Fine-Tuned Decision Models},
  author = {{Cris Lenta}},
  year   = {2026},
  month  = {oct},
  url    = {https://lifesim.com/research/adam-and-eve}
}