


 English
 Español
 Português
 Bahasa Indonesia
 Română
 हिन्दी
 العربية
 Français
 Deutsch
 Русский
 Italiano
 Polski
 한국어
 日本語
 简体中文
 Türkçe
 Kiswahili
 বাংলা
 Filipino
2026年10月10日
LifeSim 室內設計:從一張相片到可拆解的 3D 房間
摘要
我們推出 LifeSim Interiors,這是一個研究系統,可以從一張圖像生成一個分解的 3D 場景:一個環境加上每個物體作為其自身的網格,每個物體都在正確的位置。該系統擴展了 TRELLIS.2 [1],以在一個共享框架中共同生成一個環境和多達三十個物體。由於沒有大型的分解 3D 房間數據集,我們建立了一個管道,產生了 5,500 個資產並組成了 10,216 個物理有效的訓練場景。在保留的合成場景上,當訓練從 250 步增加到 1,500 步時,10 公分處的 F 值從 4.3% 上升到 26.8%,並且曲線沒有顯示出高原。
1 簡介
3D 場景不僅僅是一個表面。它是一個你可以重新佈置的房間,一個你可以移動的沙發,一個你可以替換的架子。一個理解空間的系統必須恢復這些部分,而不僅僅是一個單一的靜態網格。
LifeSim Interiors 生成一個環境,加上每個物體作為其自身的網格。它建立在最近的物體到場景蒸餾工作和微軟的 TRELLIS.2 [1] 之上。我們在 Google Cloud 上兩天內建立了完整的堆疊。我們的貢獻是:
- 世界工廠:文字變成圖像,圖像變成 3D 資產,資產變成物理有效的房間,規模化(第 2 節)。
- 場景生成器:一個 3D 物體模型,擴展為在一個共享框架中共同生成一個環境和許多物體(第 3 節)。
- 物件精修:每個物件都會在自己的框架中,根據場景的其他部分,以更高細節重新生成(第 3.3 節)。
- 測量:公開基準測試協定,加上我們將生成場景置於真實攝影機框架中的方法(第 4 節)。
2 世界建構
目前沒有大型 3D 房間資料集,且這些房間都拆分成獨立部件,因此我們自行建構。預先訓練的物件生成器會製作部件,而我們的管線會將它們組合成房間。
2.1 從文字到部件
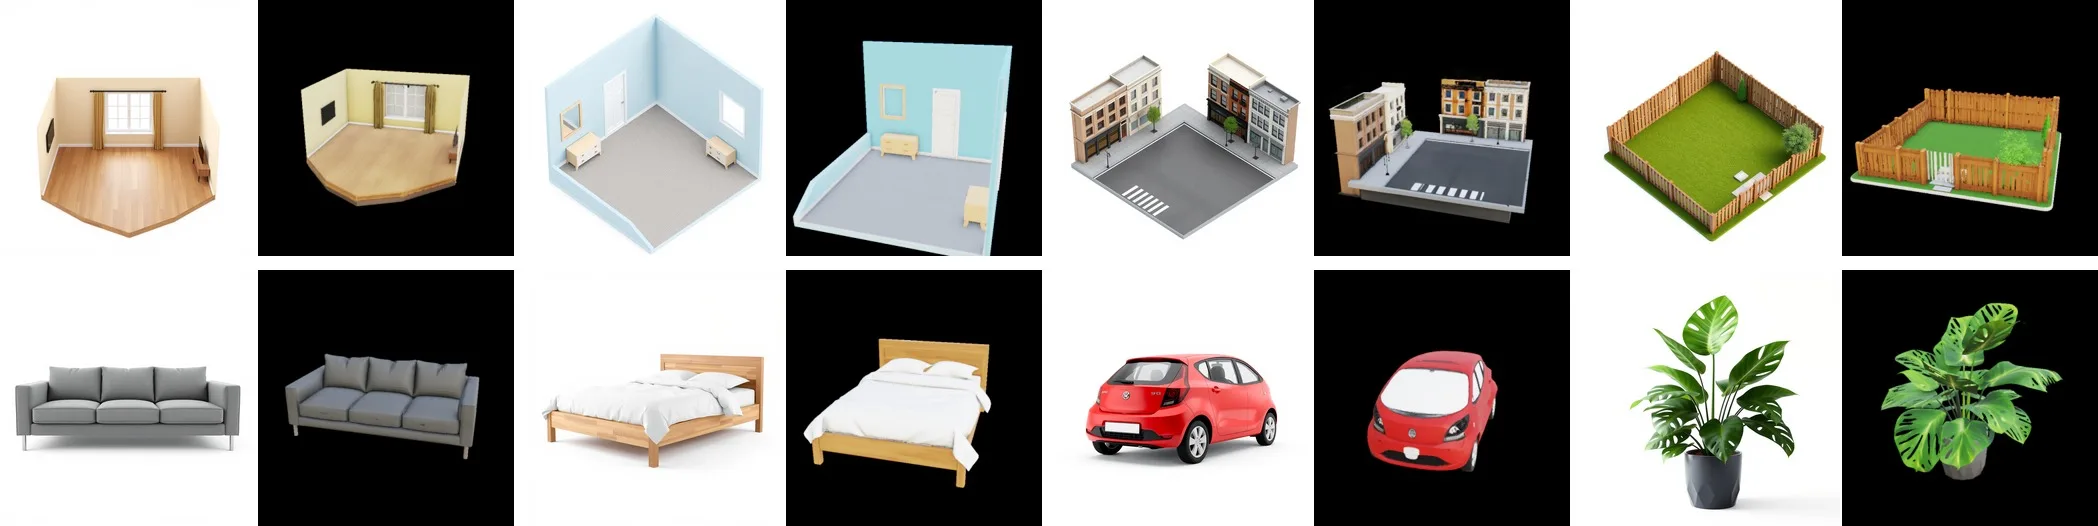
每個物件和每個房間都始於簡短描述。圖像模型會繪製它,而 TRELLIS.2 會將繪圖提升為帶有紋理的 3D 資產(圖 1)。
2.2 最難的資產是空房間
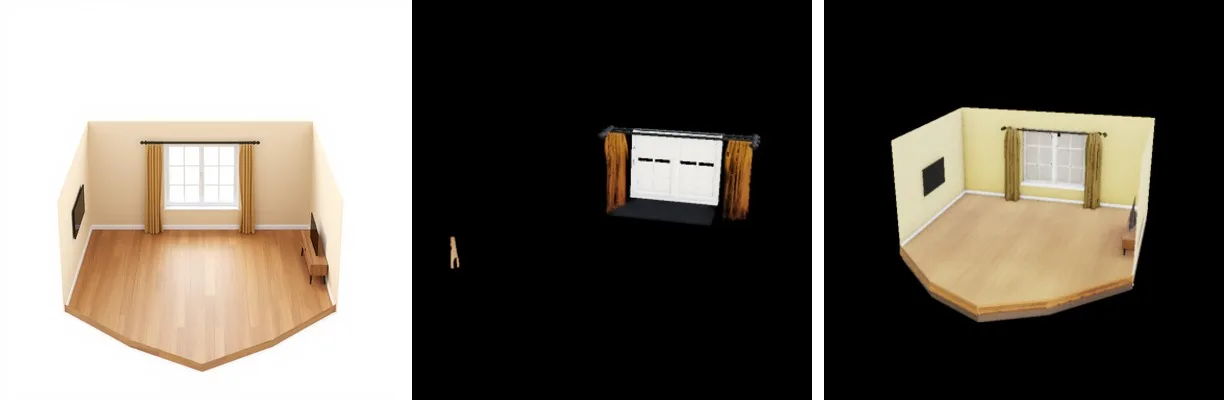
空房間的生成出奇地困難。標準的背景移除會將淺色牆壁和地板視為背景,因此我們第一個「空客廳」回來時只剩下一個窗戶和兩片窗簾。透過顏色遮罩環境可以保持整個房間的完整性(圖 2)。
2.3 遵守物理定律的房間
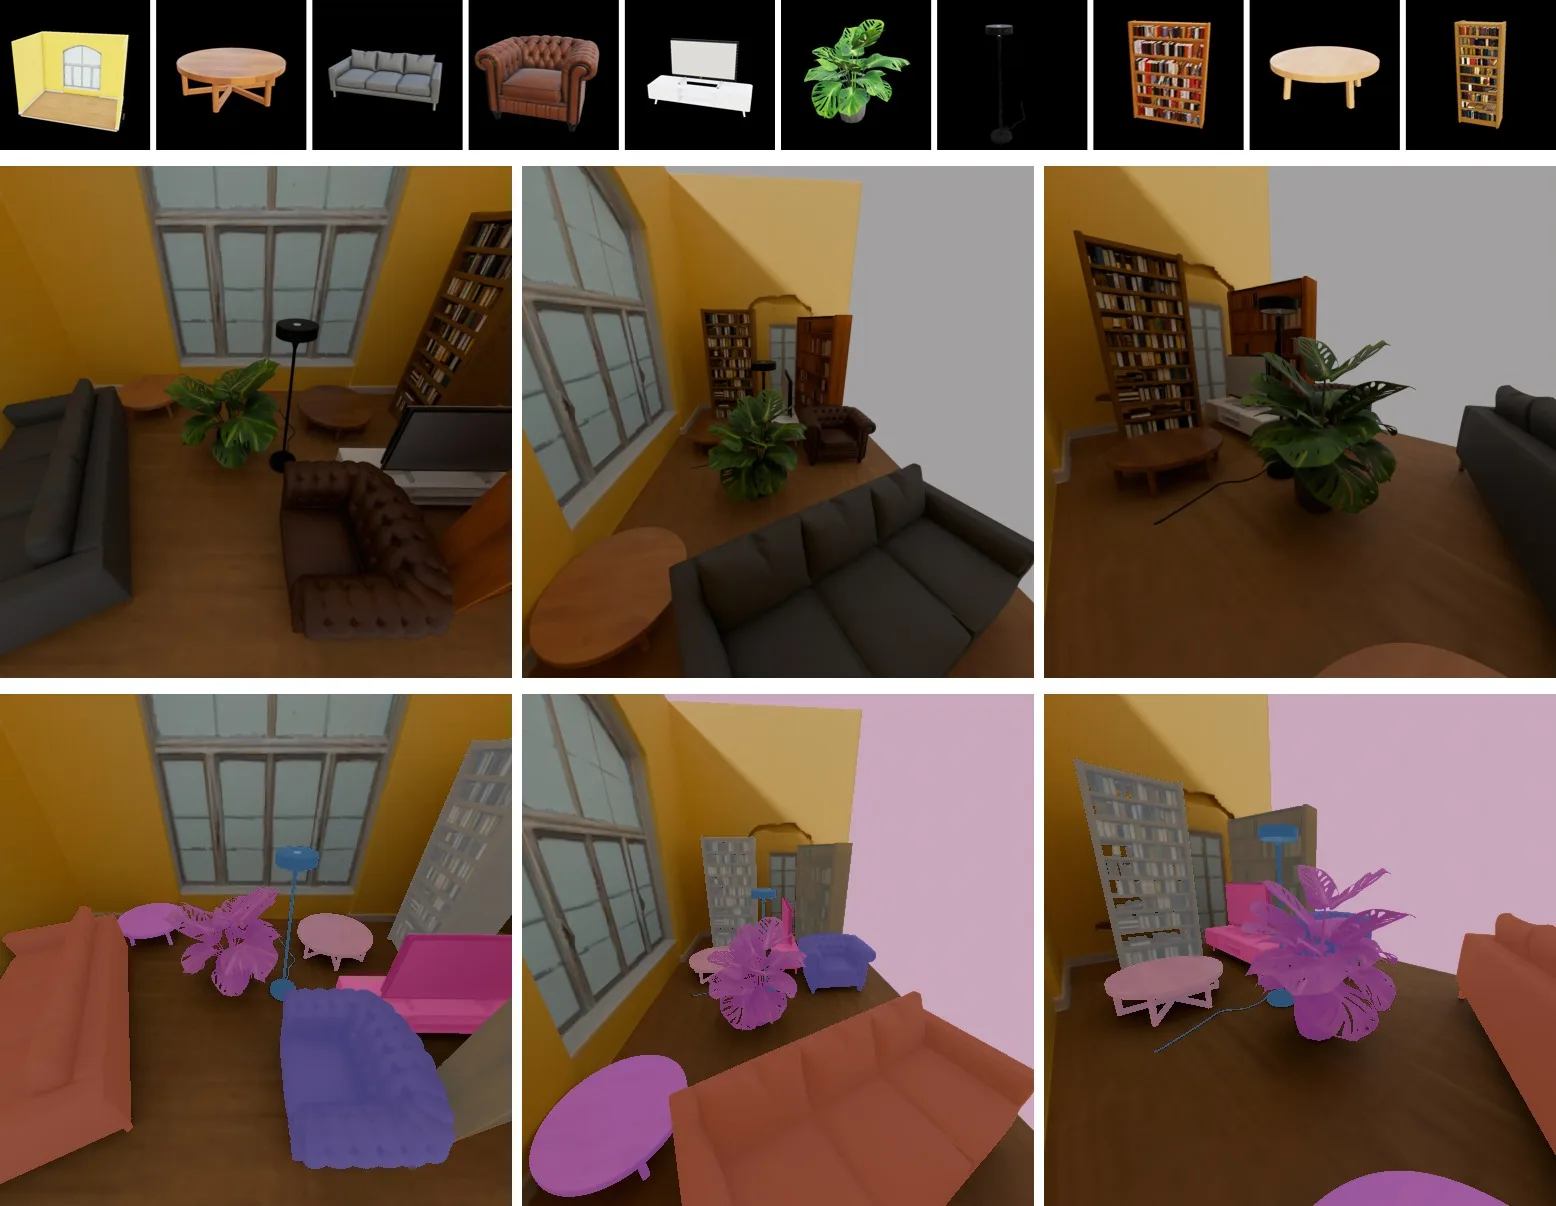
每個物件都會放置在真實的支撐表面上。任何漂浮或穿牆的物件都會被拒絕,並解決碰撞問題。攝影機對準已佈置的區域,視野範圍符合每個物件,並且只保留每個物件都可見的視圖(圖 3)。
2.4 大規模應用
在不到一小時內,工廠生產了 5,500 個資產,涵蓋 16 種房間類型和 89 個物件類別。從這些資產中,它組成了 10,216 個訓練場景,每個場景約有六個物件(圖 4)。
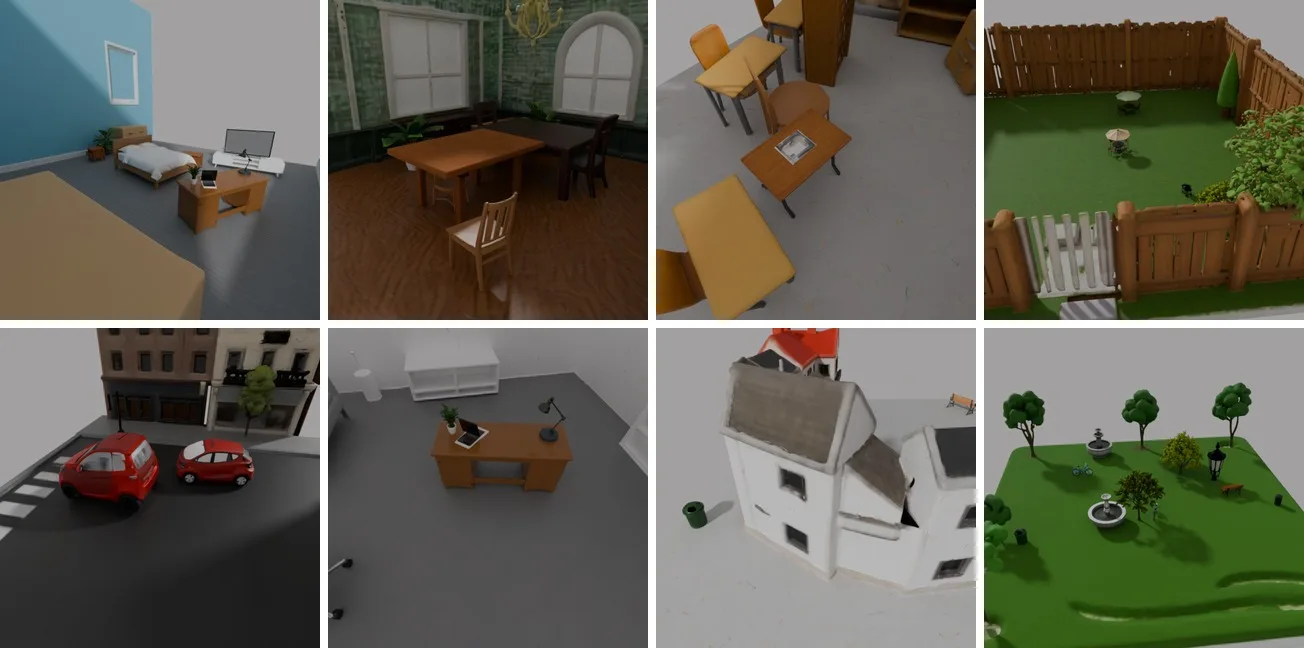
規模化暴露了試驗階段隱藏的問題:圖像模型通常會忽略「無家具」的指令,仍然繪製有家具的房間,這與分解的目標背道而馳。我們的幾何濾波器會俯視每個房間,測量地板的空閒程度。它保留了 1,493 個環境中的 537 個。
3 生成場景,而非物件
3.1 整個房間的一個序列
場景的所有組件,一個環境和最多三十個物件,在凍結的 3D 生成器上共享一個單一的 token 序列。每個物件都可以關注其他所有物件以及周圍的房間。
3.2 從模型已知的部分開始
可學習的類型和槽位嵌入將環境與物件區分開來,並將物件彼此區分開來。它們從零開始,因此在第一個訓練步驟中,模型的行為與預訓練模型完全相同。只訓練輕量級的適配器。
3.3 在物件自己的框架中進行精修
物件只佔據房間大小網格中的幾個體素。精修會將每個物件移動到其自己的標準化框架中,在關注整個場景的同時重新生成它,然後將其放回原位。
3.4 架構
- 基礎模型。 TRELLIS.2-4B [1],一個稀疏體素圖像到 3D 生成器,使用流匹配轉換器 [3] 處理結構、形狀和紋理。
- 適配器。 在每個注意力層和 MLP 層上使用 rank 32 的 LoRA [2]:在凍結的骨幹上具有 37M 個可訓練參數。
- 分解注意力。 對於 30 個組件的場景進行密集注意力計算,每個訓練步驟需要 43 秒。在我們的設計中,三十個層中有五個層在場景中進行注意力計算,其餘的則在每個組件內部進行注意力計算,這是基礎模型預訓練的模式。這大約便宜 3 倍。
4 結果
4.1 與攝影機對齊
真實世界的評估需要攝影機度量框架中的預測。我們將生成的場景註冊到可見深度,並透過深度圖一致性來評分每個候選姿勢。如果沒有這個,僅 5% 的比例誤差就會導致 F-score 損失 26 分。
4.2 模型擴展
LifeSim Interiors 隨著訓練計算的增加而改進。在保留的合成場景上,10 公分處的 F-score(越高越好)在每個檢查點都會攀升,每次訓練加倍時約增加九分(表 1)。
| 訓練步驟 | 250 | 500 | 1,000 | 1,500 |
|---|---|---|---|---|
| F-score@0.1 | 4.3% | 11.6% | 21.3% | 26.8% |
管線本身是健全的:解碼真實潛在變數並將其評分為預測值可獲得 100% 的 F-score。模型在訓練過的場景和新場景上的得分也大致相同,因此它仍未充分訓練,而非過度擬合。該模型所見的訓練計算量僅為此類方法通常所給予的一小部分。
5 後續發展
模型正在學習;我們提早停止了。接下來有三個步驟:訓練更長時間、組成更逼真的房間,以及生成真正空的環境。
我們在第二步已經領先了。我們的文字轉室內實驗室使用 LLM 編寫房間佈局,並使用視覺模型檢查每個資產。將這些房間輸入世界工廠是我們的下一個實驗。
核心模型是緊湊的。大部分的實際工作都圍繞著它:製造可信的世界、高效地渲染它們,以及誠實地衡量與真實世界的結果。隨著 LifeSim Interiors 的成熟,我們將分享更多資訊。
參考文獻
- Xiang, J., Chen, X., Xu, S., Wang, R., Lv, Z., et al. Native and Compact Structured Latents for 3D Generation. arXiv:2512.14692, 2025.
- Hu, E. J., Shen, Y., Wallis, P., Allen-Zhu, Z., Li, Y., Wang, S., Wang, L., Chen, W. LoRA: Low-Rank Adaptation of Large Language Models. arXiv:2106.09685, 2021.
- Lipman, Y., Chen, R. T. Q., Ben-Hamu, H., Nickel, M., Le, M. Flow Matching for Generative Modeling. arXiv:2210.02747, 2022.
引用
請引用此作品為:
@misc{lifesim2026interiors,
  title  = {LifeSim Interiors: From One Photo to a 3D Room You Can Take Apart},
  author = {{João Nobre} and {Cris Lenta}},
  year   = {2026},
  month  = {oct},
  url    = {https://lifesim.com/research/interiors}
}