


 English
 Español
 Português
 Bahasa Indonesia
 Română
 हिन्दी
 العربية
 Français
 Deutsch
 Русский
 Italiano
 한국어
 日本語
 简体中文
 Türkçe
 Kiswahili
 বাংলা
 Filipino
10 paź 2026
Wnętrza w LifeSim: z jednego zdjęcia do pokoju 3D, który można rozłożyć na części
Abstrakt
Prezentujemy LifeSim Interiors, system badawczy, który generuje rozłożoną scenę 3D z jednego obrazu: środowisko plus każdy obiekt jako własna siatka, każdy we właściwym miejscu. System rozszerza TRELLIS.2 [1] do wspólnego generowania środowiska i do trzydziestu obiektów, w jednej wspólnej ramce. Ponieważ nie istnieje duży zbiór danych rozłożonych pomieszczeń 3D, zbudowaliśmy potok, który wyprodukował 5500 zasobów i skomponował 10 216 fizycznie poprawnych scen treningowych. Na odłożonych scenach syntetycznych wynik F przy 10 cm wzrasta z 4,3% do 26,8% wraz ze wzrostem treningu z 250 do 1500 kroków, a krzywa nie wykazuje plateau.
1 Wprowadzenie
Scena 3D to coś więcej niż powierzchnia. To pokój, który można by przestawić, sofa, którą można by przesunąć, półka, którą można by wymienić. System, który rozumie przestrzeń, musi odzyskać te części, a nie tylko jedną zamrożoną siatkę.
LifeSim Interiors generuje środowisko plus każdy obiekt jako własna siatka. Opiera się na ostatnich pracach nad destylacją obiekt-scena i na TRELLIS.2 firmy Microsoft [1]. Zbudowaliśmy cały stos wokół niego w dwa dni na Google Cloud. Nasze wkłady to:
- Fabryka świata: tekst staje się obrazami, obrazy stają się zasobami 3D, a zasoby stają się fizycznie poprawnymi pomieszczeniami, na dużą skalę (Sekcja 2).
- Generator scen: model obiektu 3D rozszerzony do wspólnego generowania środowiska i wielu obiektów, w jednej wspólnej ramce (Sekcja 3).
- Udoskonalenie obiektu: każdy obiekt jest regenerowany we własnej ramce z większą szczegółowością, warunkowo na resztę sceny (Sekcja 3.3).
- Pomiar: publiczny protokół benchmarkowy, plus nasza własna metoda umieszczania generowanych scen w ramce rzeczywistej kamery (Sekcja 4).
2 Tworzenie światów
Brakuje dużego zbioru danych 3D pomieszczeń podzielonych na osobne części, więc tworzymy go. Wstępnie wytrenowany generator obiektów tworzy części, a nasz potok składa je w pomieszczenia.
2.1 Od słów do części
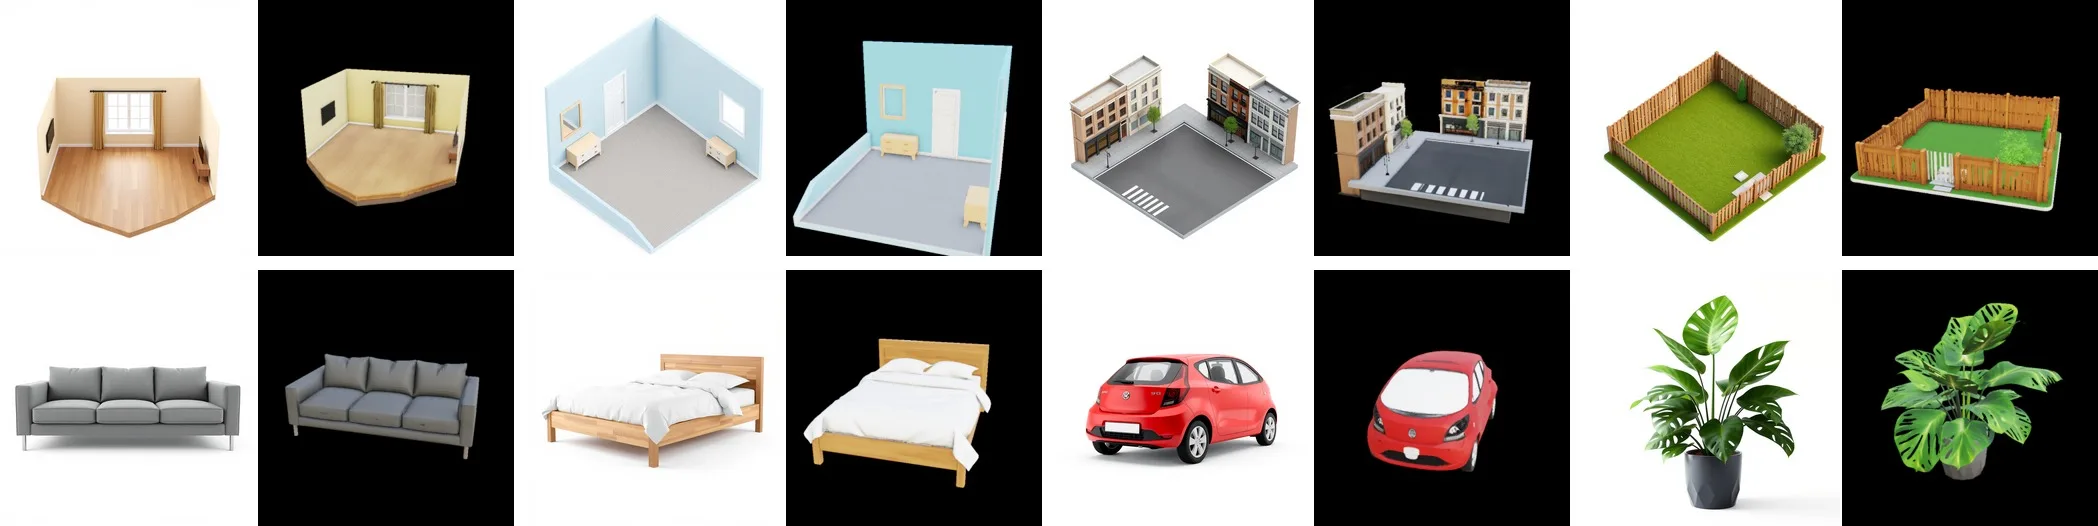
Każdy obiekt i każde pomieszczenie zaczyna się od krótkiego opisu. Model obrazu go rysuje, a TRELLIS.2 przekształca rysunek w teksturowany zasób 3D (Rysunek 1).
2.2 Najtrudniejszym zasobem jest puste pomieszczenie
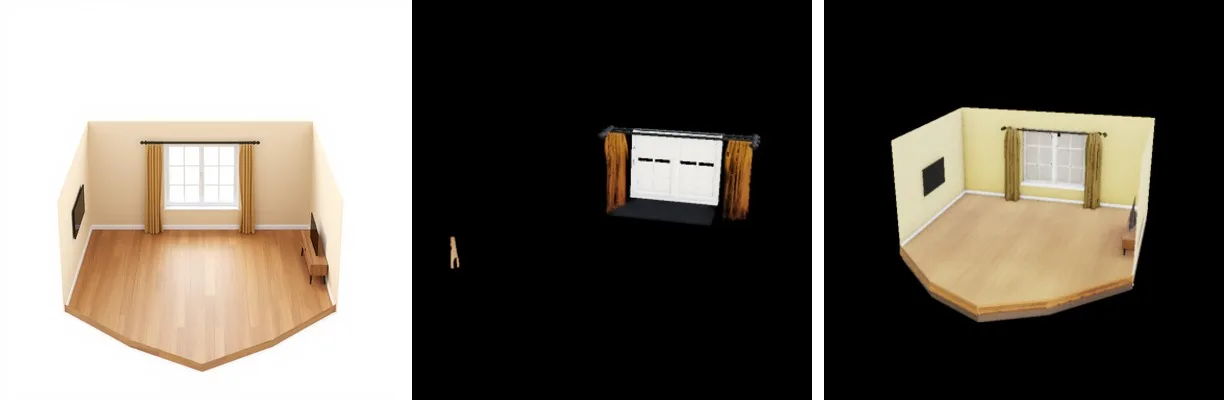
Puste pomieszczenie jest zaskakująco trudne do wygenerowania. Standardowe usuwanie tła traktuje jasne ściany i podłogi jako tło, więc nasz pierwszy „pusty salon” powrócił jako okno i dwie zasłony. Maskowanie środowisk według koloru utrzymuje całe pomieszczenie w nienaruszonym stanie (Rysunek 2).
2.3 Pomieszczenia, które przestrzegają praw fizyki
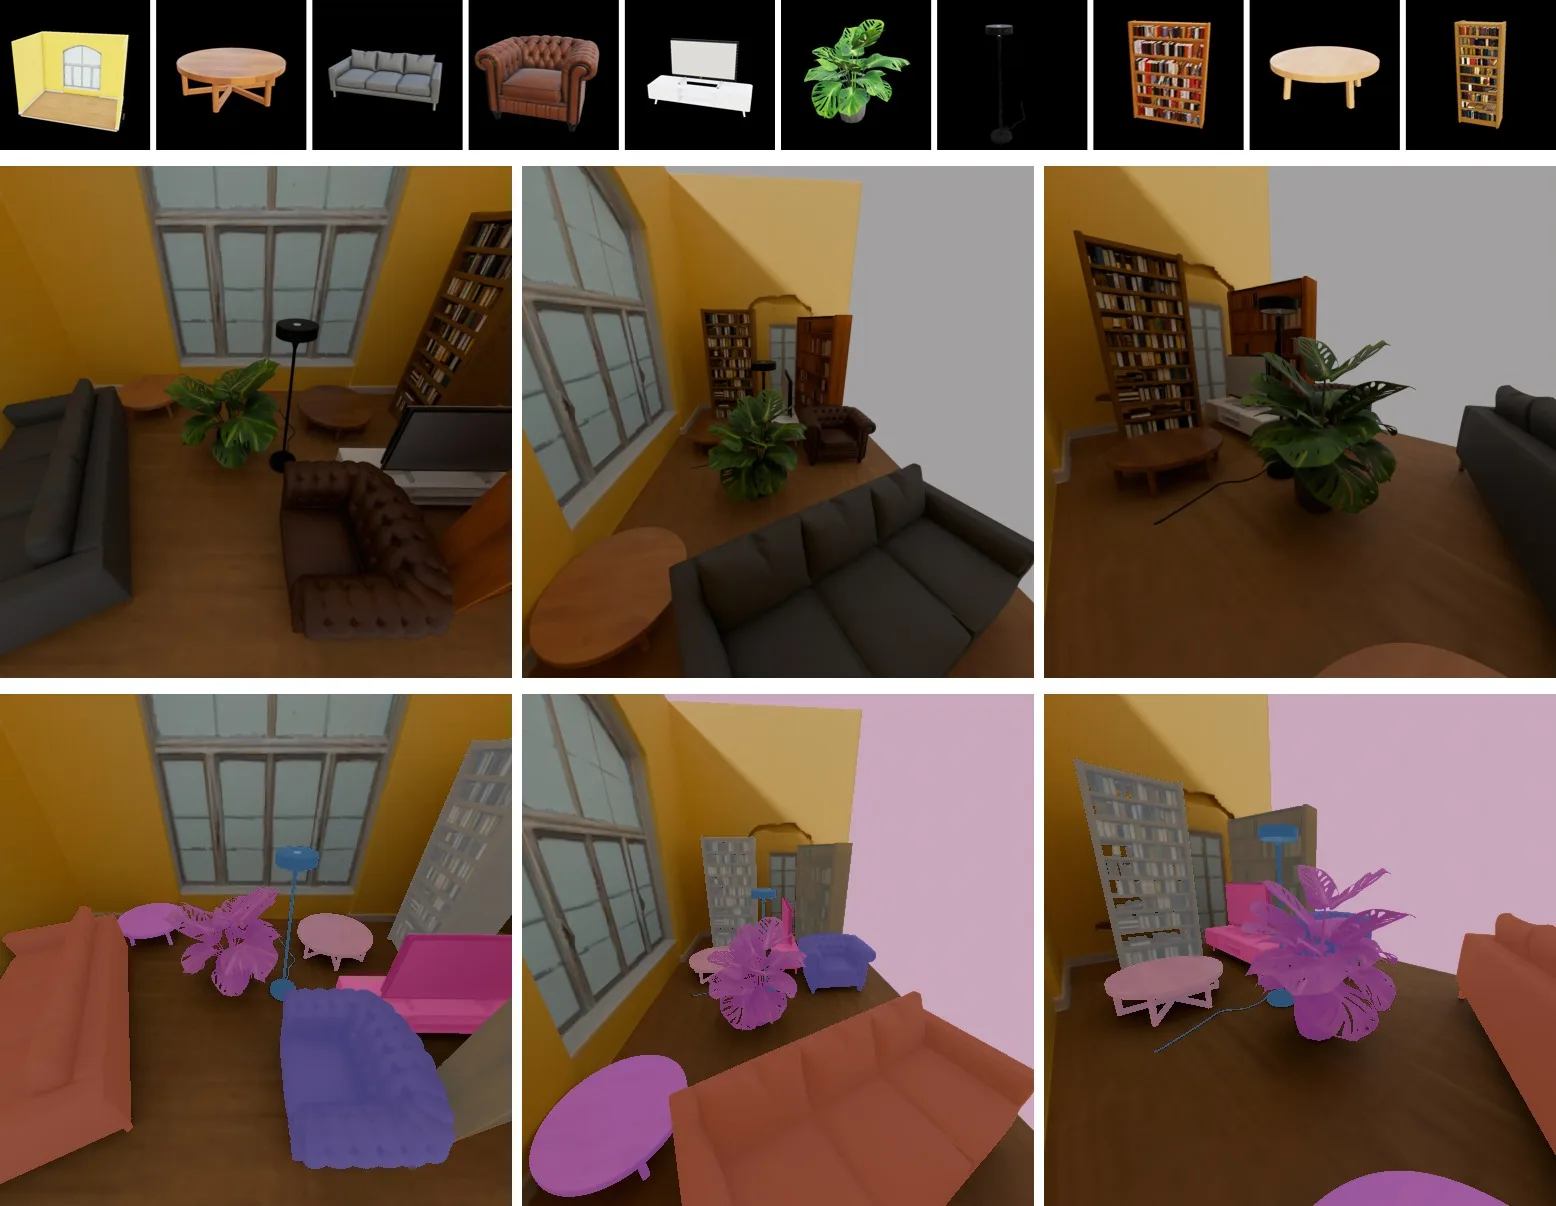
Każdy obiekt jest upuszczany na prawdziwą powierzchnię podparcia. Wszystko, co unosi się lub przechodzi przez ścianę, jest odrzucane, a kolizje są rozwiązywane. Kamery celują w umeblowany obszar, z polem widzenia dopasowanym do każdego obiektu, i zachowywane są tylko widoki, w których każdy obiekt jest widoczny (Rysunek 3).
2.4 Na dużą skalę
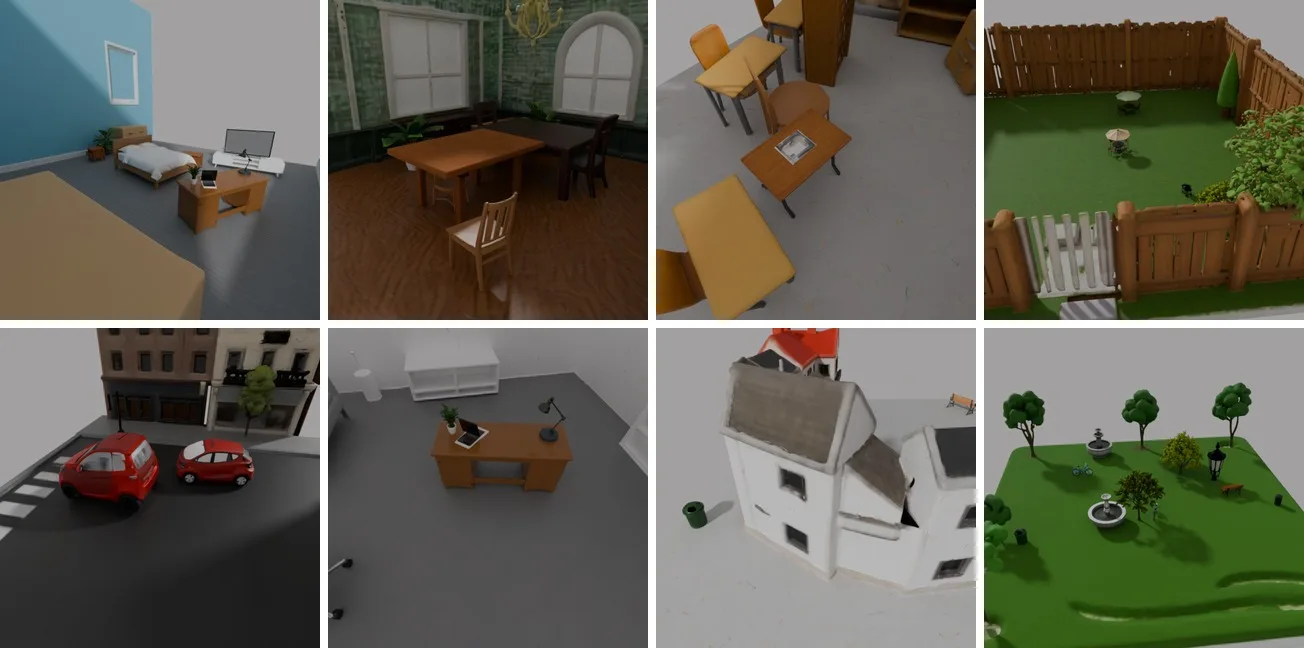
W mniej niż godzinę fabryka wyprodukowała 5500 zasobów w 16 typach pomieszczeń i 89 kategoriach obiektów. Z nich skomponowała 10 216 scen treningowych, z około sześcioma obiektami każda (Rysunek 4).
Skala ujawniła problem, który pilot ukrył: modele obrazu często ignorują „brak mebli” i i tak rysują umeblowane pomieszczenia, co uczy czegoś przeciwnego do dekompozycji. Nasz filtr geometryczny patrzy na każde pomieszczenie z góry i mierzy, ile podłogi jest wolne. Zachował 537 z 1493 środowisk.
3 Generowanie scen, a nie obiektów
3.1 Jedna sekwencja dla całego pomieszczenia
Wszystkie komponenty sceny, jedno środowisko i do trzydziestu obiektów, współdzielą jedną sekwencję tokenów w zamrożonym generatorze 3D. Każdy obiekt może odnosić się do każdego innego obiektu i do otaczającego go pomieszczenia.
3.2 Zaczynając od tego, co model już wie
Uczące się osadzenia typu i slotu odróżniają środowisko od obiektów i obiekty od siebie nawzajem. Zaczynają od zera, więc na pierwszym kroku treningowym model zachowuje się dokładnie tak, jak wstępnie wytrenowany. Trenowane są tylko lekkie adaptery.
3.3 Udoskonalenie w ramce własnej obiektu
Obiekty zajmują tylko kilka wokseli siatki o rozmiarze pomieszczenia. Udoskonalenie przenosi każdy obiekt do jego własnej znormalizowanej ramki, regeneruje go, uwzględniając całą scenę, i umieszcza go z powrotem dokładnie tam, gdzie był.
3.4 Architektura
- Model bazowy. TRELLIS.2-4B [1], generator obrazu do 3D z rzadkimi wokselami, z transformatorami dopasowującymi przepływ [3] dla struktury, kształtu i tekstury.
- Adaptery. LoRA [2] o randze 32 na każdej warstwie uwagi i MLP: 37M trenowalnych parametrów na zamrożonym rdzeniu.
- Faktoryzowana uwaga. Gęsta uwaga na scenie z 30 komponentami kosztuje 43 sekundy na krok treningowy. W naszym projekcie pięć z trzydziestu warstw zwraca uwagę na całą scenę, a reszta zwraca uwagę na każdy komponent, w reżimie, w którym model bazowy był wstępnie trenowany. Jest to około 3 razy tańsze.
4 Wyniki
4.1 Wyrównanie do kamery
Ocena w świecie rzeczywistym wymaga przewidywań w metrycznej ramce kamery. Rejestrujemy wygenerowaną scenę do widocznej głębi i oceniamy każdą kandydaturę pozycji pod kątem spójności mapy głębi. Bez tego sam błąd skali o 5% kosztuje 26 punktów F-score.
4.2 Skalowanie modelu
LifeSim Interiors poprawia się wraz z mocą obliczeniową treningu. Na odłożonych syntetycznych scenach, F-score przy 10 cm (im wyżej, tym lepiej) rośnie na każdym punkcie kontrolnym, zyskując około dziewięciu punktów za każdym razem, gdy trening się podwaja (Tabela 1).
| Kroki treningowe | 250 | 500 | 1,000 | 1,500 |
|---|---|---|---|---|
| F-score@0.1 | 4.3% | 11.6% | 21.3% | 26.8% |
Sam potok jest solidny: dekodowanie prawdziwych latentów i ocenianie ich jako przewidywań daje F-score 100%. Model uzyskuje również podobne wyniki na scenach, na których trenował, jak i na nowych, więc jest nadal niedotrenowany, a nie przetrenowany. Model widział niewielką część mocy obliczeniowej treningu, jaką zazwyczaj otrzymuje tego typu metoda.
5 Co dalej
Model się uczy; zatrzymaliśmy się wcześnie. Następne trzy kroki to: dłuższe trenowanie, komponowanie bardziej realistycznych pomieszczeń i generowanie prawdziwie pustych środowisk.
Mamy już przewagę w drugim kroku. Nasze laboratorium text-to-interior tworzy układy pomieszczeń za pomocą LLM i sprawdza każdy zasób za pomocą modelu wizyjnego. Wprowadzanie tych pomieszczeń do fabryki światów to nasz następny eksperyment.
Model w centrum jest kompaktowy. Większość prawdziwej pracy dzieje się wokół niego: tworzenie wiarygodnych światów, efektywne ich renderowanie i uczciwe mierzenie wyników w porównaniu z rzeczywistymi. Będziemy dzielić się więcej, gdy LifeSim Interiors dojrzeje.
Referencje
- Xiang, J., Chen, X., Xu, S., Wang, R., Lv, Z., et al. Native and Compact Structured Latents for 3D Generation. arXiv:2512.14692, 2025.
- Hu, E. J., Shen, Y., Wallis, P., Allen-Zhu, Z., Li, Y., Wang, S., Wang, L., Chen, W. LoRA: Low-Rank Adaptation of Large Language Models. arXiv:2106.09685, 2021.
- Lipman, Y., Chen, R. T. Q., Ben-Hamu, H., Nickel, M., Le, M. Flow Matching for Generative Modeling. arXiv:2210.02747, 2022.
Cytowanie
Prosimy cytować tę pracę jako:
@misc{lifesim2026interiors,
  title  = {LifeSim Interiors: From One Photo to a 3D Room You Can Take Apart},
  author = {{João Nobre} and {Cris Lenta}},
  year   = {2026},
  month  = {oct},
  url    = {https://lifesim.com/research/interiors}
}