


 English
 Español
 Português
 Bahasa Indonesia
 Română
 हिन्दी
 العربية
 Français
 Deutsch
 Русский
 Polski
 한국어
 日本語
 简体中文
 Türkçe
 Kiswahili
 বাংলা
 Filipino
10 ott 2026
Interni di LifeSim: da una foto a una stanza 3D smontabile
Abstract
Presentiamo LifeSim Interiors, un sistema di ricerca che genera una scena 3D decomposta da una singola immagine: un ambiente più ogni oggetto come propria mesh, ciascuno al posto giusto. Il sistema estende TRELLIS.2 [1] per generare congiuntamente un ambiente e fino a trenta oggetti, in un unico frame condiviso. Poiché non esiste un ampio dataset di stanze 3D decomposte, abbiamo costruito una pipeline che ha prodotto 5.500 asset e composto 10.216 scene di training fisicamente valide. Su scene sintetiche tenute fuori dal training, l'F-score a 10 cm aumenta dal 4,3% al 26,8% man mano che il training cresce da 250 a 1.500 passi, e la curva non mostra alcun plateau.
1 Introduzione
Una scena 3D è più di una superficie. È una stanza che potresti riorganizzare, un divano che potresti spostare, uno scaffale che potresti sostituire. Un sistema che comprende lo spazio deve recuperare quelle parti, non solo una singola mesh congelata.
LifeSim Interiors genera un ambiente più ogni oggetto come propria mesh. Si basa su lavori recenti nella distillazione da oggetto a scena e su TRELLIS.2 [1] di Microsoft. Abbiamo costruito l'intera pila in due giorni su Google Cloud. I nostri contributi sono:
- Una fabbrica di mondi: il testo diventa immagini, le immagini diventano asset 3D e gli asset diventano stanze fisicamente valide, su larga scala (Sezione 2).
- Un generatore di scene: un modello di oggetti 3D esteso per generare congiuntamente un ambiente e molti oggetti, in un unico frame condiviso (Sezione 3).
- Raffinamento degli oggetti: ogni oggetto viene rigenerato nel proprio frame con maggiori dettagli, condizionato dal resto della scena (Sezione 3.3).
- Misurazione: un protocollo di benchmark pubblico, più il nostro metodo per posizionare scene generate nel frame di una telecamera reale (Sezione 4).
2. Creazione di mondi
Non esiste un ampio set di dati di stanze 3D suddivise in parti separate, quindi ne creiamo uno. Un generatore di oggetti pre-addestrato crea le parti, e la nostra pipeline le assembla in stanze.
2.1 Dalle parole alle parti
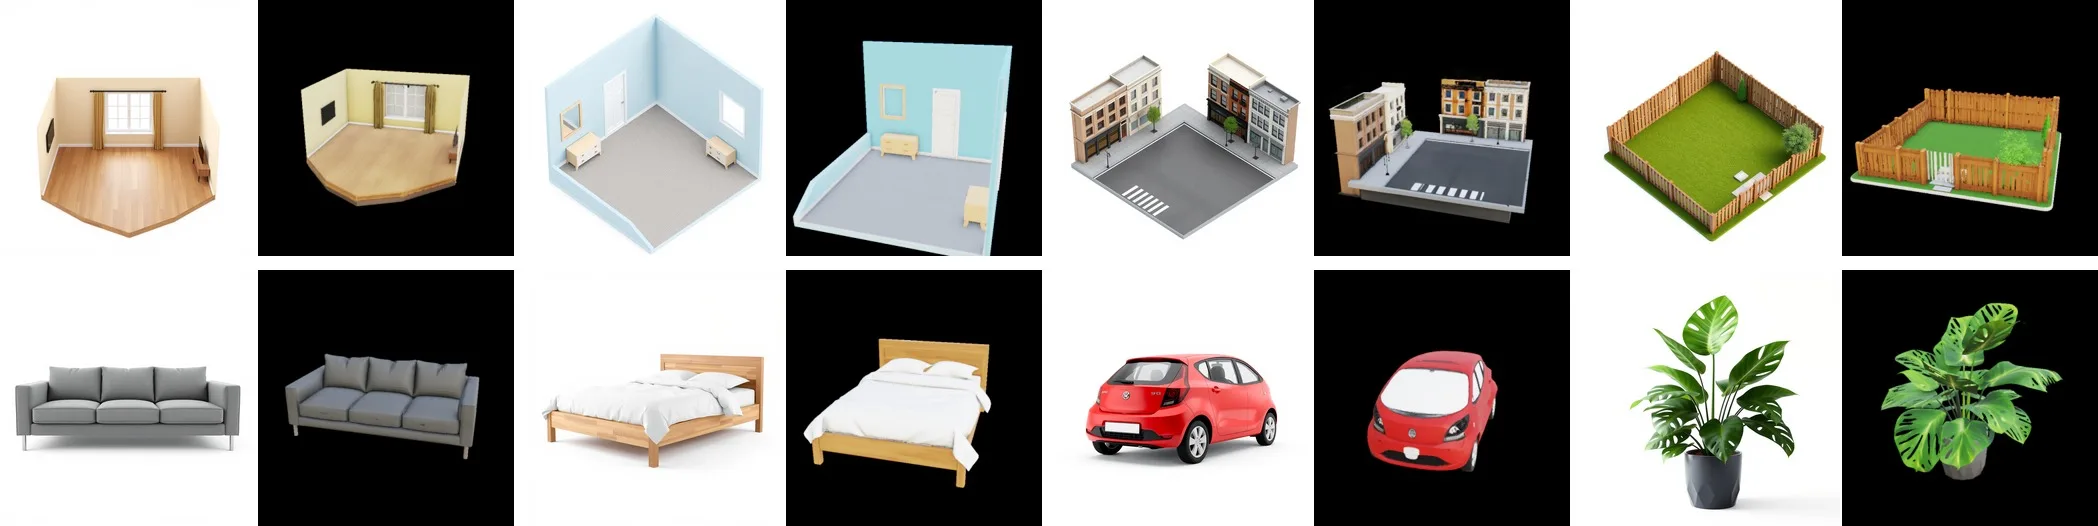
Ogni oggetto e ogni stanza inizia come una breve descrizione. Un modello di immagine la disegna, e TRELLIS.2 trasforma il disegno in un asset 3D texturizzato (Figura 1).
2.2 L'asset più difficile è una stanza vuota
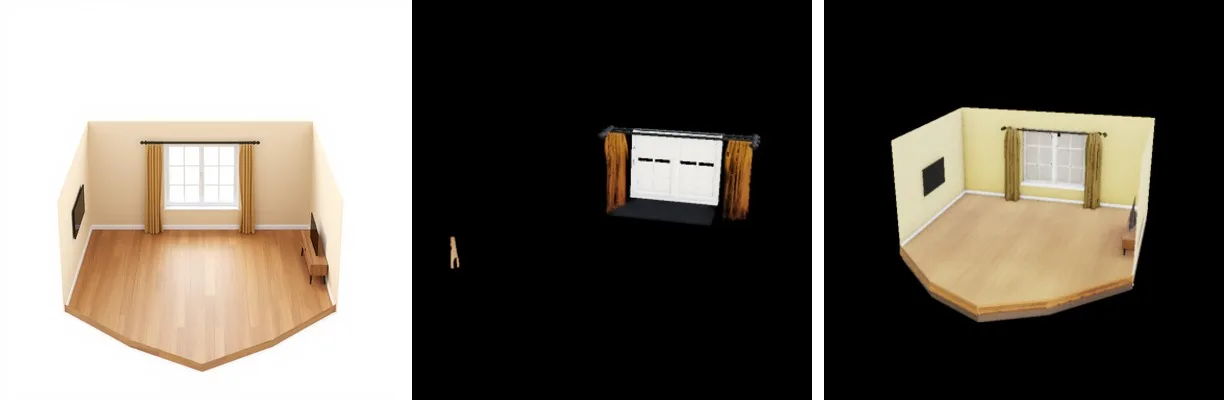
Una stanza vuota è sorprendentemente difficile da generare. La rimozione dello sfondo standard tratta pareti e pavimenti chiari come sfondo, quindi il nostro primo “soggiorno vuoto” è tornato come una finestra e due tende. Mascherare gli ambienti per colore mantiene intatta l'intera stanza (Figura 2).
2.3 Stanze che rispettano la fisica
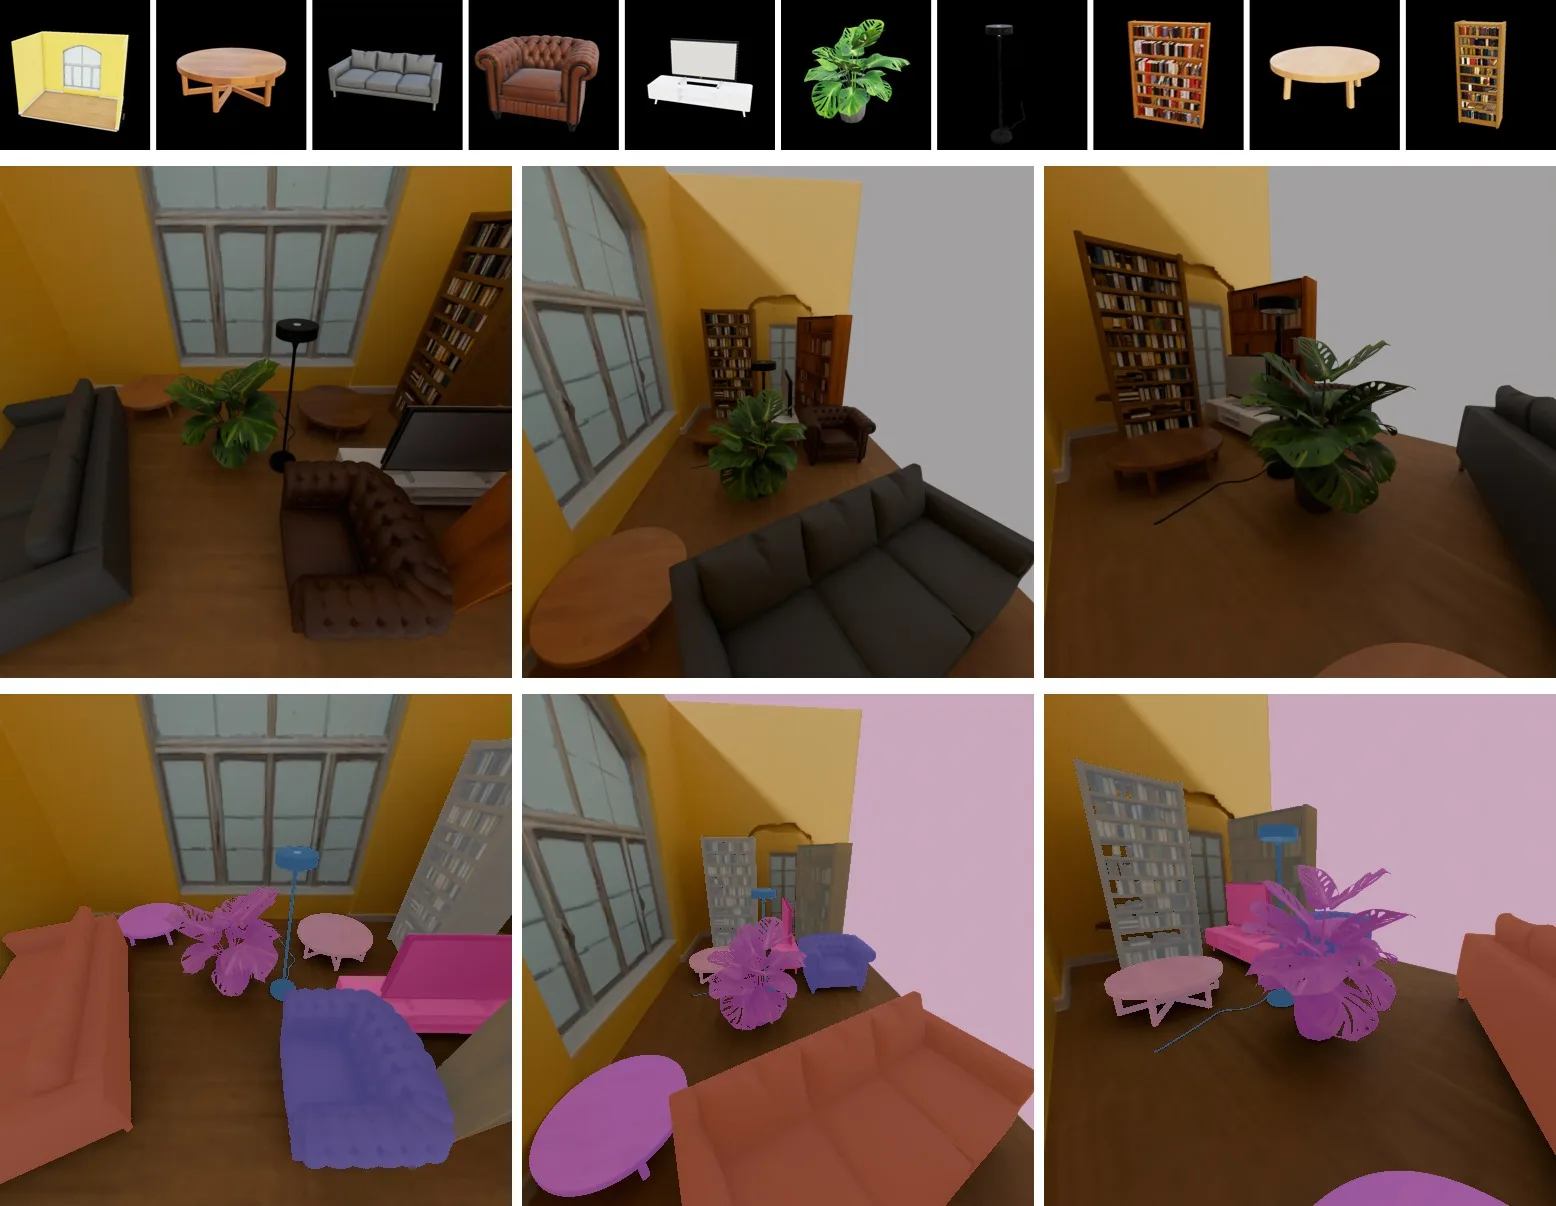
Ogni oggetto viene posizionato su una superficie di supporto reale. Tutto ciò che galleggia o attraversa una parete viene rifiutato e le collisioni vengono risolte. Le telecamere puntano alla regione arredata, con il campo visivo adattato a ogni oggetto, e vengono mantenute solo le viste in cui ogni oggetto è visibile (Figura 3).
2.4 Su larga scala
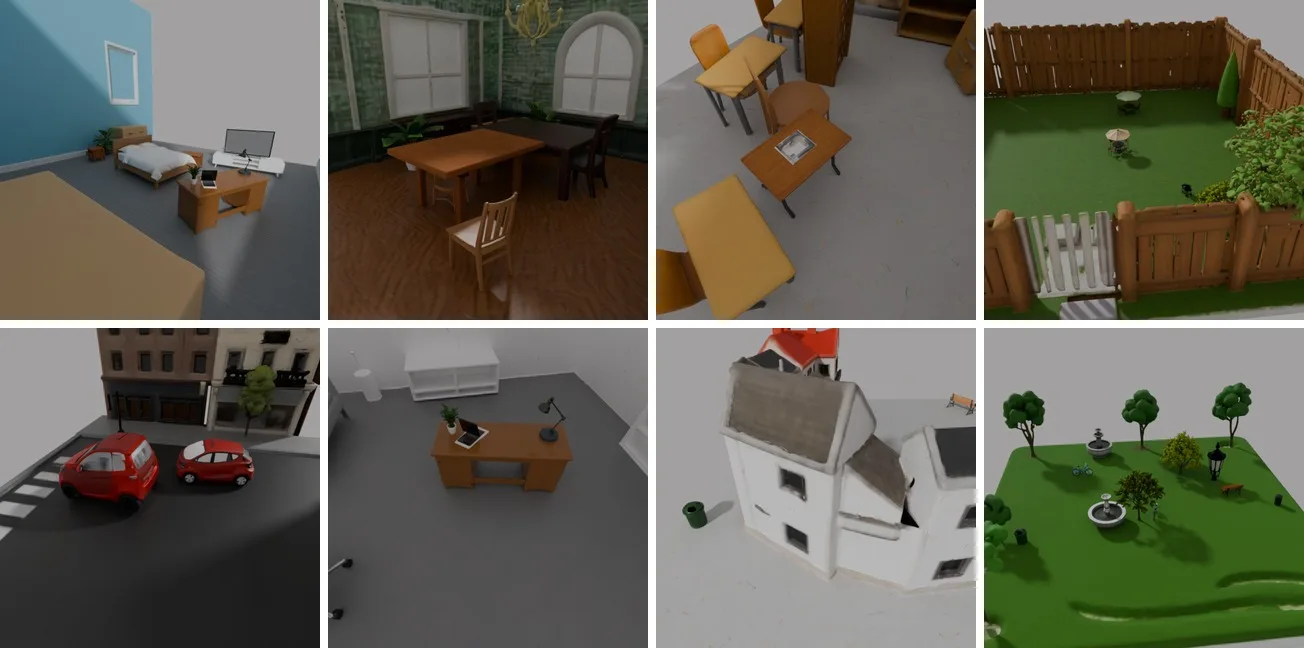
In meno di un'ora, la fabbrica ha prodotto 5.500 asset in 16 tipi di stanze e 89 categorie di oggetti. Da questi ha composto 10.216 scene di addestramento, con circa sei oggetti ciascuna (Figura 4).
La scala ha rivelato un problema che il pilota aveva nascosto: i modelli di immagine spesso ignorano “nessun arredamento” e disegnano comunque stanze arredate, il che insegna l'opposto della decomposizione. Il nostro filtro geometrico osserva ogni stanza dall'alto e misura quanta parte del pavimento è libera. Ha mantenuto 537 dei 1.493 ambienti.
3. Generazione di scene, non oggetti
3.1 Una sequenza per l'intera stanza
Tutti i componenti di una scena, un ambiente e fino a trenta oggetti, condividono un'unica sequenza di token su un generatore 3D congelato. Ogni oggetto può interagire con ogni altro oggetto e con la stanza che lo circonda.
3.2 Partire da ciò che il modello già conosce
Gli embedding di tipo e slot apprendibili distinguono l'ambiente dagli oggetti e gli oggetti tra loro. Partono da zero, quindi al primo passo di addestramento il modello si comporta esattamente come quello pre-addestrato. Vengono addestrati solo adattatori leggeri.
3.3 Affinamento nel frame dell'oggetto
Gli oggetti occupano solo pochi voxel di una griglia delle dimensioni di una stanza. L'affinamento sposta ogni oggetto nel proprio frame normalizzato, lo rigenera mentre interagisce con l'intera scena e lo riposiziona esattamente dove si trovava.
3.4 Architettura
- Modello base. TRELLIS.2-4B [1], un generatore da immagine a 3D a voxel sparsi con trasformatori di flow-matching [3] per struttura, forma e texture.
- Adattatori. LoRA [2] di rango 32 su ogni livello di attenzione e MLP: 37M parametri addestrabili su un backbone congelato.
- Attenzione fattorizzata. L'attenzione densa su una scena a 30 componenti costa 43 secondi per passo di addestramento. Nel nostro design, cinque dei trenta strati si occupano dell'intera scena e il resto si occupa di ogni componente, il regime in cui il modello base è stato pre-addestrato. Questo è circa 3 volte più economico.
4 Risultati
4.1 Allineamento alla telecamera
La valutazione nel mondo reale richiede previsioni nel frame metrico della telecamera. Registriamo la scena generata alla profondità visibile e valutiamo ogni posa candidata in base alla coerenza della mappa di profondità. Senza questo, un errore di scala del 5% da solo costa 26 punti di F-score.
4.2 Scalabilità del modello
LifeSim Interiors migliora con la potenza di calcolo dell'addestramento. Su scene sintetiche non viste, l'F-score a 10 cm (più alto è meglio) aumenta a ogni checkpoint, guadagnando circa nove punti ogni volta che l'addestramento raddoppia (Tabella 1).
| Passi di addestramento | 250 | 500 | 1,000 | 1,500 |
|---|---|---|---|---|
| F-score@0.1 | 4.3% | 11.6% | 21.3% | 26.8% |
La pipeline stessa è solida: decodificare i latenti di ground-truth e valutarli come previsioni dà un F-score del 100%. Il modello ottiene anche circa lo stesso punteggio su scene su cui si è addestrato che su quelle nuove, quindi è ancora sotto-addestrato, non overfit. Il modello ha visto una piccola frazione della potenza di calcolo di addestramento che di solito viene data a questo tipo di metodo.
5. Prossimi passi
Il modello sta imparando; ci siamo fermati presto. Tre passi successivi sono: addestrare più a lungo, comporre stanze più realistiche e generare ambienti veramente vuoti.
Abbiamo già un vantaggio sul secondo passo. Il nostro laboratorio text-to-interior scrive layout di stanze con un LLM e controlla ogni asset con un modello di visione. Alimentare quelle stanze nella fabbrica del mondo è il nostro prossimo esperimento.
Il modello al centro è compatto. La maggior parte del lavoro reale si svolge intorno ad esso: creare mondi credibili, renderizzarli in modo efficiente e misurare i risultati onestamente rispetto a quelli reali. Condivideremo di più man mano che LifeSim Interiors matura.
Riferimenti
- Xiang, J., Chen, X., Xu, S., Wang, R., Lv, Z., et al. Native and Compact Structured Latents for 3D Generation. arXiv:2512.14692, 2025.
- Hu, E. J., Shen, Y., Wallis, P., Allen-Zhu, Z., Li, Y., Wang, S., Wang, L., Chen, W. LoRA: Low-Rank Adaptation of Large Language Models. arXiv:2106.09685, 2021.
- Lipman, Y., Chen, R. T. Q., Ben-Hamu, H., Nickel, M., Le, M. Flow Matching for Generative Modeling. arXiv:2210.02747, 2022.
Citazione
Come citare questo lavoro:
@misc{lifesim2026interiors,
  title  = {LifeSim Interiors: From One Photo to a 3D Room You Can Take Apart},
  author = {{João Nobre} and {Cris Lenta}},
  year   = {2026},
  month  = {oct},
  url    = {https://lifesim.com/research/interiors}
}