


 English
 Español
 Português
 Bahasa Indonesia
 Română
 हिन्दी
 العربية
 Français
 Deutsch
 Русский
 Italiano
 한국어
 日本語
 简体中文
 Türkçe
 Kiswahili
 বাংলা
 Filipino
27 paź 2026
Adam i Ewa: 700 mięśni kontrolowanych przez LLM za pomocą dopracowanych modeli decyzyjnych
Abstrakt
Adam i Ewa to dwaj symulowani ludzie, każdy z 700 mięśniami, mieszkający razem w Pałacu Sztuk Pięknych w San Francisco. Modele językowe sterują każdą warstwą, którą model językowy może sterować: co robić w ciągu dnia, gdzie iść, jak utrzymać równowagę, gdzie stawiać każdą stopę i jak mocno napinać każdy mięsień. Trzy z tych modeli są nasze własne: 144M-parametrowe dostrojenia, trenowane na CPU w 4 do 11 minut każde, które kopiują swoich nauczycieli z korelacją od 0,958 do 0,9998 na danych wejściowych, których nigdy nie widziały. Bez uprzęży, oba ciała stoją po pchnięciach o sile 80 N i przechodzą kilkadziesiąt kroków między upadkami. To jest eksperyment, a nie produkt. Raportujemy, co działa, co nie działa i jakie są liczby.
1 Eksperyment
Technologia rozwija się tak szybko, że nikt nie wie, dokąd zmierza symulacja. Rok temu model językowy potrafił prowadzić rozmowę. Dziś potrafi zaplanować tydzień, używać narzędzi i działać przez wiele godzin. Nie wiemy, gdzie jest granica, więc spróbowaliśmy ją znaleźć.
Pytanie było proste: jak głęboko może zejść model językowy? Postacie w LifeSim już myślą za pomocą modeli językowych. Decydują, co robić, z kim rozmawiać i dokąd iść. Poniżej tego, każda gra używa animacji. Ciało, które chodzi, to ciało, które odtwarza nagranie.
Zastąpiliśmy nagranie ciałem. MS-Human-700 [1] to otwarty model ludzkiego układu mięśniowo-szkieletowego z 700 mięśniami, symulowany w MuJoCo [2]. Umieściliśmy dwa takie modele w jednej scenie, na podłodze stworzonej z prawdziwej mapy, i przekazaliśmy każdą możliwą decyzję modelowi językowemu. Nie wiedzieliśmy, czy będzie stać. Udało się.
2 Warstwy
Skopiowaliśmy warstwy ciała i umysłu, i każdej warstwie, która może być modelem językowym, przypisaliśmy jeden (Tabela 1). Tylko rdzeń kręgowy to kod: zamienia „pochyl się trochę do tyłu” lub „postaw stopę tutaj” w 700 pociągnięć mięśni.
| Warstwa | U człowieka | Model | Jak często |
|---|---|---|---|
| Życie | Co robić w ciągu dnia | Gemma 3 4B [3], dostrojona przez nas za pomocą GRPO [4] na LifeSim Week | Raz na aktywność, ~4 s |
| Kora ruchowa | „Idź tam, usztywnij tułów” | Gemini 3.1 Flash-Lite | Mniej więcej raz na sekundę, ~1 s |
| Pień mózgu | Utrzymuje cię w pozycji pionowej | LifeSim-Brainstem-0.1 (nasz) | 2 pytania na takt, w pozycji stojącej |
| Decyzja o kroku | Gdzie ląduje następna stopa | LifeSim-Step-0.3 (nasz) | 2 pytania na takt, podczas chodzenia |
| Rdzeń kręgowy | Stałe okablowanie | Kod | Co takt |
| Mięśnie | Kurczą się | LifeSim-Muscle-0.1 (nasz) | 700 pytań na takt, na osobę |
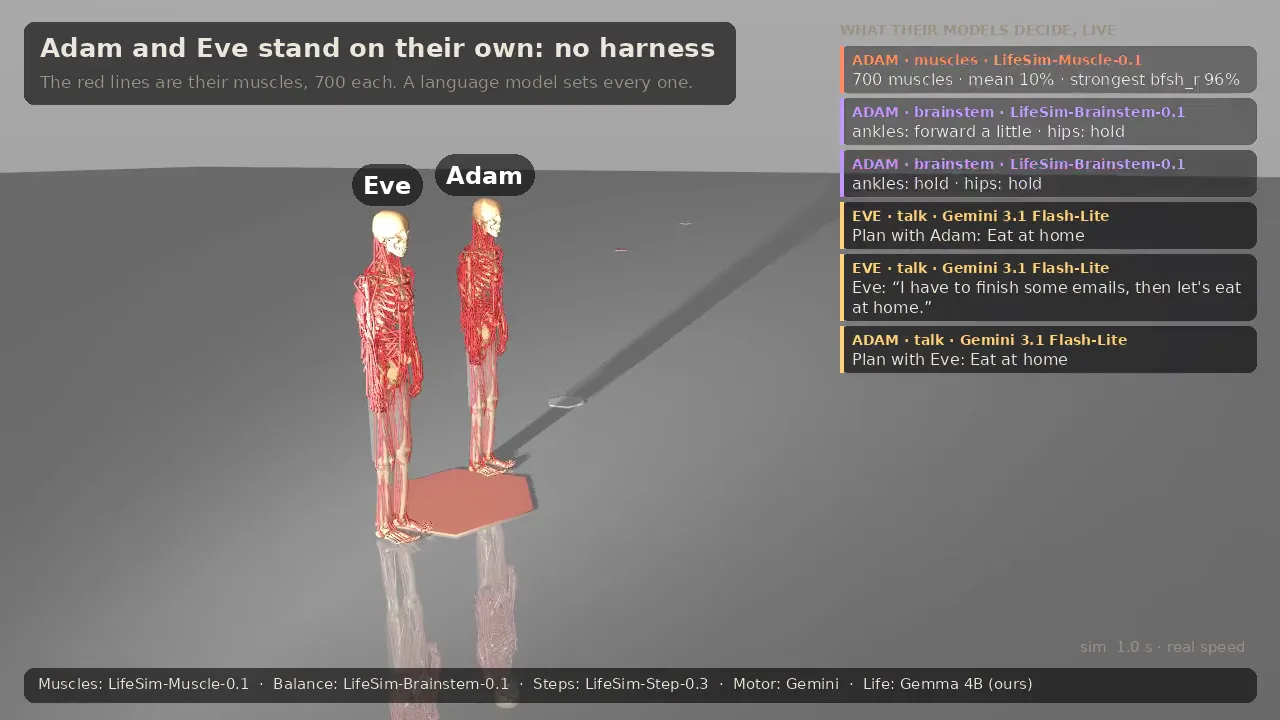
Każda warstwa mówi słowami. Pień mózgu odczytuje „ciężar jest 3 cm przed środkiem stóp, poruszając się do przodu z prędkością 4 cm/s” i odpowiada, jak się pochylić. Każdy mięsień odczytuje linię swojego regionu ciała z kory ruchowej i impuls z rdzenia kręgowego, i odpowiada, jak mocno się skurczyć.
Adam i Ewa wiedzą też o sobie nawzajem. Każdy model życia odczytuje, gdzie jest partner i co robi. Kiedy się spotykają, Gemini pisze jedną linijkę dla każdego z nich, i mogą uzgodnić plan: „chcesz później zjeść kolację w Kibatsu?” (Rysunek 3).
3 Trzy małe modele
Trzy najniższe warstwy odpowiadają na do 1400 pytań co 10 ms, więc potrzebują małego modelu. Użyliśmy Julia 1, modelu 144M-parametrowego zbudowanego na enkoderze ModernBERT [5] (22 warstwy, ukryty rozmiar 384) z głowicą decyzyjną, i dostroiliśmy trzy kopie. Każda z nich uczyła się od nauczyciela napisanego w kodzie: kodu pnia mózgu, kodu reguły kroku i formuły mięśni.
| Model | Trening na CPU | Podstawowa Julia 1 | Dostrojony |
|---|---|---|---|
| LifeSim-Brainstem-0.1 | 216 s | r = −0.37 | r = 0.9997 |
| LifeSim-Step-0.3 | 308 s | r = 0.24 | r = 0.9998 |
| LifeSim-Muscle-0.1 | 642 s | r = 0.12 | r = 0.958 |
Wysoka korelacja na danych wejściowych wyłączonych z treningu nie wystarcza do chodzenia. Model kroku początkowo uczył się tylko z sytuacji, które napotkała reguła kodu, a po przejęciu kontroli wprowadzał ciało w sytuacje, których reguła nigdy nie widziała. Pozwoliliśmy mu chodzić, nagrywaliśmy, co napotkał, pytaliśmy regułę, co by zrobiła, i trenowaliśmy ponownie (DAgger [6]). Czas chodzenia wzrósł z 83% do 92% czasu nauczyciela.
Dostrojenia są deterministyczne, więc to samo pytanie zawsze otrzymuje tę samą odpowiedź. Zachowujemy każdą odpowiedź i zadajemy modelowi tylko pytania, których nie widział. Po kilku sekundach większość taktów nie wymaga w ogóle wywołania modelu.
4 Wyniki
4.1 Stanie
Z każdą warstwą na modelu językowym, oba ciała stoją bez uprzęży i odzyskują równowagę po pchnięciach o sile 80 N z przodu i z tyłu. W ciągu 20 pchniętych stania, model pnia mózgu stoi tak długo, jak jego nauczyciel: 12,4 s wobec 12,0 s.
4.2 Chodzenie
Chodzik to SIMBICON [7] na mięśniach: licznik kroków, noga wahadłowa i umiejscowienie stopy na podstawie pozycji i prędkości ciężaru. Bez uprzęży, ciała chodzą z prędkością około 0,25 m/s, kierując się w stronę celu. W symulacji na żywo, mediana spaceru trwała 18 kroków między upadkami, a najdłuższy 133 (Rysunek 2).
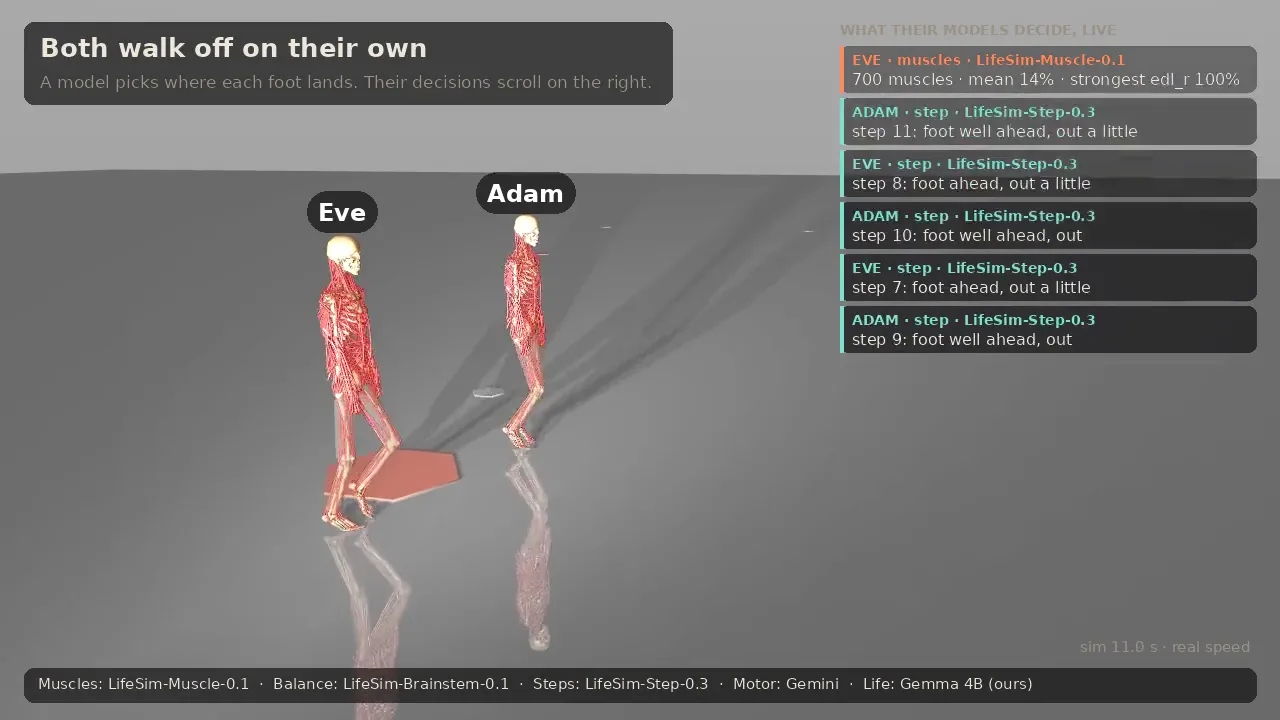
Podczas 12-sekundowego spaceru model kroku utrzymuje ciało w pozycji pionowej średnio przez 8,6 s, w porównaniu do 9,4 s dla reguły kodu, która go nauczyła (24 spacery). Stanie wybacza drobne błędy. Chodzenie nie.
4.3 Prędkość
Wszystko działa na jednej maszynie CPU, bez GPU. Symulacja czeka na modele („wolny czas”), ponieważ równowaga wymaga decyzji co 10 ms. Oba ciała z każdym modelem działają z prędkością od 0,25 do 0,5× czasu rzeczywistego, a od 0,12 do 0,18×, gdy oba są rysowane.
4.4 W LifeSim
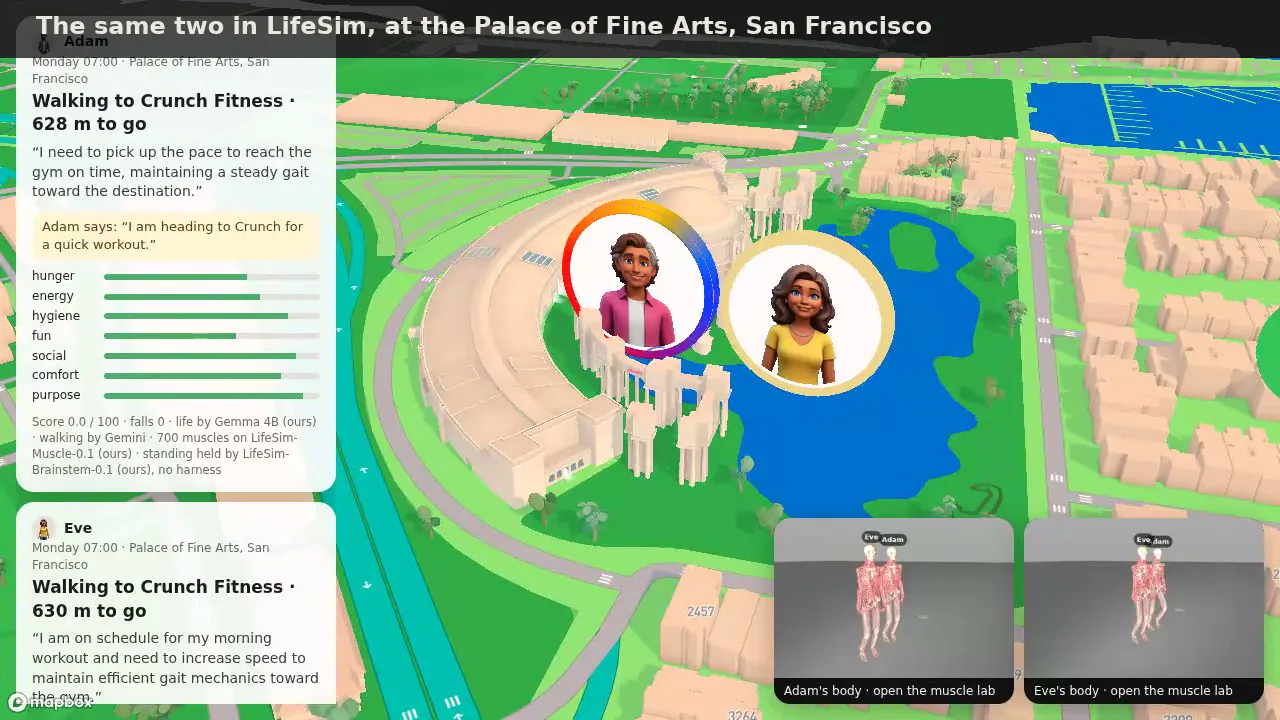
Te same dwie osoby pojawiają się na mapie LifeSim, ze swoimi potrzebami, planami i tym, co mówią do siebie nawzajem (Rysunek 3).
5 Czego się nauczyliśmy
- Słowa muszą zawierać liczby. „Lekkie pochylenie do przodu” jest zbyt niejasne, aby utrzymać równowagę: ciało upadało w ciągu 3 do 6 sekund. „Ciężar jest 3 cm przed środkiem stóp, poruszając się do przodu z prędkością 4 cm/s” utrzymuje je w pozycji pionowej.
- Słowa mózgu określają rozdzielczość mięśni. Pod hasłem „stój nieruchomo” model mięśni odpowiada w krokach około 15%. Pod hasłem „utrzymaj stabilność z precyzyjną kontrolą” kroki wynoszą około 10%, i dopiero wtedy ciało przeżywa pchnięcie z przodu.
- Mięśnie działają jak neurony ruchowe. Model mięśni odpowiada w dużych krokach. Naprzemienne przełączanie między sąsiednimi krokami z taktu na takt, jak częstotliwość wyładowań, sprawia, że spacery trwają około 50% dłużej.
- Chodzenie jest chaotyczne. Zmiana jednego parametru o jedną milionową zmienia czas trwania spaceru o jedną trzecią. Jedno uruchomienie niczego nie dowodzi, więc każda liczba dotycząca chodzenia jest średnią z 12 lub więcej spacerów.
6 Co jeszcze nie działa
- Zatrzymywanie się. Idące ciało, oddane równowadze stojącej, upada w ciągu sekundy: 0 z 20 prób zakończyło się sukcesem. Po dotarciu ciało wtapia się w pozycję stojącą. Jest to animacja i tak ją oznaczamy.
- Wstawanie. Po upadku ciało wraca do pozycji stojącej w ciągu jednej sekundy. Również animacja.
- Inne prędkości. Działa tylko prędkość, na którą dostrojono chodzącego.
- Więcej strojenia. Trzy metody wyszukiwania (ewolucja, CMA-ES i Augmented Random Search) nie poprawiły chodzącego. Solidniejszy wymaga kontrolera całego ciała lub polityki wytrenowanej z uczeniem wzmocnionym na GPU.
7 Dlaczego tego próbowaliśmy
Nie zamierzaliśmy zbudować najlepszego chodzącego. Uczenie wzmocnione tworzy lepsze. Postanowiliśmy sprawdzić, czy jeden rodzaj modelu może sięgać od „co robię dziś wieczorem” do „który mięsień ciągnie z jaką siłą”. Może, z pomocą kilku linii kodu pośrodku. Małe otwarte modele, dostrojone na CPU w kilka minut, mogą przejąć większość warstw.
Nie wiemy jeszcze, do czego to służy. Być może ludzie w LifeSim, którzy poruszają się, ponieważ tak decydują, a nie dlatego, że odtwarzana jest animacja. Być może do niczego. Technologia rozwija się zbyt szybko, by to stwierdzić, dlatego warto próbować takich rzeczy teraz i dzielić się tym, co odkryjemy.
8 Przyszłe prace
Najbardziej obiecującym wynikiem jest to, że słowa zmieniają ciało: „utrzymuj stabilność z precyzyjną kontrolą” dało mięśniom dokładniejszą rozdzielczość niż „stój nieruchomo”, i dopiero wtedy ciało przetrwało pchnięcie z przodu. Następny eksperyment ma na celu pokazanie tego samego ciała reagującego na różne słowa, takie jak „chodź, jakbyś był zmęczony”, „przygotuj się na pchnięcie” lub „zrelaksuj się”. Kontroler kodu nie może przyjąć takiej instrukcji. Model językowy może.
Referencje
- Zuo, C., He, K., Shao, J., Sui, Y. Self Model for Embodied Intelligence: Modeling Full-Body Human Musculoskeletal System and Locomotion Control with Hierarchical Low-Dimensional Representation. ICRA, 2024.
- Todorov, E., Erez, T., Tassa, Y. MuJoCo: A physics engine for model-based control. IROS, 2012.
- Gemma Team. Gemma 3 Technical Report. arXiv:2503.19786, 2025.
- Shao, Z., Wang, P., Zhu, Q., Xu, R., Song, J., et al. DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models. arXiv:2402.03300, 2024.
- Warner, B., Chaffin, A., Clavié, B., Weller, O., Hallström, O., et al. Smarter, Better, Faster, Longer: A Modern Bidirectional Encoder for Fast, Memory Efficient, and Long Context Finetuning and Inference. arXiv:2412.13663, 2024.
- Ross, S., Gordon, G. J., Bagnell, J. A. A Reduction of Imitation Learning and Structured Prediction to No-Regret Online Learning. AISTATS, 2011.
- Yin, K., Loken, K., van de Panne, M. SIMBICON: Simple Biped Locomotion Control. ACM SIGGRAPH, 2007.
Cytowanie
Prosimy cytować tę pracę jako:
@misc{lifesim2026adamandeve,
  title  = {Adam & Eve: 700 LLM-Controlled Muscles via Fine-Tuned Decision Models},
  author = {{Cris Lenta}},
  year   = {2026},
  month  = {oct},
  url    = {https://lifesim.com/research/adam-and-eve}
}