


 English
 Español
 Português
 Bahasa Indonesia
 Română
 हिन्दी
 العربية
 Français
 Deutsch
 Русский
 Polski
 한국어
 日本語
 简体中文
 Türkçe
 Kiswahili
 বাংলা
 Filipino
27 ott 2026
Adamo ed Eva: 700 muscoli controllati da LLM tramite modelli decisionali ottimizzati
Abstract
Adam ed Eva sono due umani simulati con 700 muscoli ciascuno, che vivono insieme al Palace of Fine Arts di San Francisco. I modelli linguistici gestiscono ogni loro strato che un modello linguistico può gestire: cosa fare durante il giorno, dove camminare, come mantenere l'equilibrio, dove poggia ogni piede e quanto forte tira ogni muscolo. Tre di questi modelli sono nostri: fine-tuning da 144M parametri, addestrati su una CPU in 4-11 minuti ciascuno, che copiano i loro insegnanti con una correlazione da 0,958 a 0,9998 su input che non hanno mai visto. Senza imbracatura, entrambi i corpi resistono a spinte di 80 N e camminano per alcune decine di passi tra una caduta e l'altra. Questo è un esperimento, non un prodotto. Riportiamo cosa funziona, cosa no e i numeri.
1 Un esperimento
La tecnologia si sta muovendo così velocemente che nessuno sa dove andrà la simulazione. Un anno fa, un modello linguistico poteva sostenere una conversazione. Oggi, può pianificare una settimana, usare strumenti e funzionare per ore. Non sappiamo dove sia il limite, quindi abbiamo cercato di trovarlo.
La domanda era semplice: quanto in basso può arrivare un modello linguistico? Le persone di LifeSim pensano già con modelli linguistici. Decidono cosa fare, con chi parlare e dove andare. Sotto questo, ogni gioco usa l'animazione. Un corpo che cammina è un corpo che riproduce una registrazione.
Abbiamo sostituito la registrazione con un corpo. MS-Human-700 [1] è un modello aperto del sistema muscolo-scheletrico umano con 700 muscoli, simulato in MuJoCo [2]. Ne abbiamo messi due in una scena, su un pavimento ricavato dalla mappa reale, e abbiamo affidato ogni decisione possibile a un modello linguistico. Non sapevamo se sarebbe rimasto in piedi. Lo ha fatto.
2 Gli strati
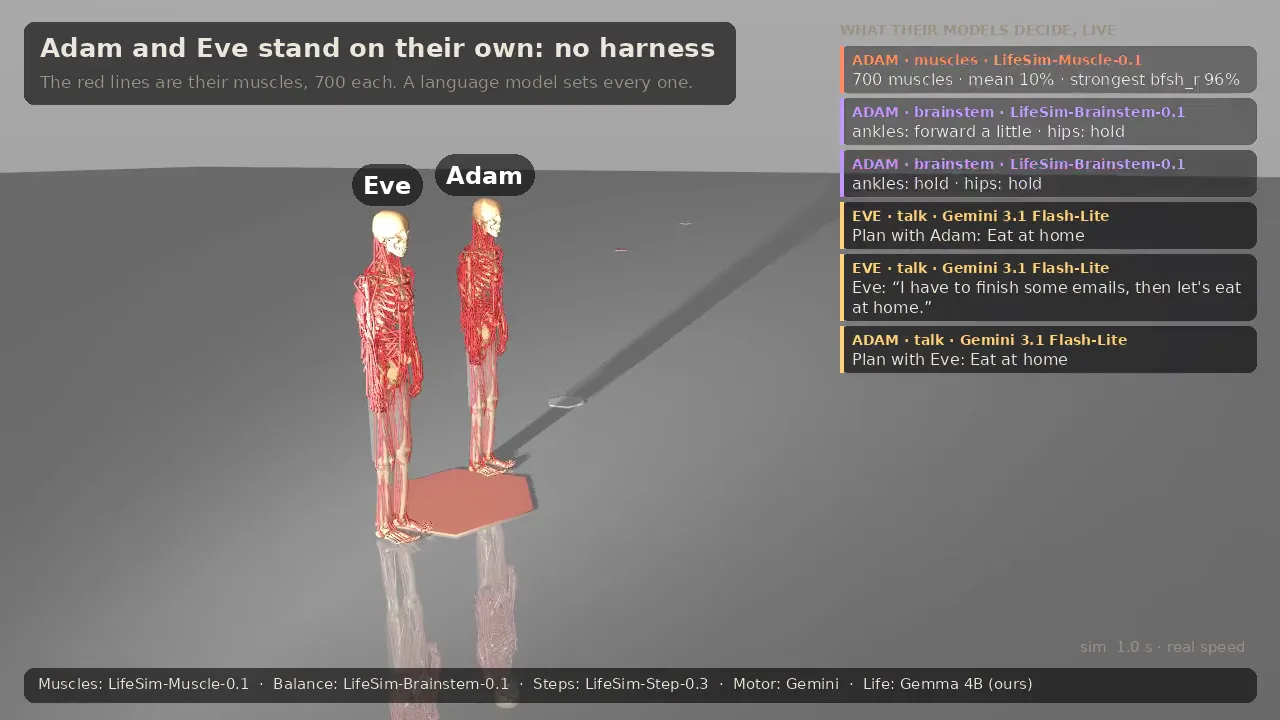
Abbiamo copiato gli strati di un corpo e di una mente, e abbiamo affidato ogni strato che può essere un modello linguistico a uno (Tabella 1). Solo il midollo spinale è codice: trasforma “piegati un po' all'indietro” o “metti il piede qui” in 700 trazioni muscolari.
| Strato | In una persona | Modello | Frequenza |
|---|---|---|---|
| Vita | Cosa fare durante il giorno | Gemma 3 4B [3], ottimizzato da noi con GRPO [4] su LifeSim Week | Una volta per attività, ~4 s |
| Corteccia motoria | “Cammina lì, irrigidisci il tronco” | Gemini 3.1 Flash-Lite | Circa una volta al secondo, ~1 s |
| Tronco encefalico | Ti mantiene in posizione eretta | LifeSim-Brainstem-0.1 (nostro) | 2 domande per tick, in piedi |
| Decisione del passo | Dove poggia il prossimo piede | LifeSim-Step-0.3 (nostro) | 2 domande per tick, camminando |
| Midollo spinale | Cablaggio fisso | Codice | Ogni tick |
| Muscoli | Contrazione | LifeSim-Muscle-0.1 (nostro) | 700 domande per tick, per persona |
Ogni strato parla a parole. Il tronco encefalico legge “il peso è 3 cm davanti al centro dei piedi, si muove in avanti a 4 cm/s” e risponde come inclinarsi. Ogni muscolo legge la linea della sua regione corporea dalla corteccia motoria e un impulso dal midollo spinale, e risponde quanto forte contrarsi.
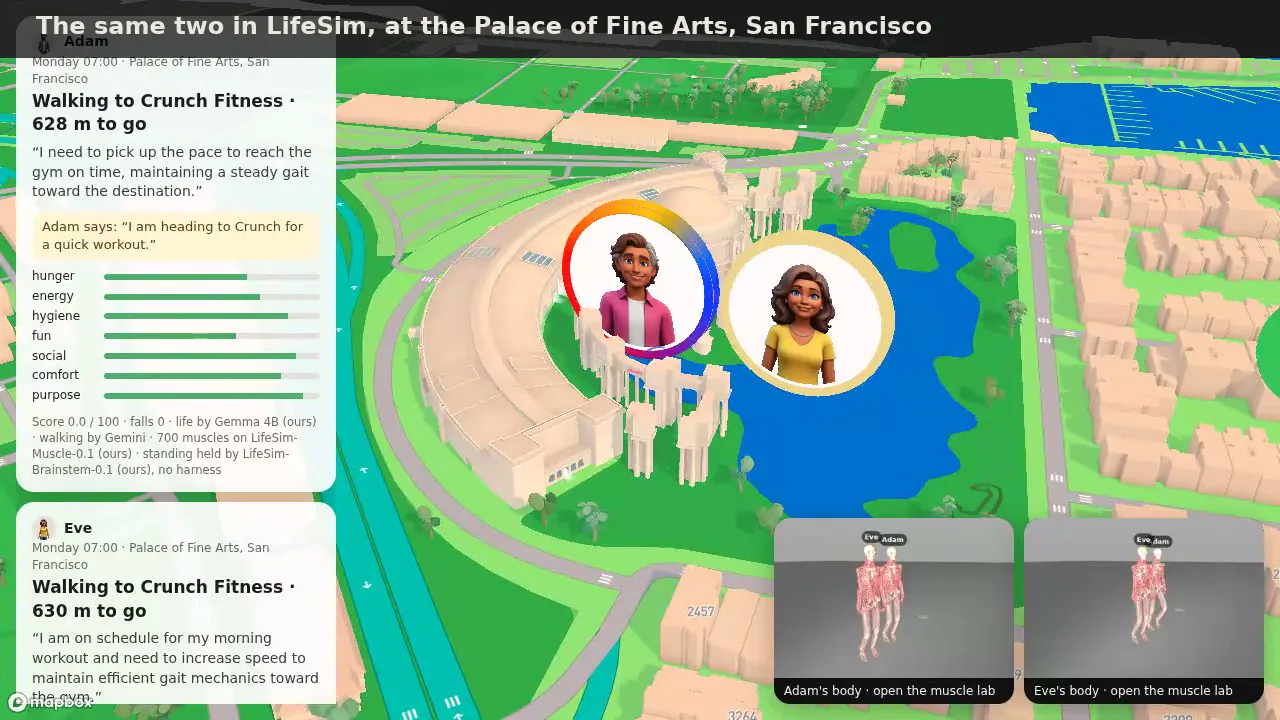
Adam ed Eva si conoscono anche. Ogni modello di vita legge dove si trova il partner e cosa sta facendo. Quando i due si incontrano, Gemini scrive una riga per ciascuno di loro, e possono concordare un piano: “vuoi cenare al Kibatsu più tardi?” (Figura 3).
3 Tre piccoli modelli
I tre strati più bassi rispondono fino a 1.400 domande ogni 10 ms, quindi hanno bisogno di un piccolo modello. Abbiamo usato Julia 1, un modello da 144M parametri costruito su un encoder ModernBERT [5] (22 strati, dimensione nascosta 384) con una testa decisionale, e abbiamo ottimizzato tre copie. Ognuna ha imparato da un insegnante scritto in codice: il tronco encefalico in codice, la regola del passo in codice e la formula muscolare.
| Modello | Addestramento su una CPU | Base Julia 1 | Ottimizzato |
|---|---|---|---|
| LifeSim-Brainstem-0.1 | 216 s | r = −0.37 | r = 0.9997 |
| LifeSim-Step-0.3 | 308 s | r = 0.24 | r = 0.9998 |
| LifeSim-Muscle-0.1 | 642 s | r = 0.12 | r = 0.958 |
Un'alta correlazione su input non visti non è sufficiente per camminare. Il modello del passo ha imparato inizialmente solo dalle situazioni incontrate dalla regola del codice, e una volta in controllo ha portato il corpo in situazioni che la regola non aveva mai visto. Lo abbiamo lasciato camminare, abbiamo registrato ciò che ha incontrato, abbiamo chiesto alla regola cosa avrebbe fatto e abbiamo addestrato di nuovo (DAgger [6]). Il tempo di camminata è aumentato dall'83% al 92% di quello dell'insegnante.
I fine-tuning sono deterministici, quindi la stessa domanda ottiene sempre la stessa risposta. Manteniamo ogni risposta e poniamo al modello solo domande che non ha visto. Dopo pochi secondi, la maggior parte dei tick non richiede alcuna chiamata al modello.
4 Risultati
4.1 Stare in piedi
Con ogni strato su un modello linguistico, entrambi i corpi stanno in piedi senza imbracatura e si riprendono da spinte di 80 N da davanti e da dietro. Su 20 posizioni spinte, il modello del tronco encefalico sta in piedi quanto il suo insegnante: 12,4 s contro 12,0 s.
4.2 Camminare
Il camminatore è SIMBICON [7] sui muscoli: un timer per i passi, una gamba oscillante e il posizionamento del piede in base alla posizione e alla velocità del peso. Senza imbracatura, i corpi camminano a circa 0,25 m/s, dirigendosi verso l'obiettivo. Nella simulazione dal vivo, la camminata mediana è durata 18 passi tra una caduta e l'altra, e la più lunga 133 (Figura 2).
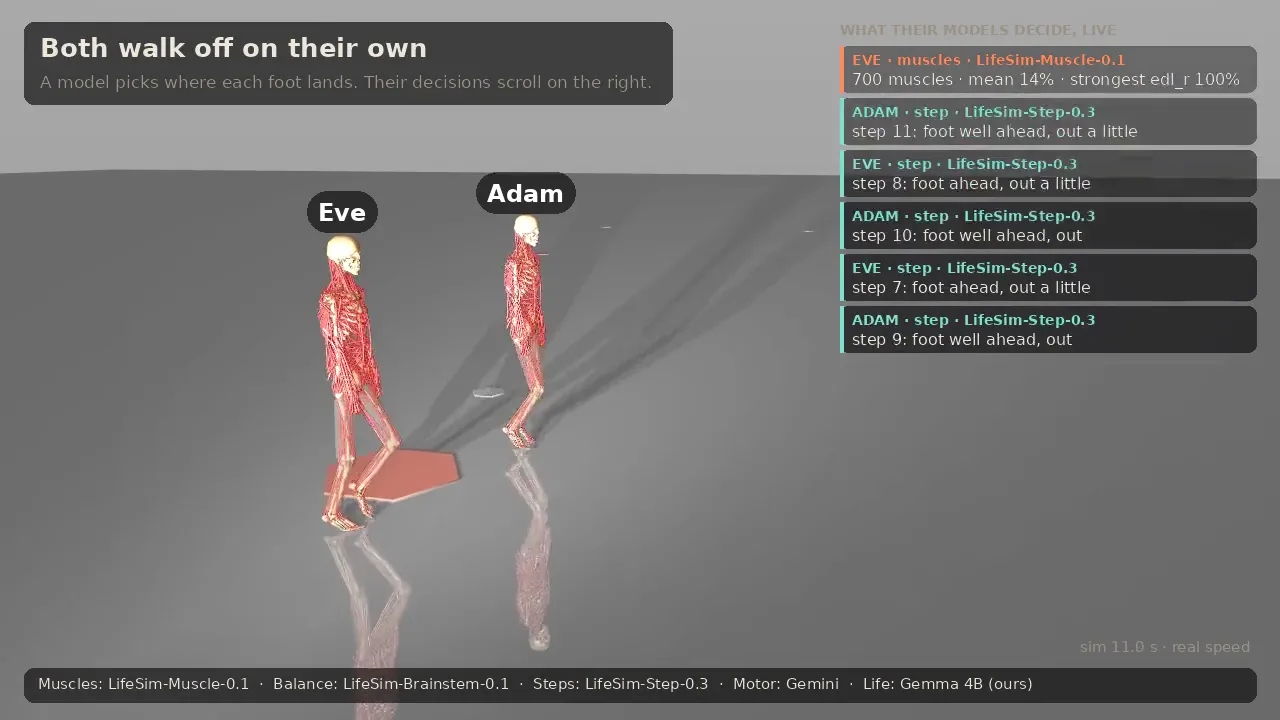
In una camminata di 12 s, il modello del passo mantiene il corpo in piedi per 8,6 s in media, contro i 9,4 s della regola del codice che lo ha insegnato (24 camminate). Stare in piedi perdona piccoli errori. Camminare no.
4.3 Velocità
Tutto funziona su una macchina CPU, senza GPU. La simulazione attende i modelli (“tempo lento”), perché l'equilibrio richiede una decisione ogni 10 ms. Entrambi i corpi con ogni modello funzionano a 0,25-0,5 volte il tempo reale, e a 0,12-0,18 volte mentre entrambi sono disegnati.
4.4 In LifeSim
Le stesse due persone appaiono sulla mappa di LifeSim, con i loro bisogni, i loro piani e ciò che si dicono (Figura 3).
5 Cosa abbiamo imparato
- Le parole devono portare numeri. “Piegarsi un po' in avanti” è troppo vago per mantenere l'equilibrio: il corpo cadeva in 3-6 s. “Il peso è 3 cm davanti al centro dei piedi, si muove in avanti a 4 cm/s” lo mantiene in piedi.
- Le parole del cervello impostano la risoluzione dei muscoli. Sotto “stai fermo”, il modello muscolare risponde a passi di circa il 15%. Sotto “mantieni la posizione con controllo fine”, i passi sono circa il 10%, e solo allora il corpo sopravvive a una spinta da davanti.
- I muscoli funzionano come i motoneuroni. Il modello muscolare risponde a passi grossolani. Alternare tra passi vicini da tick a tick, come una frequenza di scarica, fa durare le camminate circa il 50% in più.
- Camminare è caotico. Cambiare un guadagno di una parte su un milione cambia la durata di una camminata di un terzo. Una singola esecuzione non prova nulla, quindi ogni valore di camminata qui è una media su 12 o più camminate.
6 Cosa non funziona ancora
- Fermarsi. Un corpo che cammina e che viene messo in equilibrio in piedi cade entro un secondo: 0 su 20 tentativi sono rimasti in piedi. All'arrivo, il corpo si fonde in una posa in piedi. Questa è un'animazione, e la etichettiamo come tale.
- Alzarsi. Dopo una caduta, il corpo torna in piedi in un secondo. Anche questa è un'animazione.
- Altre velocità. Funziona solo la velocità alla quale il camminatore è stato tarato.
- Ulteriore messa a punto. Tre metodi di ricerca (evoluzione, CMA-ES e Augmented Random Search) non sono riusciti a migliorare il camminatore. Uno più robusto necessita di un controller per tutto il corpo, o di una policy addestrata con apprendimento per rinforzo su una GPU.
7 Perché ci abbiamo provato
Non ci siamo prefissati di costruire il miglior camminatore. L'apprendimento per rinforzo ne crea di migliori. Ci siamo prefissati di vedere se un tipo di modello può arrivare da “cosa faccio stasera” fino a “quale muscolo tira quanto forte”. Può farlo, con l'aiuto di poche righe di codice nel mezzo. Piccoli modelli aperti, ottimizzati su una CPU in pochi minuti, possono assumere la maggior parte degli strati.
Non sappiamo ancora a cosa serva. Forse persone in LifeSim che si muovono perché decidono di farlo, non perché un'animazione viene riprodotta. Forse a nulla. La tecnologia si sta muovendo troppo velocemente per dirlo, ed è questa la ragione per provare cose come questa ora, e per condividere ciò che troviamo.
8 Lavoro futuro
Il risultato più promettente è che le parole cambiano il corpo: “mantieni la posizione con controllo fine” ha dato ai muscoli una risoluzione più fine rispetto a “stai fermo”, e solo allora il corpo è sopravvissuto a una spinta frontale. Il prossimo esperimento è mostrare lo stesso corpo che risponde a parole diverse, come “cammina come se fossi stanco”, “preparati a una spinta” o “rilassati”. Un controller di codice non può prendere un'istruzione del genere. Un modello linguistico sì.
Riferimenti
- Zuo, C., He, K., Shao, J., Sui, Y. Self Model for Embodied Intelligence: Modeling Full-Body Human Musculoskeletal System and Locomotion Control with Hierarchical Low-Dimensional Representation. ICRA, 2024.
- Todorov, E., Erez, T., Tassa, Y. MuJoCo: A physics engine for model-based control. IROS, 2012.
- Gemma Team. Gemma 3 Technical Report. arXiv:2503.19786, 2025.
- Shao, Z., Wang, P., Zhu, Q., Xu, R., Song, J., et al. DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models. arXiv:2402.03300, 2024.
- Warner, B., Chaffin, A., Clavié, B., Weller, O., Hallström, O., et al. Smarter, Better, Faster, Longer: A Modern Bidirectional Encoder for Fast, Memory Efficient, and Long Context Finetuning and Inference. arXiv:2412.13663, 2024.
- Ross, S., Gordon, G. J., Bagnell, J. A. A Reduction of Imitation Learning and Structured Prediction to No-Regret Online Learning. AISTATS, 2011.
- Yin, K., Loken, K., van de Panne, M. SIMBICON: Simple Biped Locomotion Control. ACM SIGGRAPH, 2007.
Citazione
Come citare questo lavoro:
@misc{lifesim2026adamandeve,
  title  = {Adam & Eve: 700 LLM-Controlled Muscles via Fine-Tuned Decision Models},
  author = {{Cris Lenta}},
  year   = {2026},
  month  = {oct},
  url    = {https://lifesim.com/research/adam-and-eve}
}